Buenas prácticas de manejo de errores en n8n: tutorial paso a paso
Tutorial paso a paso de buenas prácticas de manejo de errores en n8n: crea y prueba un workflow de errores, limita reintentos y evita duplicados antes de producción.
Comprobado con las fuentes citadas el .
Requisitos previos y objetivo: qué significa un manejo de errores listo para producción
Las buenas prácticas de manejo de errores en n8n empiezan antes incluso de hacer clic en Publicar: necesitas una instancia de n8n funcionando, un workflow que quieras blindar y una comprensión básica de cómo los triggers y los nodos se pasan datos entre sí. No se necesita nada más para seguir los pasos de abajo.
El objetivo es concreto: configurar un workflow de errores dedicado, comprobar a propósito que realmente se activa, poner un límite a cuánto tiempo puede reintentar un paso inestable, e introducir alguna protección contra que la misma acción se ejecute dos veces, todo esto antes de que el workflow entre en producción y no después de que falle delante de un usuario real. La propia documentación de n8n describe un workflow de errores como el mecanismo para controlar cómo responde n8n cuando falla la ejecución de un workflow.
En nuestra opinión, saltarse esta configuración es el atajo más costoso que puede tomar un equipo al pasar un workflow de una demo al uso diario, porque los fallos que un workflow de errores habría capturado en silencio terminan apareciendo como un pedido perdido, un lead perdido o un ticket de soporte que nadie vio venir.
Sources: Handle errors gracefully | Build | n8n Docs
Pasos 1 a 4: buenas prácticas de manejo de errores en n8n para tu workflow de errores
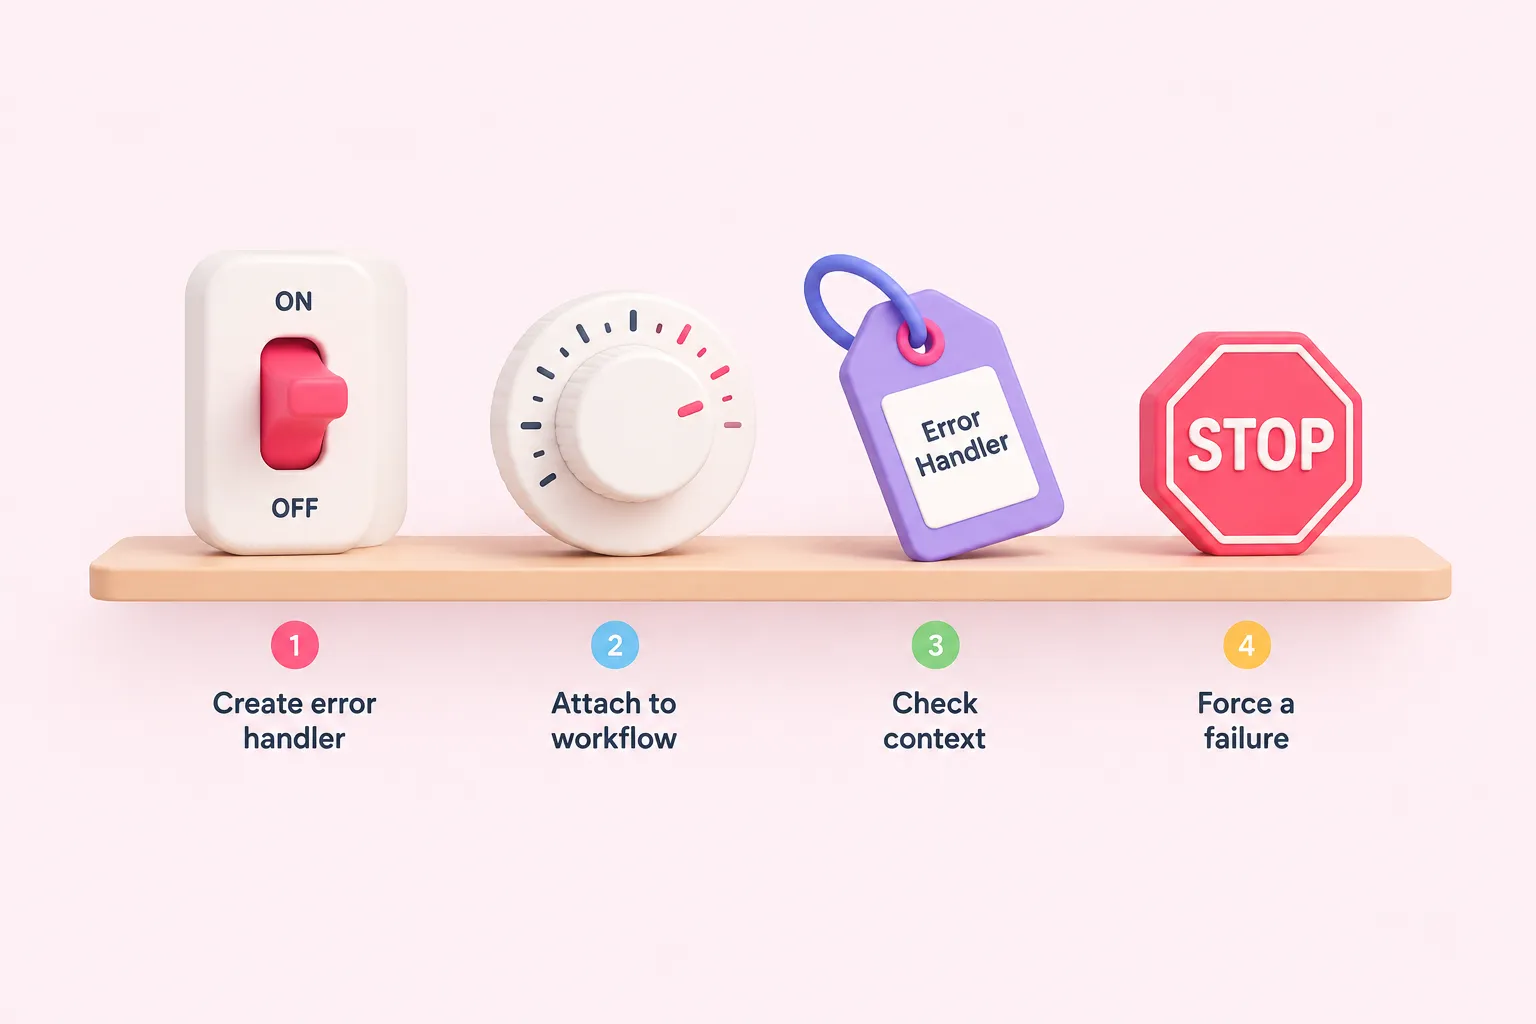
El paso 1 es crear un workflow Error Handler dedicado que empiece con el nodo Error Trigger, ya que la documentación de n8n indica que un workflow de errores debe comenzar con este nodo. La documentación también señala que un workflow que contiene un nodo Error Trigger se usa a sí mismo como workflow de errores por defecto. En nuestra opinión, vale la pena el esfuerzo extra de construir un único workflow Error Handler compartido para todo el equipo, porque depender de la autorreferencia por defecto de cada workflow dispersa la lógica de alertas entre todos los workflows en lugar de mantenerla en un solo lugar que realmente puedas gestionar.
El paso 2 es vincular ese Error Handler al workflow de producción que estás blindando, una de las buenas prácticas de manejo de errores en n8n más sencillas de aplicar desde el principio. La documentación describe cómo hacerlo desde Options, luego Settings, y configurando el campo Error workflow en el workflow que quieres proteger.
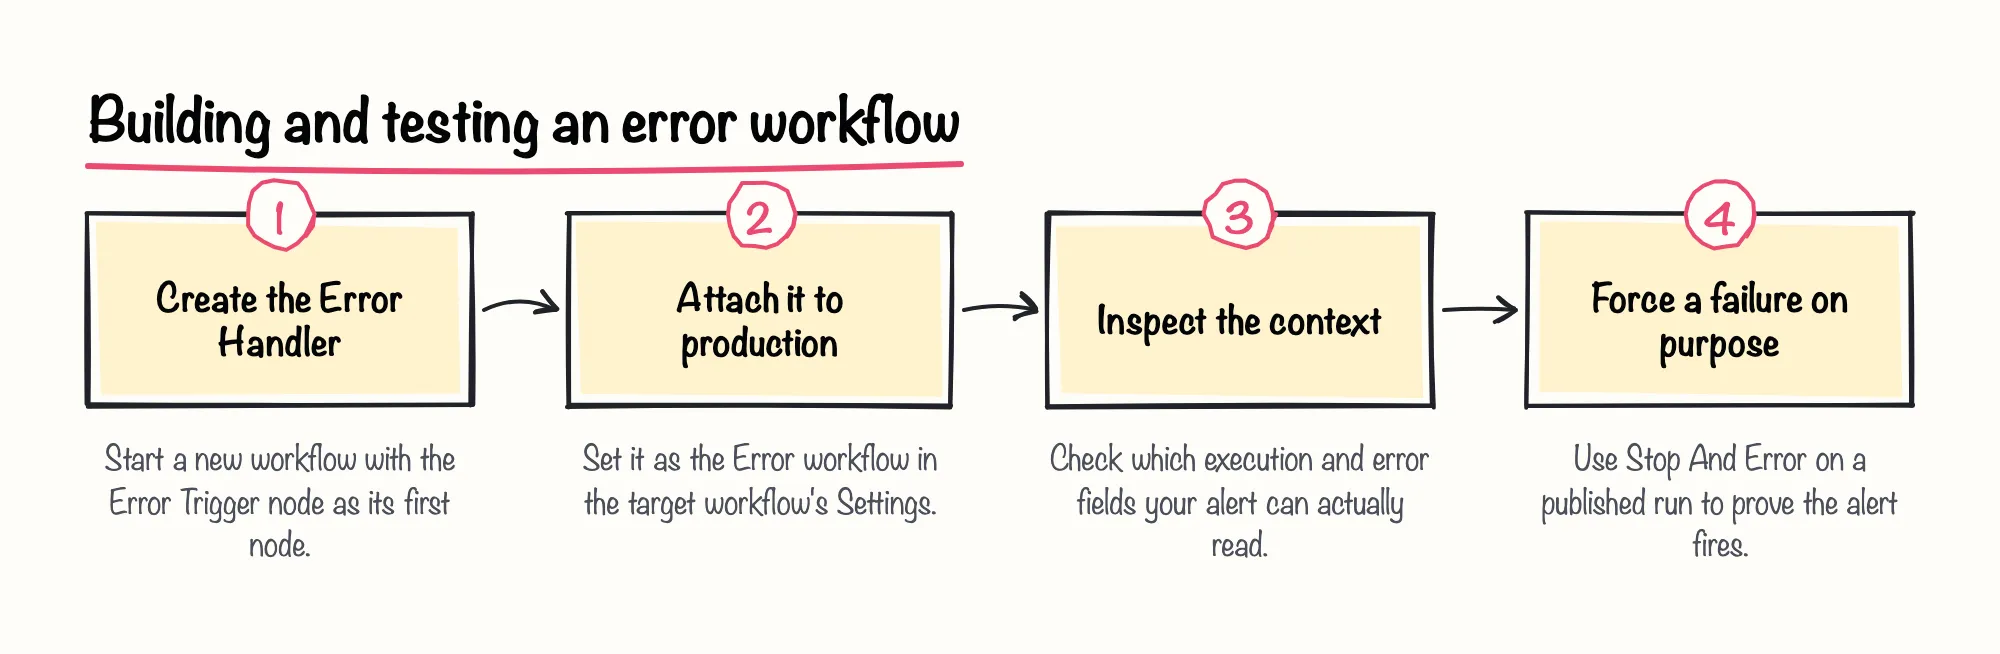
El paso 3 es examinar el contexto que realmente recibe una ejecución de Error Trigger, ya que tus alertas solo son tan útiles como los campos que leas de ellas. La documentación indica que execution.retryOf solo está presente cuando la ejecución es en sí misma un reintento de una ejecución fallida anterior, por lo que conviene confirmar en una ejecución de prueba si este campo se rellena en tus escenarios de fallo reales.
El paso 4 es forzar un fallo a propósito antes de confiar en el camino de la alerta. La documentación de n8n describe el nodo Stop And Error como una forma de mostrar un mensaje de error personalizado y hacer que una ejecución falle bajo las condiciones que elijas, ofreciendo dos operaciones para ello: Error Message y Error Object. Esto importa porque la documentación es explícita en que el Error Trigger no se ejecuta cuando un workflow se ejecuta manualmente desde el lienzo; solo se activa en ejecuciones automáticas y publicadas, así que una ejecución de prueba manual no te dirá nada sobre si tu alerta realmente funciona.
Contenido de formación independiente sobre n8n añade algunos matices aquí: la descripción de 2026 de un blog de formación comunitario sobre un video complementario dice que cubre los distintos modos de reacción ante errores disponibles en cada nodo, como stop, continue o continue using the error output. Se trata del propio resumen del autor del blog sobre un video, y no de un comportamiento documentado, así que conviene tratarlo como una pista a explorar y no como un conjunto de instrucciones verificado.
Sources: Handle errors gracefully | Build | n8n Docs, Error Trigger | Nodes | n8n Docs, Stop And Error | Nodes | n8n Docs, Error Handling in n8n #2 — HTTP Requests and Dedicated Error Workflows [E013], How to Handle Errors in n8n (Error Handling) #1 [E011]
Pasos 5 a 7: limita los reintentos, añade protección contra duplicados y confirma tu trigger
El paso 5 es poner un límite estricto a los reintentos para que una API inestable no pueda bloquear una ejecución indefinidamente. La documentación describe la opción After Time Interval del nodo Wait como una pausa de la ejecución durante un tiempo determinado, que se puede usar para construir una pausa de backoff antes de un reintento, y describe un resume time limit que permite que el workflow continúe automáticamente al alcanzar un límite concreto, lo que acota toda la secuencia. Limitar así los reintentos es una de las buenas prácticas de manejo de errores en n8n que vale la pena configurar antes de que un workflow dependa de una API externa inestable.
También señalan que, para tiempos de espera inferiores a 65 segundos, el workflow no descarga los datos de ejecución a la base de datos, lo que afecta a cómo se comportan en la práctica los retrasos de reintento cortos. Esta guía principal solo esboza el patrón; los artículos dedicados del grupo sobre el nodo Wait y sobre cómo ajustar el ritmo de los reintentos frente a límites de tasa explican el diseño del backoff paso a paso.
- Añade un nodo Wait con un límite de tiempo para que los reintentos no puedan bloquear una ejecución indefinidamente.
- Trata la protección contra acciones duplicadas como una comprobación independiente antes de producción, no como parte de la lógica de reintentos.
- Confirma que el workflow tiene un trigger no manual y está Publicado antes de contar cualquier ejecución como una prueba de producción.
El paso 6 es introducir la protección contra acciones duplicadas como una comprobación independiente antes de producción, separada de la lógica de reintentos. Nuestra opinión es que la protección contra duplicados merece su propia línea en la checklist en lugar de mezclarse con el manejo de reintentos, porque confundir ambas cosas es exactamente cómo una solicitud reintentada termina creando en silencio un segundo cargo o un segundo correo. El detalle de implementación más profundo, como las claves de idempotencia y las comprobaciones de deduplicación, se trata en los artículos dedicados de este grupo sobre webhooks idempotentes y sobre cómo evitar acciones duplicadas en una API.
El paso 7 es conocer la diferencia entre las ejecuciones manuales y las de producción antes de dar por bueno nada de esto. La documentación describe las ejecuciones manuales, activadas desde el lienzo, como una forma de probar la lógica del workflow de manera puntual, mientras que las ejecuciones de producción requieren un trigger no manual conectado y el workflow publicado con el botón Publish. También indica que las ejecuciones de producción ignoran cualquier dato fijado (pinned) durante las pruebas manuales, así que un caso de prueba fijado manualmente no se mantendrá una vez que el workflow esté en producción.
Sources: Wait | Nodes | n8n Docs, Types of executions | Build | n8n Docs
Resultados esperados y solución de problemas comunes
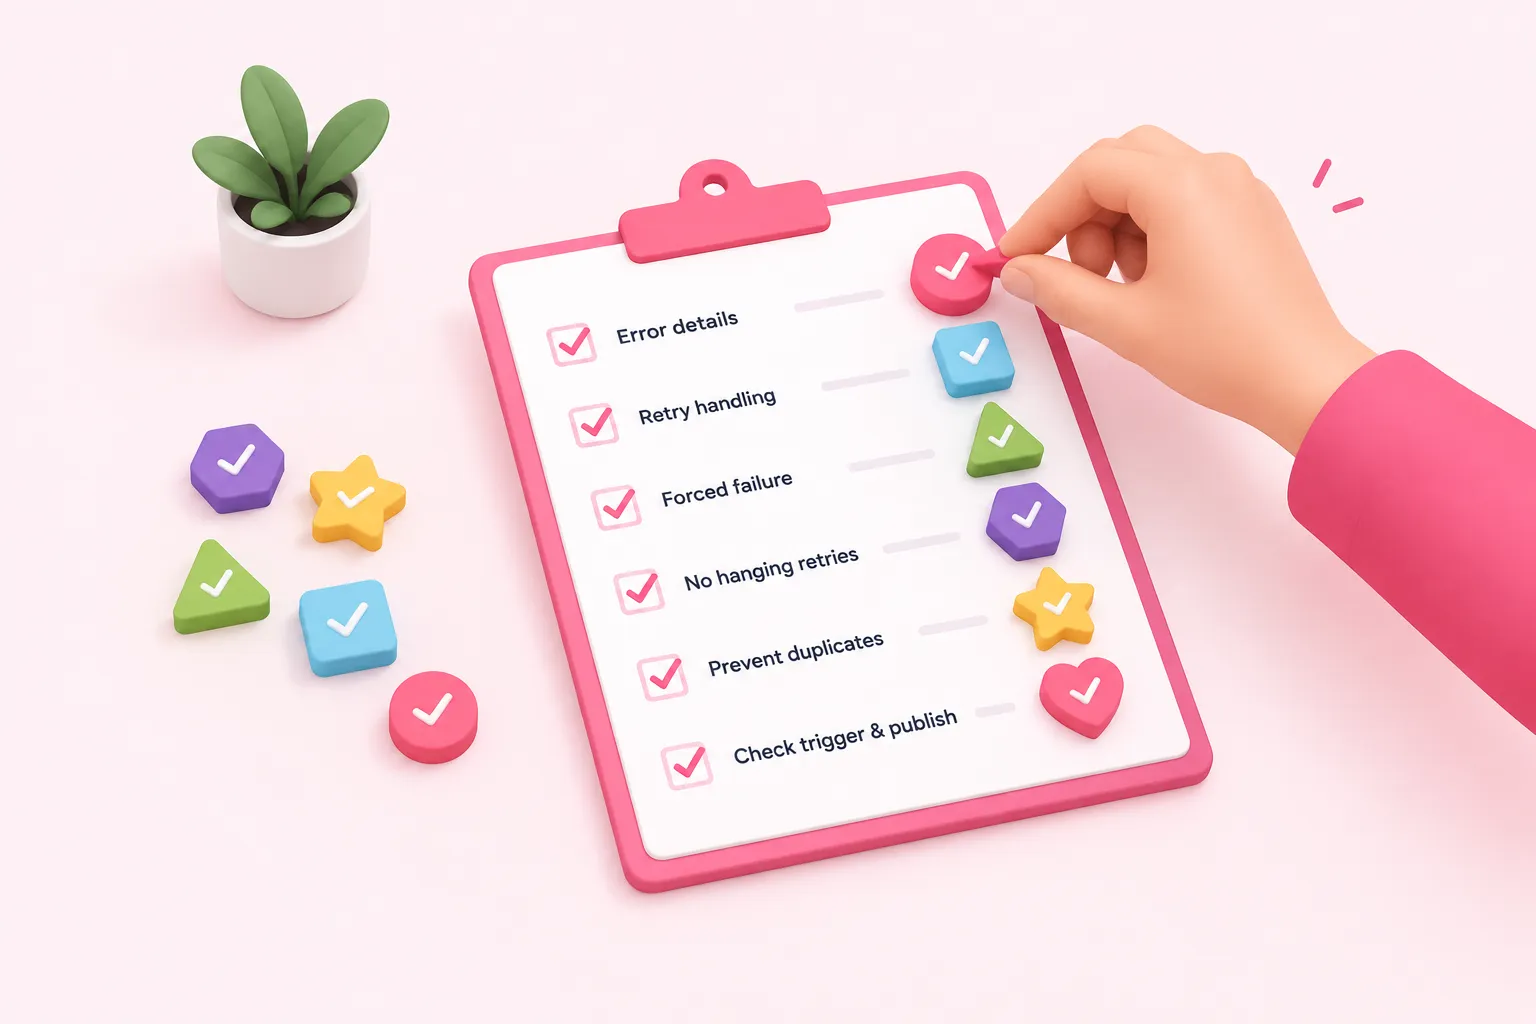
Una vez que esto está en marcha, una ejecución publicada que falle debería llegar a tu workflow Error Handler con el id de ejecución, la URL, el mensaje de error y un campo retryOf siempre que la ejecución sea en sí misma un reintento. Un fallo forzado con Stop And Error debería producir la misma alerta que uno real, tu secuencia de reintentos más larga debería terminar por sí sola en lugar de quedarse colgada, y una acción repetida debería detectarse antes de que duplique un efecto secundario.
Cuando algo no cuadra, empieza por el trigger y el estado de publicación, ya que es la brecha más habitual: la documentación enumera un mensaje de error específico para una ejecución parcial intentada sin un nodo de trigger conectado, lo que es una señal útil de que el workflow no está conectado como esperas. Si el Error Trigger nunca se activa durante las pruebas, revisa la distinción entre manual y publicado que se trató en el paso 4 anterior.
Sources: Handle errors gracefully | Build | n8n Docs, Error Trigger | Nodes | n8n Docs, Stop And Error | Nodes | n8n Docs, Types of executions | Build | n8n Docs
Dónde profundizar más dentro de este grupo de temas
Esta guía está pensada como punto de entrada a un conjunto más amplio de cuestiones de fiabilidad. Una vez que el workflow de errores básico y los reintentos acotados están en marcha, probablemente querrás profundizar en cómo ajustar el ritmo de las solicitudes frente a una API con límite de tasa, en separar la lógica de recuperación del camino de éxito cuando falla una solicitud HTTP, en guardar una clave estable para que la entrega de un webhook nunca se procese dos veces incluso con reintentos concurrentes, y en el patrón de marcar una acción downstream como entregada solo cuando realmente se ha confirmado. Cada una de estas es un ejercicio práctico propio construido sobre la base que se ha tratado aquí.