Reintentar de forma segura solicitudes HTTP fallidas en n8n
Guía práctica para inspeccionar solicitudes fallidas, separar la lógica de recuperación, limitar los reintentos, espaciar el tráfico sujeto a límites de frecuencia y filtrar entradas duplicadas antes de que una llamada a una API pueda generar efectos secundarios.
Comprobado con la documentación de n8n el .
Empieza por las evidencias de la ejecución fallida
Un reintento seguro comienza con una inspección, no con una repetición inmediata. Abre la ejecución fallida, localiza el nodo HTTP Request y conserva la entrada que provocó el fallo. n8n permite revisar las ejecuciones por estado y reintentar manualmente una ejecución fallida utilizando el flujo de trabajo guardado actualmente o el flujo de trabajo original. Esta elección importa si has editado el flujo de trabajo desde que ocurrió el fallo: decide si quieres reproducir el comportamiento anterior o probar una corrección.
Configura el paso de solicitud para que devuelva la respuesta completa cuando esa información esté disponible. El código de estado y los encabezados de la respuesta, junto con el cuerpo y cualquier mensaje del servicio, te proporcionan evidencias para determinar qué ocurrió. Registra también el contexto de la solicitud: la operación que se intentaba realizar, el destino y un identificador seguro del elemento afectado. Evita incluir secretos o cargas útiles sensibles en los campos de diagnóstico.
El reintento manual resulta útil para investigar, pero no constituye una política de recuperación completa. Como recomendación editorial prudente, consulta la documentación de la API de destino y verifica el estado externo antes de repetir una operación que cree, actualice, envíe o cobre algo.
Clasifica los fallos antes de decidir si reintentar
Considera la posibilidad de reintentar como una decisión basada en la documentación de la API de destino y en las evidencias devueltas por la solicitud. Una respuesta por límite de frecuencia puede ser temporal, mientras que un problema de autenticación o validación puede requerir corregir una credencial o carga útil. Estas categorías son ilustrativas, no reglas universales: cada servicio define sus propios códigos de estado, cuerpos de error, semántica de las solicitudes y límites.
Una clasificación sugerida y útil es: fallos temporales, permanentes e inciertos. Los fallos temporales pueden entrar en una ruta de reintentos limitados cuando el servicio lo permita. Los fallos permanentes deben abandonar la ruta de reintentos y generar un registro claro para su corrección. Los fallos inciertos requieren especial cautela cuando la solicitud puede producir un efecto secundario externo, porque repetirla puede repetir la acción.
No crees una regla que reintente todas las respuestas no satisfactorias. Define explícitamente las condiciones permitidas y conserva una salida alternativa deliberada para todos los demás casos. Los datos completos de la respuesta pueden ayudar con esta clasificación, pero la documentación disponible no establece un conjunto universal de errores o métodos HTTP que sea seguro reintentar.
Separa la recuperación de la ruta de éxito
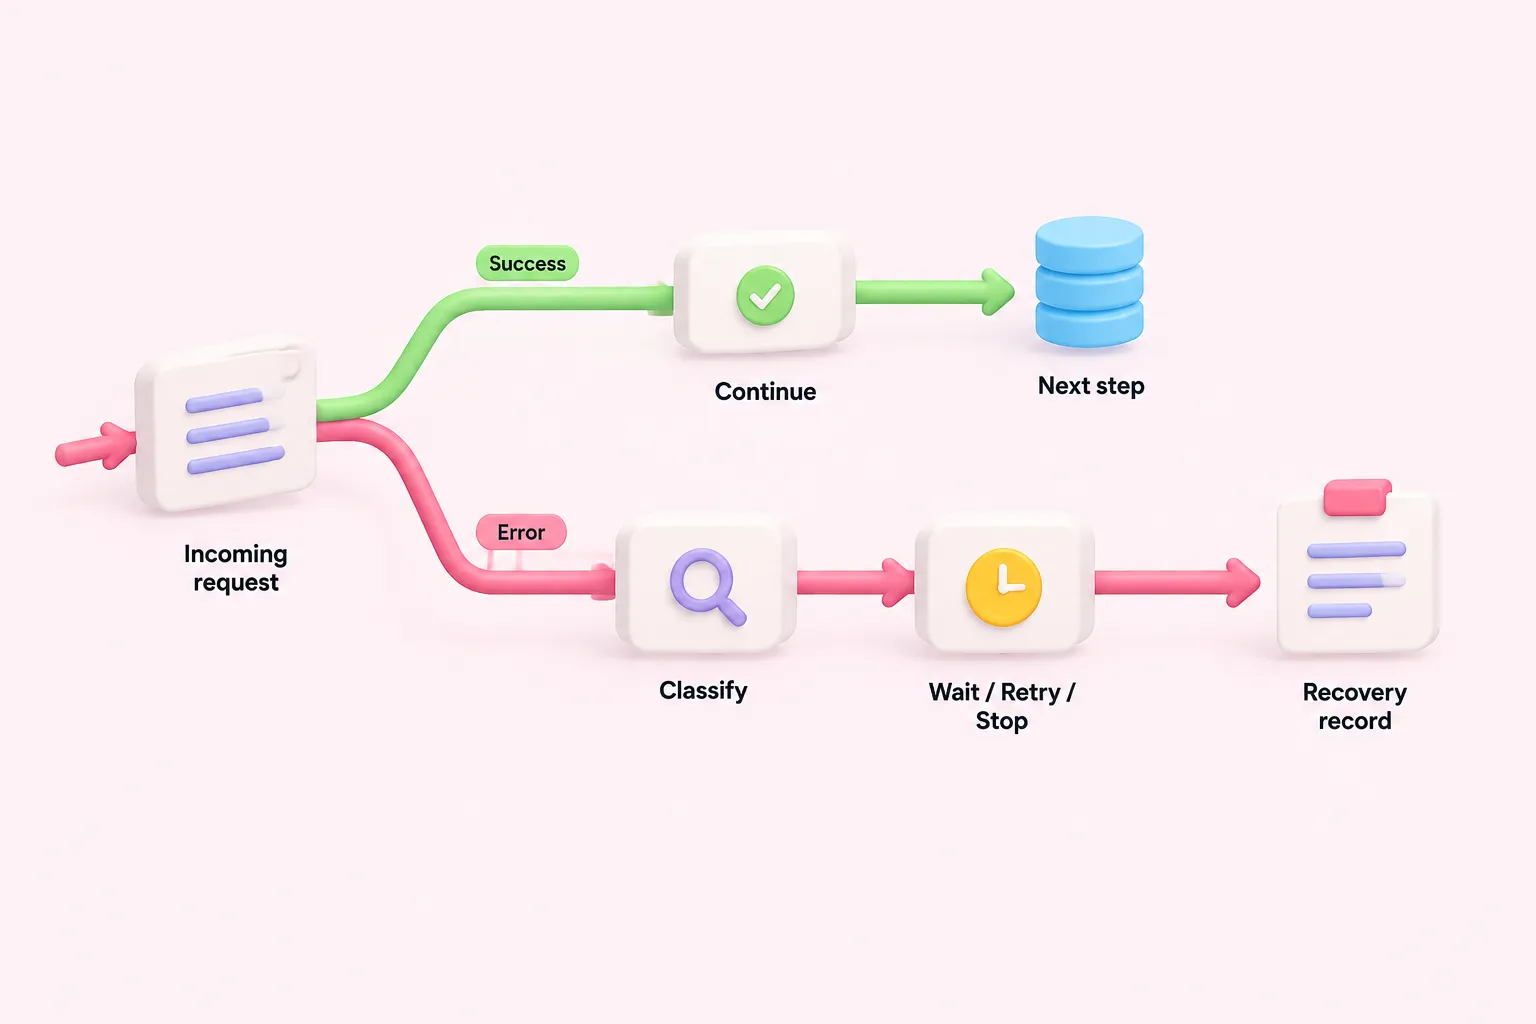
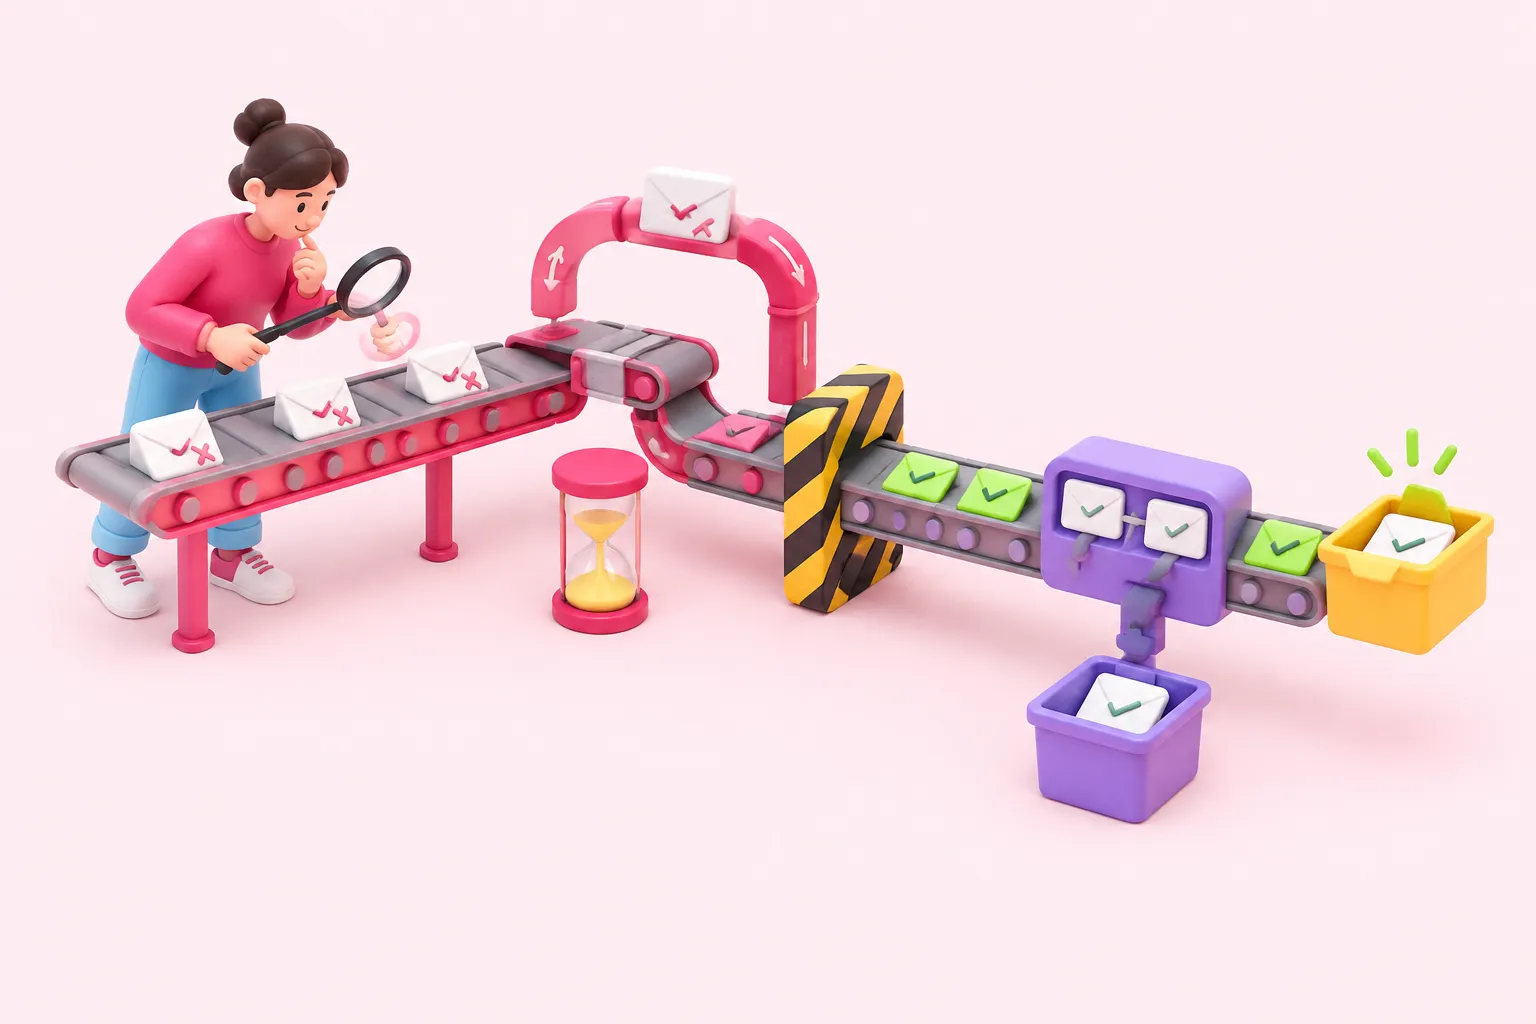
Mantén el procesamiento normal fácil de seguir dirigiendo los fallos hacia una lógica de recuperación aislada. Un nodo puede continuar a través de una salida de error específica y transmitir la información del error a los pasos posteriores. Esa rama puede normalizar y clasificar el error, registrar contexto útil y decidir si el elemento debe esperar, reintentarse o detenerse.
Utiliza esta rama local cuando la decisión corresponda a una solicitud o un elemento concretos. Para gestionar fallos más amplios en el ámbito del flujo de trabajo, n8n también admite flujos de trabajo de errores reutilizables que comienzan con un Error Trigger y pueden atender a varios flujos de trabajo. Un flujo de este tipo puede centralizar la gestión de fallos, pero la documentación suministrada no establece que sea el mecanismo adecuado para todos los casos de recuperación HTTP en el ámbito de cada elemento.
Un registro de recuperación sugerido podría contener un identificador seguro del elemento, una categoría de error, el número de intento y la acción siguiente. Se trata de un marco editorial, no de un esquema validado. Su propósito es hacer visibles las decisiones sin mezclar los nodos de gestión de fallos con la ruta principal de éxito.
Limita y espacia los reintentos ante límites de frecuencia
n8n documenta dos enfoques pertinentes para los límites de frecuencia: activar Retry On Fail o espaciar el trabajo con Loop Over Items y Wait. Elige la demora de acuerdo con el límite publicado por el servicio de destino. Para una colección más grande, espaciar deliberadamente las solicitudes puede resultar más claro que alcanzar el límite repetidamente y tratar los fallos como mecanismo de control del tráfico.
Establece un número máximo de intentos como decisión explícita de diseño. La documentación suministrada no proporciona un máximo universal, una fórmula de retroceso exponencial, una regla de jitter ni una política para los encabezados Retry-After, por lo que los valores deben proceder de las indicaciones de la API de destino y de la tolerancia al riesgo de tu flujo de trabajo. Cuando se alcance el límite, dirige el elemento hacia un resultado visible de reintentos agotados en lugar de permitir un bucle indefinido.
Conserva el identificador de negocio original e incrementa un contador de intentos a través de la rama de recuperación. Antes de cada nuevo intento, confirma que el error todavía cumple los requisitos y que repetir la operación sigue siendo aceptable. Los controles de reintento reducen las repeticiones descontroladas, pero por sí solos no pueden determinar que una llamada con efectos secundarios sea segura.
Sources: S6
Elimina duplicados antes de solicitudes con efectos secundarios
Coloca el filtro de duplicados antes de una solicitud HTTP que pueda crear o modificar un registro externo. El nodo Remove Duplicates puede comparar un campo de entrada único, o una combinación de campos, y filtrar valores ya vistos en ejecuciones anteriores. Prefiere un identificador de negocio estable frente a un valor que cambie en cada ejecución.
Elige cuidadosamente el ámbito de comparación porque el historial de deduplicación es limitado y configurable. Una clave sugerida podría combinar el identificador de un registro de origen con la operación prevista, siempre que esa combinación represente una única acción lógica en tu propio proceso. Se trata de una sugerencia de diseño, no de una clave validada universalmente.
La deduplicación de entradas es una protección frente al procesamiento repetido, no una garantía de entrega exactamente una vez. No demuestra que un servicio externo haya evitado un efecto secundario repetido. Cuando una API proporcione su propio mecanismo de idempotencia, evalúalo mediante la documentación de esa API en lugar de asumir que el filtrado en n8n lo sustituye.
Sources: S8
Prueba el éxito, el agotamiento y los duplicados
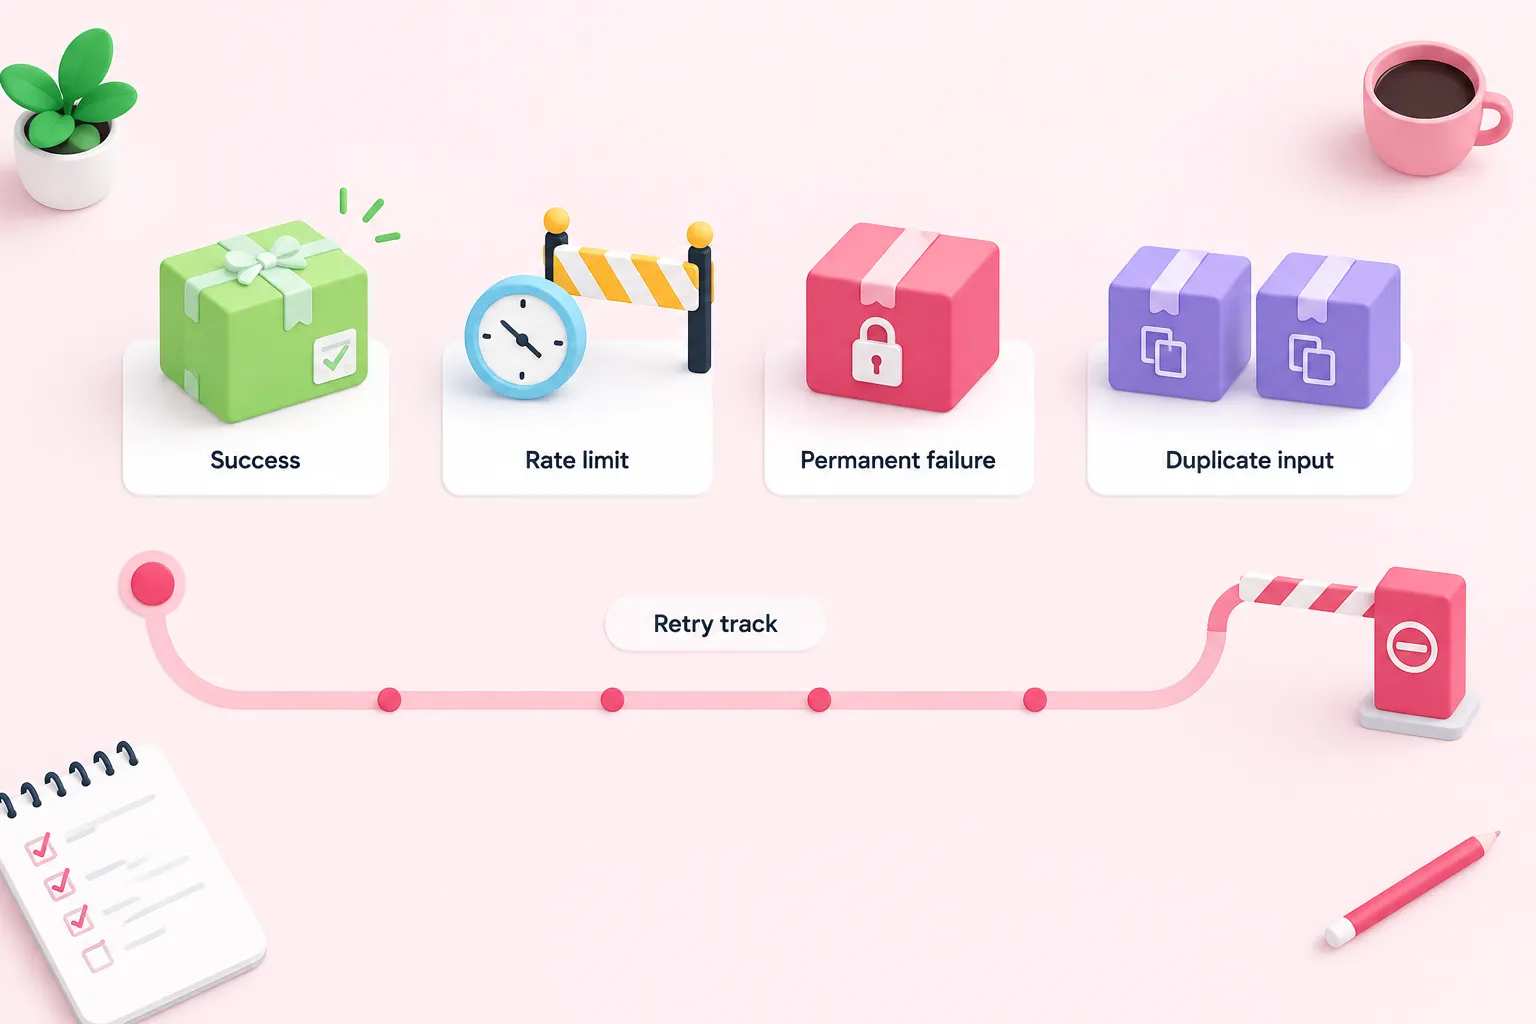
Prueba el diseño de recuperación antes de depender de él. Un conjunto de pruebas sugerido incluye una respuesta satisfactoria, una respuesta simulada por límite de frecuencia, un fallo permanente y la misma entrada lógica enviada dos veces. Estos escenarios son sugerencias editoriales prácticas, no un instrumento de pruebas validado.
Para cada escenario, inspecciona tanto la ruta de ejecución como el efecto externo final. Confirma que el éxito evite la rama de error, que un fallo temporal apto para reintento solo siga el número permitido de intentos, que un fallo permanente no entre en un bucle de reintentos automáticos y que el agotamiento de los reintentos llegue a un punto de detención visible. Para una entrada duplicada, verifica qué hace el nodo de filtrado dentro del ámbito que configuraste.
El reintento manual merece su propia prueba. Compara el reintento con el flujo de trabajo guardado frente al reintento con el flujo de trabajo original para entender qué versión se está ejecutando. Termina revisando los registros y el contexto de error almacenado para detectar información sensible. El objetivo es un flujo de trabajo cuyas decisiones puedan inspeccionarse, reproducirse y corregirse sin insinuar que los reintentos o la deduplicación garanticen la entrega.
Practica el patrón de recuperación completo
Crea un pequeño flujo de trabajo de práctica que reciba elementos de muestra, filtre identificadores repetidos, llame a un endpoint HTTP y dirija los errores de solicitud hacia una rama de recuperación separada. Añade una condición explícita de detención y un resultado visible para los reintentos agotados. Después, ejecuta los escenarios sugeridos uno por uno e inspecciona cómo cambian los datos en cada nodo.
Mantén el ejercicio centrado en el patrón y no en un número de reintentos concreto. Los errores, las demoras, los métodos de solicitud y las protecciones externas de idempotencia apropiados dependen de la API utilizada. Considera la documentación de cada servicio como la autoridad para tomar esas decisiones.