Cómo evitar acciones de API duplicadas en webhooks de n8n
Aprende a diseñar un flujo de trabajo de webhook en n8n que utilice un ID de entrega estable, un registro persistente y una reclamación atómica en la base de datos para evitar efectos secundarios repetidos durante reintentos y entregas simultáneas.
Comprobado con las fuentes citadas el .
Por qué pueden repetirse las entregas de webhooks
Un webhook es un mecanismo de entrega, no una promesa de que un evento llegará exactamente una vez. Un proveedor puede volver a enviar el mismo evento después de que se agote el tiempo de espera o como parte de su proceso de reintentos. Incluso es posible que la primera ejecución del flujo de trabajo haya completado la acción de API prevista, pero que su respuesta no llegara al proveedor. Desde la perspectiva del proveedor, reintentarlo puede seguir siendo razonable; desde la perspectiva de tu flujo de trabajo, repetir la acción podría crear un segundo ticket, una solicitud de pago, un mensaje o un registro en la base de datos.
Por tanto, el supuesto de diseño seguro es que cualquier entrega puede repetirse. El flujo de trabajo debe reconocer si ya ha aceptado una entrega concreta antes de llegar a una acción irreversible. Esta propiedad suele denominarse idempotencia: procesar la misma entrega más de una vez no debería multiplicar el efecto previsto.
La gestión de duplicados es especialmente importante cuando dos copias llegan casi al mismo tiempo. Una consulta seguida de una inserción puede parecer correcta en pruebas secuenciales, pero fallar con concurrencia. Ambas ejecuciones pueden realizar la consulta antes de que cualquiera inserte un registro, concluir que la entrega es nueva y activar después la acción protegida.
Elige y valida un ID de entrega estable
Empieza por identificar el identificador de entrega documentado por el proveedor del webhook. Debe representar la entrega de forma coherente durante el comportamiento de reintento que necesites gestionar. Por ejemplo, GitHub documenta que su cabecera de entrega permanece igual cuando una entrega se vuelve a enviar deliberadamente. Esto hace que la cabecera sea adecuada como clave de idempotencia en ese contexto específico, pero debes confirmar la garantía equivalente en la documentación de cualquier otro proveedor.
Extrae el identificador inmediatamente después de autenticar y validar la solicitud. Trata un identificador ausente, vacío o malformado como un error, en lugar de construir un sustituto a partir de campos mutables de la carga útil. Un hash de determinados valores de la carga útil podría combinar accidentalmente eventos distintos o considerar que representaciones modificadas de un mismo evento son entregas diferentes.
Si un flujo de trabajo recibe eventos de varios proveedores, utiliza una identidad compuesta, como el proveedor más el ID de entrega. También puedes incluir un identificador de cuenta o endpoint cuando el proveedor solo garantice la unicidad dentro de ese ámbito. Guarda el ID de entrega original para poder investigarlo, pero no confíes en un identificador más allá del ámbito documentado por su proveedor.
Sources: S5
Conserva los ID de entrega entre ejecuciones de n8n
El registro de entregas aceptadas debe persistir más allá de una sola ejecución del flujo de trabajo. El nodo Remove Duplicates de n8n puede comparar los elementos entrantes con los datos conservados de ejecuciones anteriores, lo que lo hace útil para aprender el patrón básico de deduplicación. Sin embargo, su historial almacenado es limitado y configurable, y la documentación proporcionada no establece una protección transaccional entre ejecuciones simultáneas. Úsalo para explorar entradas repetidas, no como prueba de una garantía de concurrencia.
Las Data Tables de n8n ofrecen otra opción persistente. Pueden conservar información estructurada entre flujos de trabajo y admiten consultas condicionales, inserción de filas y operaciones upsert. Un registro de entrega útil podría contener el proveedor, el ID de entrega, el tipo de evento, la hora de recepción, el estado de procesamiento y el identificador del registro externo resultante. Estos campos crean un historial de auditoría para la depuración.
La documentación proporcionada sobre Data Tables no establece compatibilidad con una invariante de unicidad atómica cuando hay escritores simultáneos. Si impedir que dos ejecuciones simultáneas reclamen la misma entrega es un requisito estricto, utiliza un almacenamiento cuyas restricciones de base de datos y cuyo comportamiento ante conflictos estén documentados como garantía. Define la retención según la ventana de reintento o reproducción documentada por el proveedor, en lugar de asumir una duración universal.
Haz que la escritura protegida sea atómica
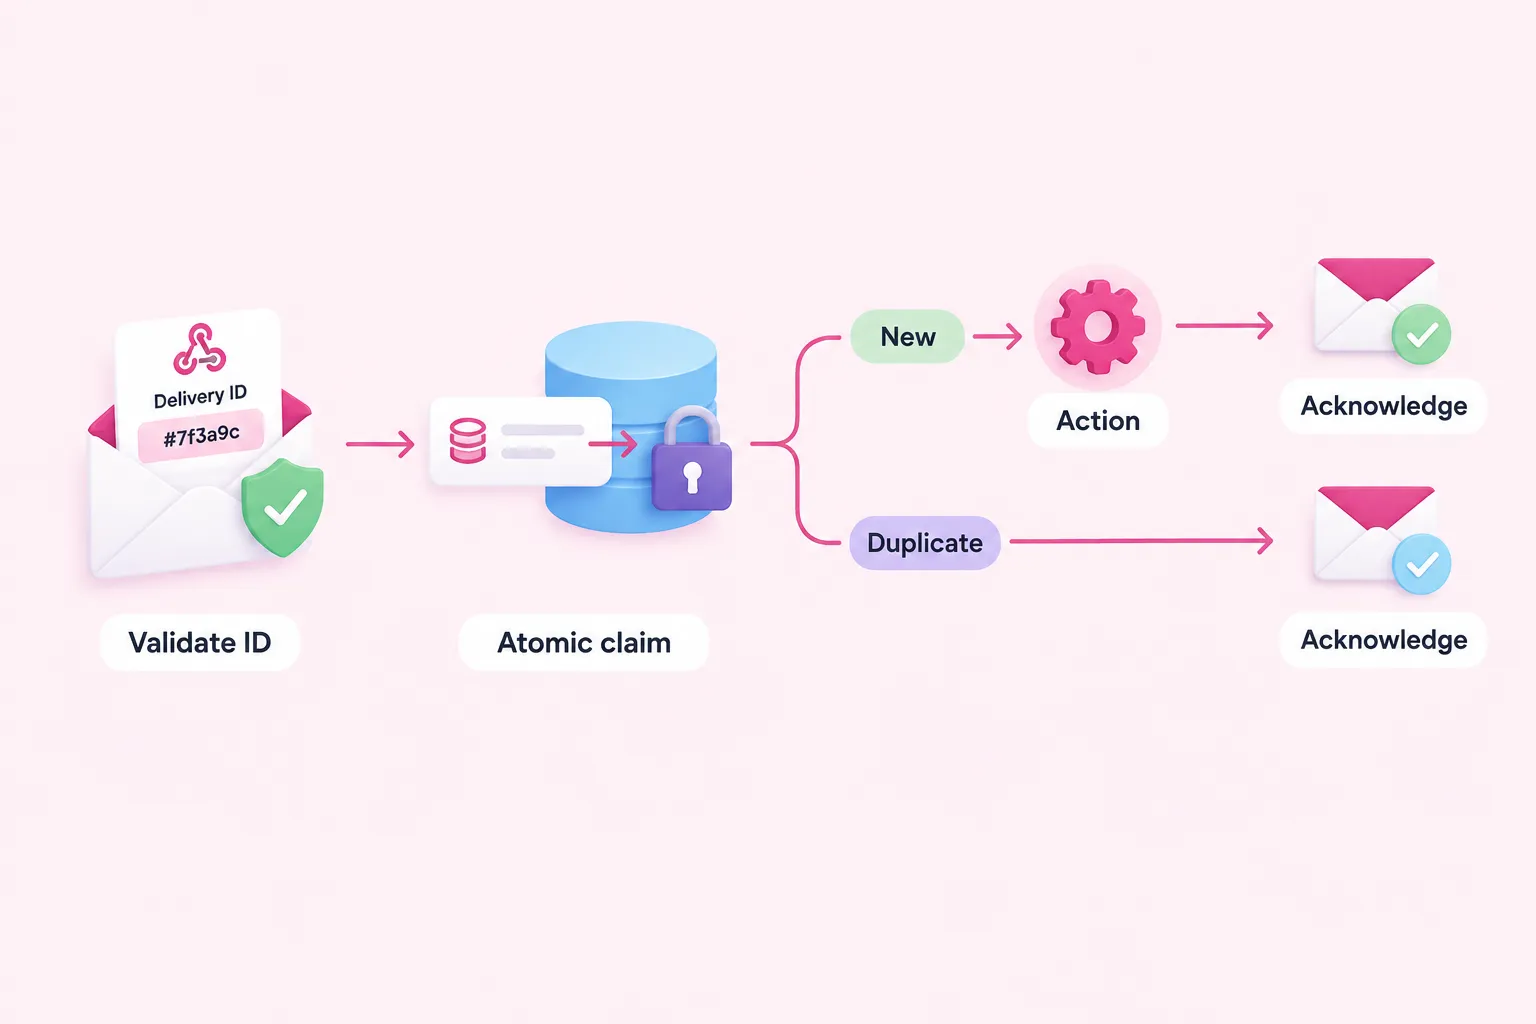
En PostgreSQL, define la identidad de entrega como NOT NULL y protégela con una restricción de unicidad. Una restricción de unicidad garantiza que dos filas no puedan contener el mismo valor protegido. Si la unicidad depende de más de un campo, aplica la restricción a la identidad completa, como el proveedor y el ID de entrega.
Reclama la entrega con una sola operación INSERT que gestione los conflictos de unicidad. No construyas la ruta crítica como «buscar el ID y después insertarlo si no existe», porque son operaciones separadas con una condición de carrera entre ellas. El comportamiento ON CONFLICT de PostgreSQL puede resolver inserciones competidoras de forma atómica cuando está respaldado por una restricción de unicidad o un índice único aplicable. Aun así, pueden producirse errores independientes de la base de datos, que deben seguir una ruta de fallo distinta.
El flujo de trabajo debe bifurcarse según el resultado de esta reclamación atómica. La ejecución que insertó el nuevo registro de entrega obtiene el derecho a continuar. Una ejecución que encontró la clave existente reconoce un duplicado y omite la acción protegida. Sitúa la creación de tickets, los mensajes salientes, las llamadas relacionadas con pagos y otras operaciones irreversibles únicamente después de establecer la propiedad.
Este patrón garantiza una sola fila de seguimiento para la clave protegida bajo las condiciones documentadas de la base de datos. No hace automáticamente que una solicitud posterior a una API externa sea transaccional con la inserción en la base de datos. Diseña campos de estado y procedimientos de recuperación para los casos en los que la reclamación tenga éxito, pero falle una solicitud posterior.
Devuelve una respuesta satisfactoria para los duplicados reconocidos
Un duplicado reconocido suele ser una entrega ya aceptada, no un nuevo fallo de procesamiento. Después de que la inserción atómica indique un conflicto, dirige la ejecución de modo que evite el efecto secundario y devuelve una confirmación satisfactoria cuando esto concuerde con el protocolo de entrega documentado por el proveedor. Para los proveedores que reintentan las respuestas fallidas, esto evita indicar que un trabajo ya aceptado debe volver a entregarse.
Mantén separados los fallos reales. Una base de datos no disponible, un identificador de entrega no válido o un fallo de autenticación no deben notificarse como si fueran duplicados inofensivos. Registra suficiente contexto para distinguir entre una reclamación nueva, un duplicado conocido y un error operativo, sin almacenar secretos innecesariamente.
Decide explícitamente cuándo una entrega pasa a considerarse «aceptada». Reclamarla antes de la acción externa impide que dos ejecuciones simultáneas realicen esa acción, pero un fallo posterior a la reclamación exige una política de recuperación. Entre los enfoques sugeridos están registrar un estado de procesamiento para revisarlo más adelante o implementar una ruta de reintento cuidadosamente controlada que siga respetando la clave de entrega original. Son sugerencias de diseño, no una transacción completa que abarque un servicio externo.
Prueba los reintentos y las entregas simultáneas
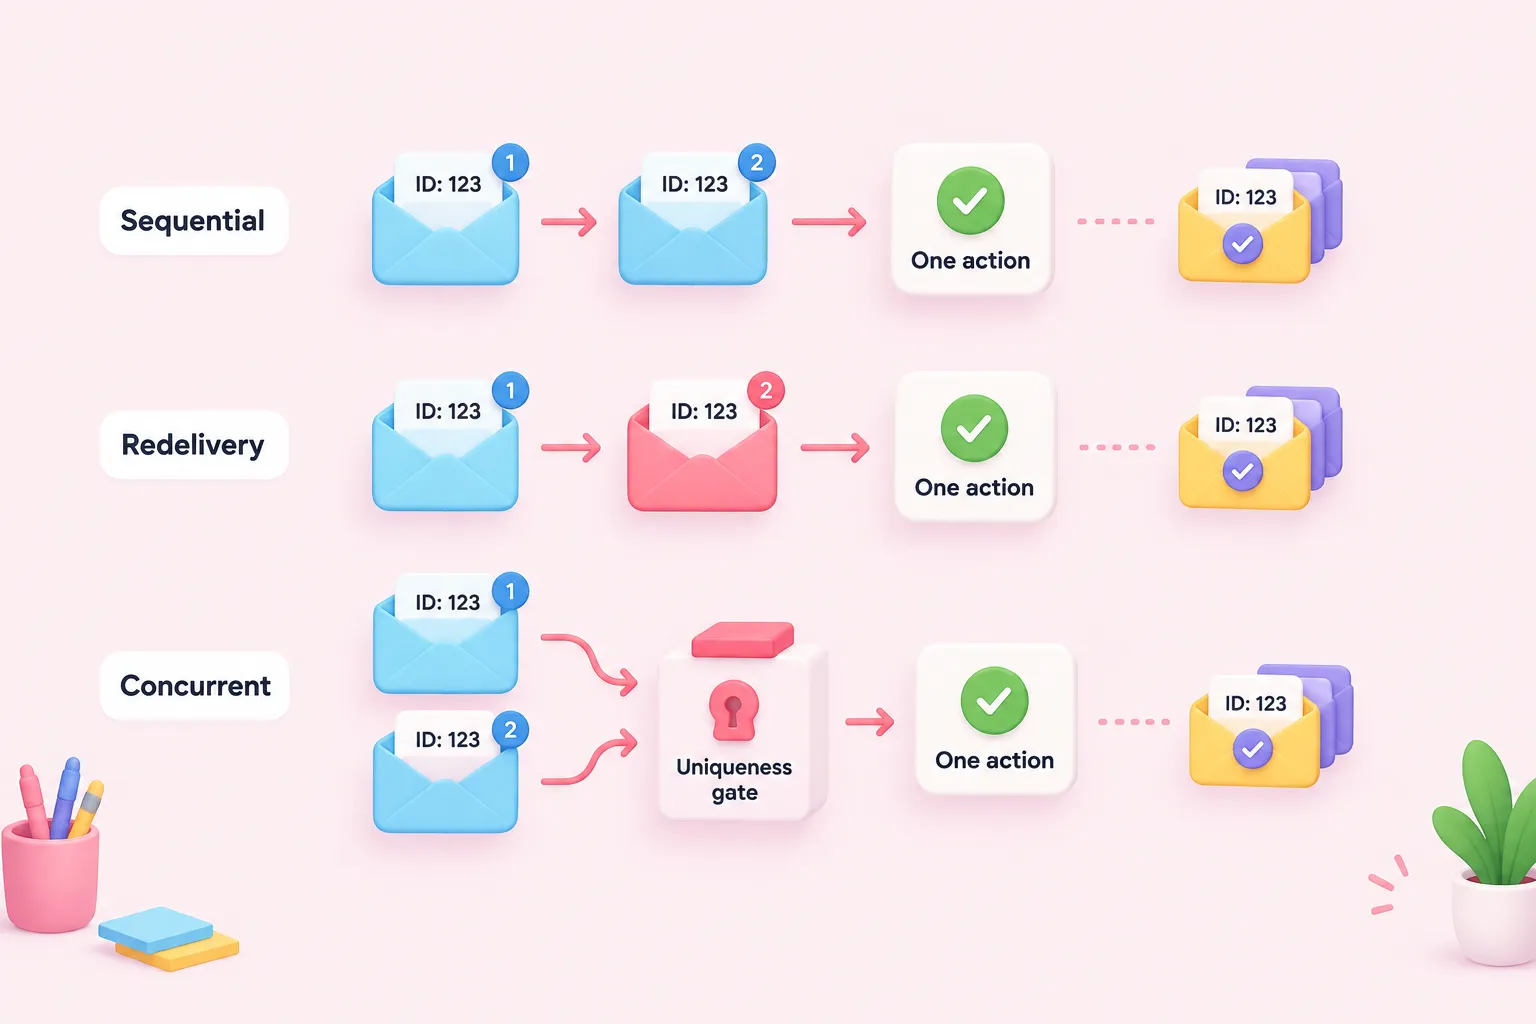
Prueba la invariante en tu propio entorno de n8n antes de conectar el flujo de trabajo a una API con consecuencias importantes. Como secuencia de prueba sugerida, envía primero la misma entrega dos veces de manera sucesiva. La primera solicitud debería reclamar la clave y llegar al paso protegido; la segunda debería seguir la rama de duplicados y aun así recibir una confirmación satisfactoria.
Después, simula un reenvío propio del proveedor enviando de nuevo un ID estable idéntico. Confirma que cambiar detalles irrelevantes de la solicitud no permite eludir la clave. Por último, inicia dos solicitudes con el mismo ID tan cerca en el tiempo como sea posible. Inspecciona la base de datos y el sistema externo, no solo la rama visible del flujo de trabajo, y verifica que haya un registro de reclamación y una acción protegida.
Añade también pruebas de fallos. Prueba con un ID ausente, uno malformado, una base de datos no disponible y un fallo de la API posterior a una reclamación satisfactoria. Estas comprobaciones sugeridas no son un instrumento de prueba validado, pero revelan los límites entre la validación de solicitudes, la propiedad atómica, la confirmación de duplicados y la recuperación. También hacen más concreta la depuración del flujo de trabajo, porque cada resultado corresponde a una transición de estado deliberada.
Practica el patrón en n8n
Un flujo de trabajo práctico de aprendizaje puede comenzar con un nodo Webhook, seguido de la autenticación de la solicitud y la extracción del ID de entrega documentado por el proveedor. El paso siguiente intenta realizar la reclamación atómica en la base de datos. Una inserción satisfactoria continúa hacia una acción de práctica inofensiva, mientras que un conflicto de unicidad conduce directamente a una respuesta satisfactoria para el duplicado. Los errores operativos de la base de datos siguen una ruta de error en lugar de confundirse con duplicados.
Construye la primera versión con un registro de auditoría visible y un efecto secundario reversible. Después, reproduce la misma solicitud, inspecciona los datos de ejecución y ejecuta la prueba simultánea. Cuando las ramas se comporten según lo previsto, documenta el ámbito específico del proveedor para el identificador, la regla de retención y el procedimiento de recuperación de una primera ejecución interrumpida.
La disposición de nodos descrita aquí es una orientación editorial de implementación basada en los comportamientos proporcionados de los componentes; no es un flujo de trabajo de referencia integral documentado ni una prueba de resultados de aprendizaje medidos. La lección central es sencilla: el historial persistente puede identificar trabajo anterior, pero evitar acciones duplicadas simultáneas exige una reclamación atómica impuesta por la capa de almacenamiento.