n8n Error Handling Best Practices: покроковий посібник
Покроковий посібник з обробки помилок у n8n: створіть error workflow, протестуйте його, обмежте повтори й додайте захист від дублікатів перед продакшеном.
Перевірено за наведеними джерелами .
Передумови та мета: що означає обробка помилок, готова до продакшену
Хороші найкращі практики обробки помилок у n8n починаються ще до того, як ви натиснете Publish: вам потрібен робочий інстанс n8n, workflow, який ви плануєте зробити надійнішим, і базове розуміння того, як тригери та ноди передають дані між собою. Для виконання наведених нижче кроків більше нічого не потрібно.
Мета конкретна: налаштувати окремий error workflow, навмисно довести, що він справді спрацьовує, встановити межу того, скільки разів нестабільний крок може повторюватися, і впровадити захист від повторного виконання однієї й тієї ж дії — все це до того, як workflow піде в роботу, а не після того, як він зламається на очах у реального користувача. Офіційна документація n8n описує error workflow як механізм керування тим, як n8n реагує на збій виконання workflow.
На нашу думку, пропуск цього налаштування — це найдорожче спрощення, яке допускає команда під час переходу workflow від демо до щоденного використання, адже збої, які тихо перехопив би error workflow, натомість проявляються як пропущене замовлення, втрачений лід або тікет підтримки, якого ніхто не очікував.
Sources: Handle errors gracefully | Build | n8n Docs
Кроки 1–4: найкращі практики обробки помилок у n8n для вашого error workflow
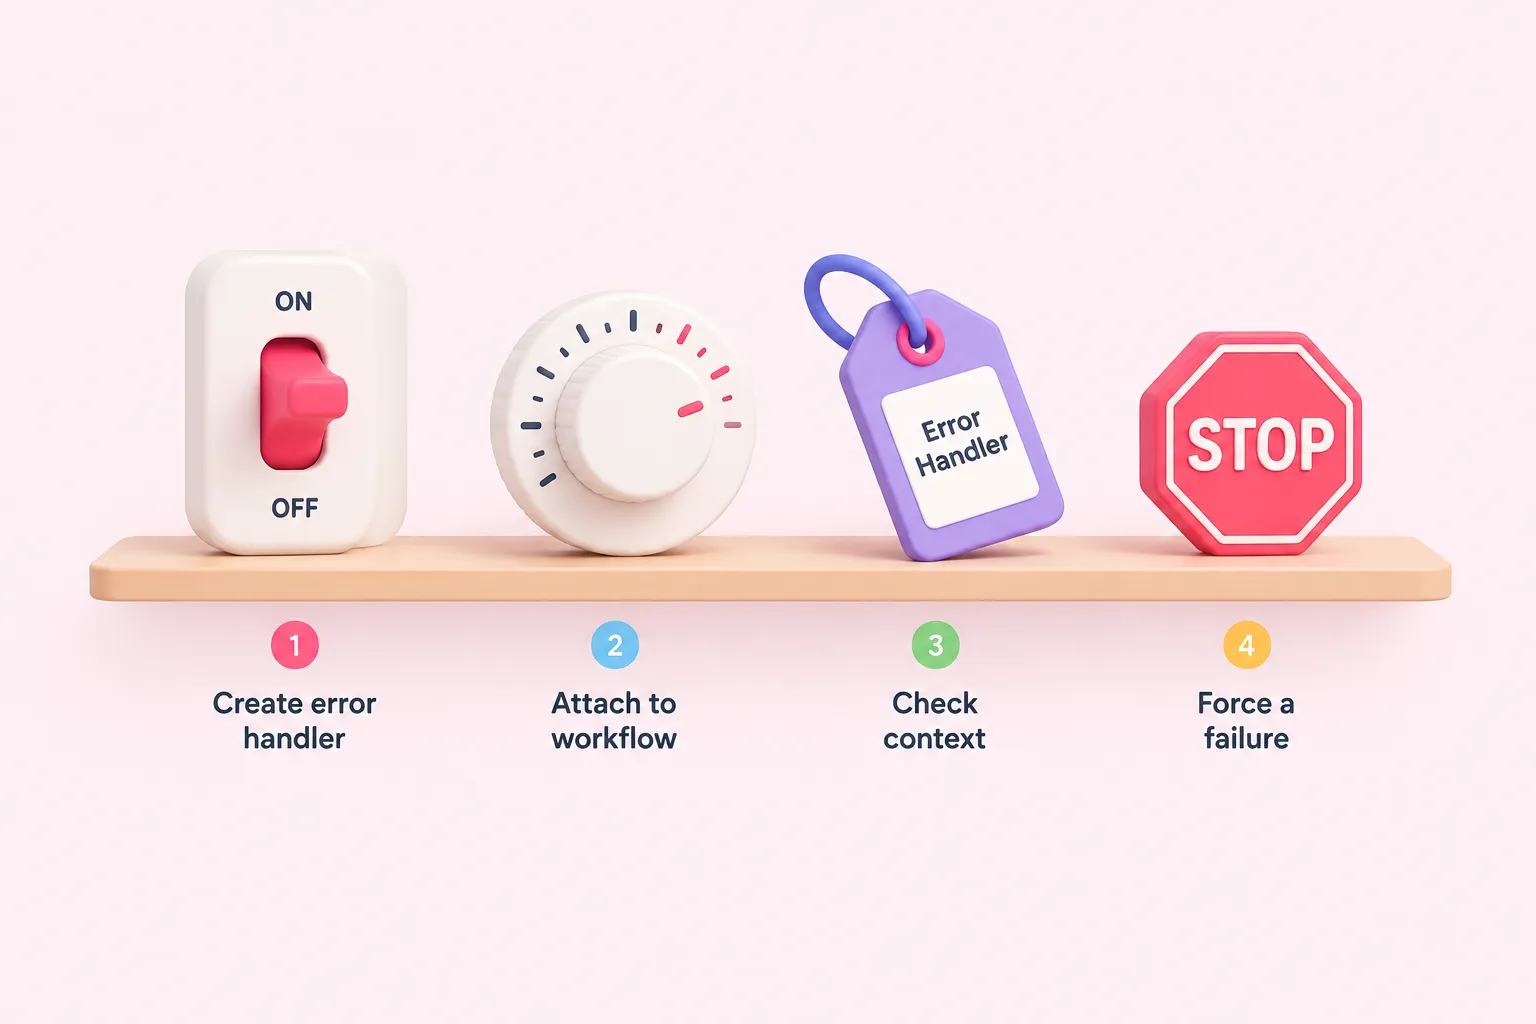
Крок 1 — створити окремий workflow Error Handler, який починається з ноди Error Trigger, адже документація n8n вказує, що error workflow має починатися саме з цієї ноди. У документації також зазначено, що workflow, який містить ноду Error Trigger, за замовчуванням використовує сам себе як error workflow. Ми вважаємо, що створення одного спільного workflow Error Handler для всієї команди варте додаткового кроку з налаштування, оскільки покладання на типове самопосилання кожного workflow розпорошує логіку сповіщень по всіх workflow замість того, щоб зберігати її в одному місці, яке реально можна підтримувати.
Крок 2 — прив'язати цей Error Handler до production-workflow, який ви зміцнюєте, — одна з найпростіших найкращих практик обробки помилок у n8n, яку варто впровадити на ранньому етапі. Документація описує це так: Options, потім Settings, а потім налаштування поля Error workflow у workflow, який ви хочете захистити.
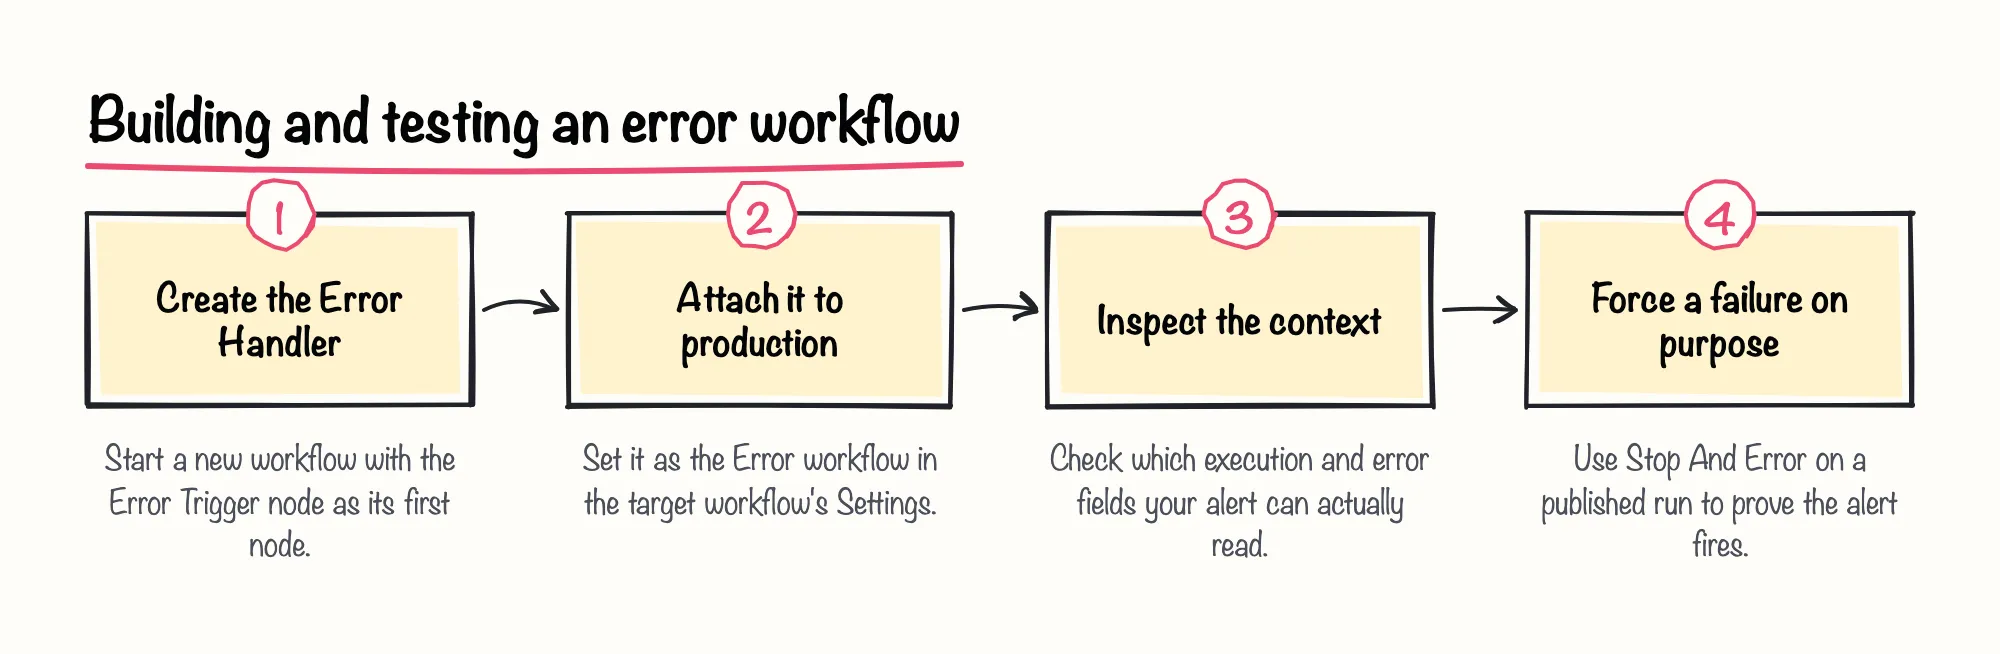
Крок 3 — перевірити контекст, який насправді отримує виконання Error Trigger, адже ваші сповіщення настільки корисні, наскільки корисні поля, які ви з них зчитуєте. У документації зазначено, що execution.retryOf присутнє лише тоді, коли саме виконання є повтором попереднього невдалого виконання, тож варто перевірити в тестовому запуску, чи заповнюється це поле для ваших реальних сценаріїв збоїв.
Крок 4 — навмисно спричинити збій, перш ніж довіряти шляху сповіщення. Документація n8n описує ноду Stop And Error як спосіб показати власне повідомлення про помилку та зробити так, щоб виконання завершувалося невдало за обраних вами умов, пропонуючи для цього дві операції: Error Message та Error Object. Це важливо, адже в документації чітко вказано, що Error Trigger не спрацьовує, коли workflow запускається вручну з канви; він спрацьовує лише під час автоматичних, опублікованих виконань, тож ручний тестовий запуск нічого не скаже про те, чи справді працює ваше сповіщення.
Незалежний навчальний контент з n8n додає тут трохи нюансів: опис супровідного відео в блозі спільноти за 2026 рік стверджує, що воно охоплює різні режими реагування на помилки, доступні для кожної ноди, такі як stop, continue або continue using the error output. Це власний підсумок автора блогу щодо відео, а не задокументована поведінка, тож сприймайте це як орієнтир для подальшого вивчення, а не як перевірений набір інструкцій.
Sources: Handle errors gracefully | Build | n8n Docs, Error Trigger | Nodes | n8n Docs, Stop And Error | Nodes | n8n Docs, Error Handling in n8n #2 — HTTP Requests and Dedicated Error Workflows [E013], How to Handle Errors in n8n (Error Handling) #1 [E011]
Кроки 5–7: обмежте повтори, додайте захист від дублікатів і перевірте свій тригер
Крок 5 — встановити жорстку межу для повторів, щоб нестабільний API не міг зупинити виконання на невизначений час. У документації описано опцію After Time Interval ноди Wait як паузу виконання на заданий час, яку можна використати для побудови паузи backoff перед повтором, а також описано ліміт часу відновлення (resume time limit), який дозволяє workflow автоматично продовжитися після досягнення певної межі, що обмежує всю послідовність. Таке обмеження повторів — одна з найкращих практик обробки помилок у n8n, яку варто налаштувати до того, як workflow почне залежати від нестабільного зовнішнього API.
Там також зазначено, що для часу очікування менше 65 секунд workflow не вивантажує дані виконання в базу даних, що впливає на те, як коротка затримка повтору поводиться на практиці. Цей основний посібник лише окреслює схему; окремі статті групи, присвячені ноді Wait та темпу повторів відносно rate limits, детально розбирають дизайн backoff крок за кроком.
- Додайте ноду Wait з обмеженням часу, щоб повтори не могли зупинити виконання на невизначений час.
- Розглядайте захист від повторних дій як окрему передпродакшенну перевірку, а не частину логіки повторів.
- Переконайтеся, що workflow має тригер, відмінний від ручного, і опублікований, перш ніж вважати будь-який запуск production-тестом.
Крок 6 — впровадити захист від повторних дій як окрему передпродакшенну перевірку, відокремлену від логіки повторів. Наша позиція така: захист від дублікатів заслуговує на окремий рядок у чеклісті, а не на злиття з обробкою повторів, адже саме змішування цих двох речей і призводить до того, що повторений запит тихо створює другий платіж або другий лист. Глибші деталі реалізації, як-от ключі ідемпотентності та перевірки на дублікати, розглянуто в окремих статтях групи про ідемпотентні вебхуки та запобігання дублюванню дій API.
Крок 7 — зрозуміти різницю між ручними та production-виконаннями, перш ніж вважати будь-що з цього робочим. Документація описує ручні виконання, запущені з канви, як спосіб ad hoc тестування логіки workflow, тоді як production-виконання вимагають під'єднаного тригера, відмінного від ручного, та опублікованого workflow за допомогою кнопки Publish. Також зазначено, що production-виконання ігнорують будь-які дані, закріплені (pinned) під час ручного тестування, тож закріплений вручну тестовий кейс не перенесеться після того, як workflow стане активним.
Sources: Wait | Nodes | n8n Docs, Types of executions | Build | n8n Docs
Очікувані результати та усунення типових проблем
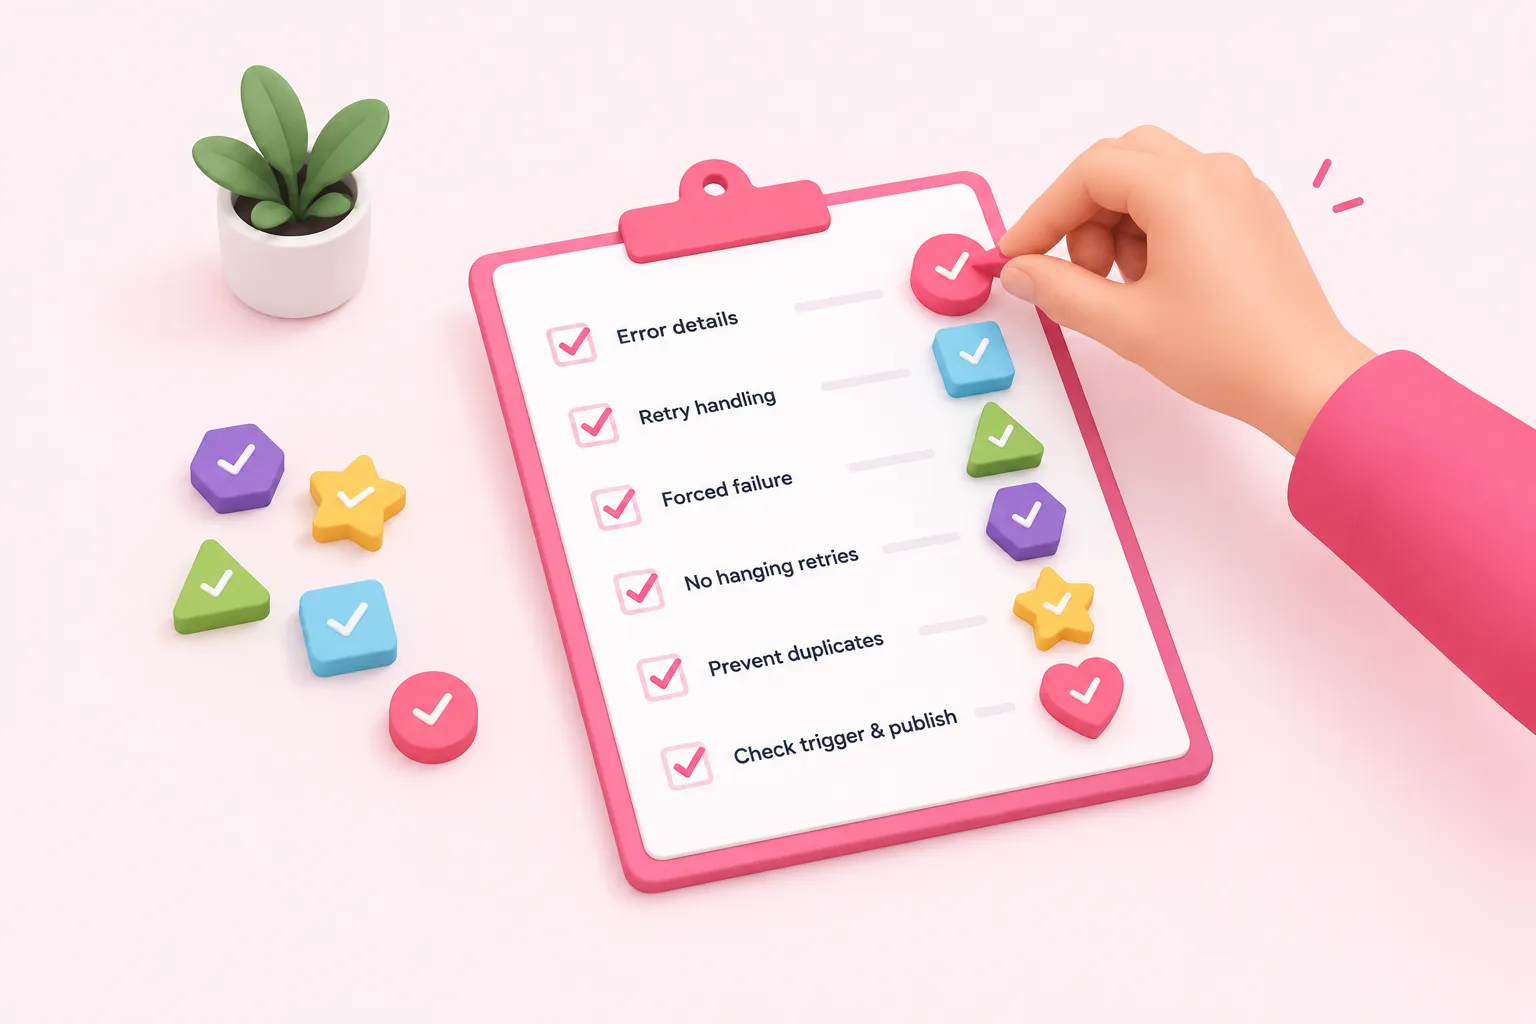
Коли все це налаштовано, невдале, опубліковане виконання має потрапляти у ваш workflow Error Handler з ідентифікатором виконання, URL, повідомленням про помилку та полем retryOf, якщо запуск сам є повтором. Навмисний збій через Stop And Error має генерувати таке саме сповіщення, як і справжній; ваша найдовша послідовність повторів має завершуватися самостійно, а не зависати; а повторна дія має перехоплюватися до того, як вона продублює побічний ефект.
Якщо щось не сходиться, почніть із тригера та статусу публікації, адже це найпоширеніша прогалина: документація наводить конкретне повідомлення про помилку для часткового виконання, яке спробували запустити без підключеної ноди тригера, — це корисна ознака того, що workflow налаштований не так, як ви очікуєте. Якщо Error Trigger жодного разу не спрацював під час тестування, поверніться до відмінності між ручним і опублікованим виконанням, описаної вище в кроці 4.
Sources: Handle errors gracefully | Build | n8n Docs, Error Trigger | Nodes | n8n Docs, Stop And Error | Nodes | n8n Docs, Types of executions | Build | n8n Docs
Куди рухатися далі в цій тематичній групі
Цей посібник задумано як відправну точку для ширшого кола питань надійності. Коли базовий error workflow і обмежені повтори вже налаштовані, вам, ймовірно, захочеться детальніше розглянути темп запитів до API з обмеженням частоти, відокремлення логіки відновлення від шляху успіху при збої HTTP-запиту, зберігання стабільного ключа, щоб доставка вебхука ніколи не оброблялася двічі навіть за умови паралельних повторів, а також патерн позначення дії в наступній системі як доставленої лише після її фактичного підтвердження. Кожне з цих питань — окрема практична вправа, побудована на основі, викладеній тут.