El nodo Wait de n8n: gestión de reintentos y APIs con límite de tasa
Guía práctica del nodo Wait de n8n para pausar un flujo ante una API con límite de tasa y reanudarlo con los mismos datos, más patrones de reintento.
Comprobado con las fuentes citadas el .
Requisitos previos y objetivo: pausar un flujo de trabajo con límite de tasa
Si un flujo de trabajo que estás creando llama a una API que impone límites de tasa, el nodo Wait de n8n te permite pausar la ejecución y retomarla más tarde con los mismos datos en curso, en lugar de perder los elementos que estabas procesando a medias. Este tutorial asume que ya tienes un flujo de trabajo de n8n que llama a una API externa desde un nodo HTTP Request, y que la API a veces responde lentamente, te pide que reduzcas el ritmo o devuelve un error de límite de tasa.
- Un flujo de trabajo de n8n con un nodo HTTP Request que llame a la API con límite de tasa
- Acceso para añadir y configurar un nodo Wait en ese flujo de trabajo
- Conocimiento de la respuesta de límite de tasa de la API, como un estado 429 o una cabecera Retry-After
La idea subyacente es sencilla. La propia documentación de n8n describe la espera como una forma de pausar un flujo de trabajo a mitad de ejecución y reanudarlo donde se quedó, con los mismos datos, lo cual es útil para regular el ritmo de las llamadas a un servicio con límite de tasa o para esperar un evento externo antes de continuar (F4). Para que esa pausa sea segura, n8n descarga los datos de la ejecución en curso a su base de datos mientras el flujo de trabajo espera, y los vuelve a cargar cuando el flujo se reanuda (F2).
Este tutorial combina el nodo Wait con Retry On Fail, Loop Over Items y un flujo de trabajo de Error Trigger en un diseño continuo único. Ninguna de las fuentes usadas aquí muestra todo esto combinado en un ejemplo completo de principio a fin; esta combinación es una síntesis propia de este tutorial a partir de páginas de documentación oficial independientes, no un flujo de trabajo de referencia documentado.
Sources: Wait | Build | n8n Docs, Wait | Nodes | n8n Docs
Paso 1 y 2: configurar el nodo Wait de n8n y regular las solicitudes con Loop Over Items
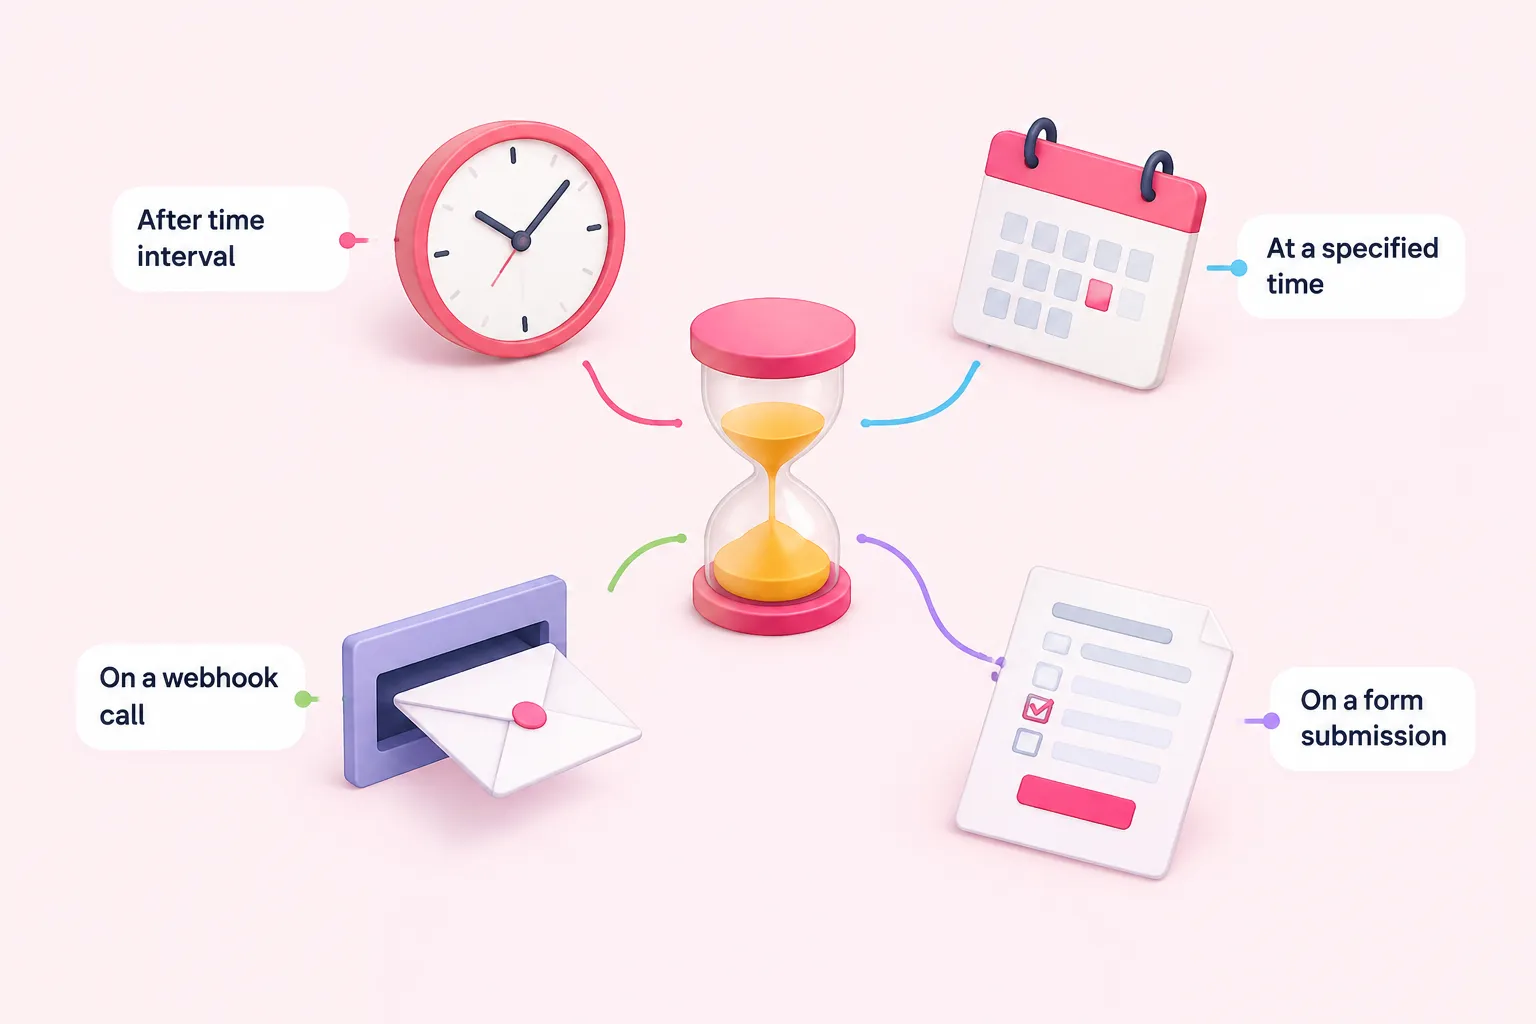
Comienza añadiendo un nodo Wait de n8n después de la llamada que quieres regular. El nodo admite cuatro condiciones de reanudación: tras un intervalo de tiempo fijo, en un momento específico, al recibir una llamada webhook entrante, o al enviarse un formulario (F1). Para regular las llamadas a una API con límite de tasa, After Time Interval suele ser la opción más sencilla, ya que controlas el retraso directamente en lugar de esperar un disparador externo.
| Modo de reanudación | Qué activa la reanudación | Uso típico |
|---|---|---|
| After Time Interval | Ha transcurrido una duración fija que configuraste | Regular llamadas a una API con límite de tasa |
| At a Specified Time | El reloj llega a una fecha y hora elegidas | Programar una reanudación para un momento futuro conocido |
| On Webhook Call | Un sistema externo llama a una URL de webhook generada | Esperar a que otro sistema indique que está listo |
| On Form Submitted | Alguien envía un formulario de n8n vinculado | Esperar a que una persona proporcione información |
Para una lista de elementos que necesitas enviar de uno en uno, la documentación de n8n describe cómo combinar un nodo Loop Over Items con un nodo Wait: agrupa los elementos de entrada con Loop Over Items, realiza la llamada a la API y luego coloca un nodo Wait después para que el bucle se pause entre solicitudes en lugar de dispararlas todas a la vez (F10). Esto mantiene intactos los datos de cada iteración porque es el flujo de trabajo, no un script aparte, el que conserva el estado del bucle mientras espera.
Un detalle que conviene saber antes de depender de esperas muy cortas: n8n no descarga los datos de ejecución a la base de datos en esperas de menos de 65 segundos, y en su lugar mantiene el proceso en memoria hasta que pasa el intervalo (F3). Para pausas cortas ocasionales esto es invisible; la documentación no describe cómo se comporta esto con muchas esperas cortas concurrentes, así que trata la acumulación de esperas cortas a gran volumen como un terreno sin probar que conviene verificar en tu propio entorno, no como un patrón garantizado.
Construcción del flujo de reintentos y esperas
- Añade un nodo Wait: Colócalo después de la llamada a la API y elige una condición de reanudación que se ajuste a la situación.
- Regula con Loop Over Items: Agrupa los elementos y coloca un nodo Wait dentro del bucle para espaciar las solicitudes.
- Activa Retry On Fail: Deja que el propio nodo reintente brevemente con una pausa entre intentos.
- Crea un bucle Wait personalizado: Dirige los fallos a un nodo Wait y de vuelta para retrasos más largos de lo que permite el reintento incorporado.
- Añade un flujo de trabajo con Error Trigger: Captura los reintentos agotados una vez que el bucle personalizado se rinde.
- Respeta Retry-After: Usa la propia señal de la API para fijar la duración de la espera en lugar de adivinar.
Sources: Wait | Nodes | n8n Docs, Handle rate limits | Nodes | n8n Docs
Paso 3 y 4: Retry On Fail automático frente a un bucle de espera con backoff personalizado
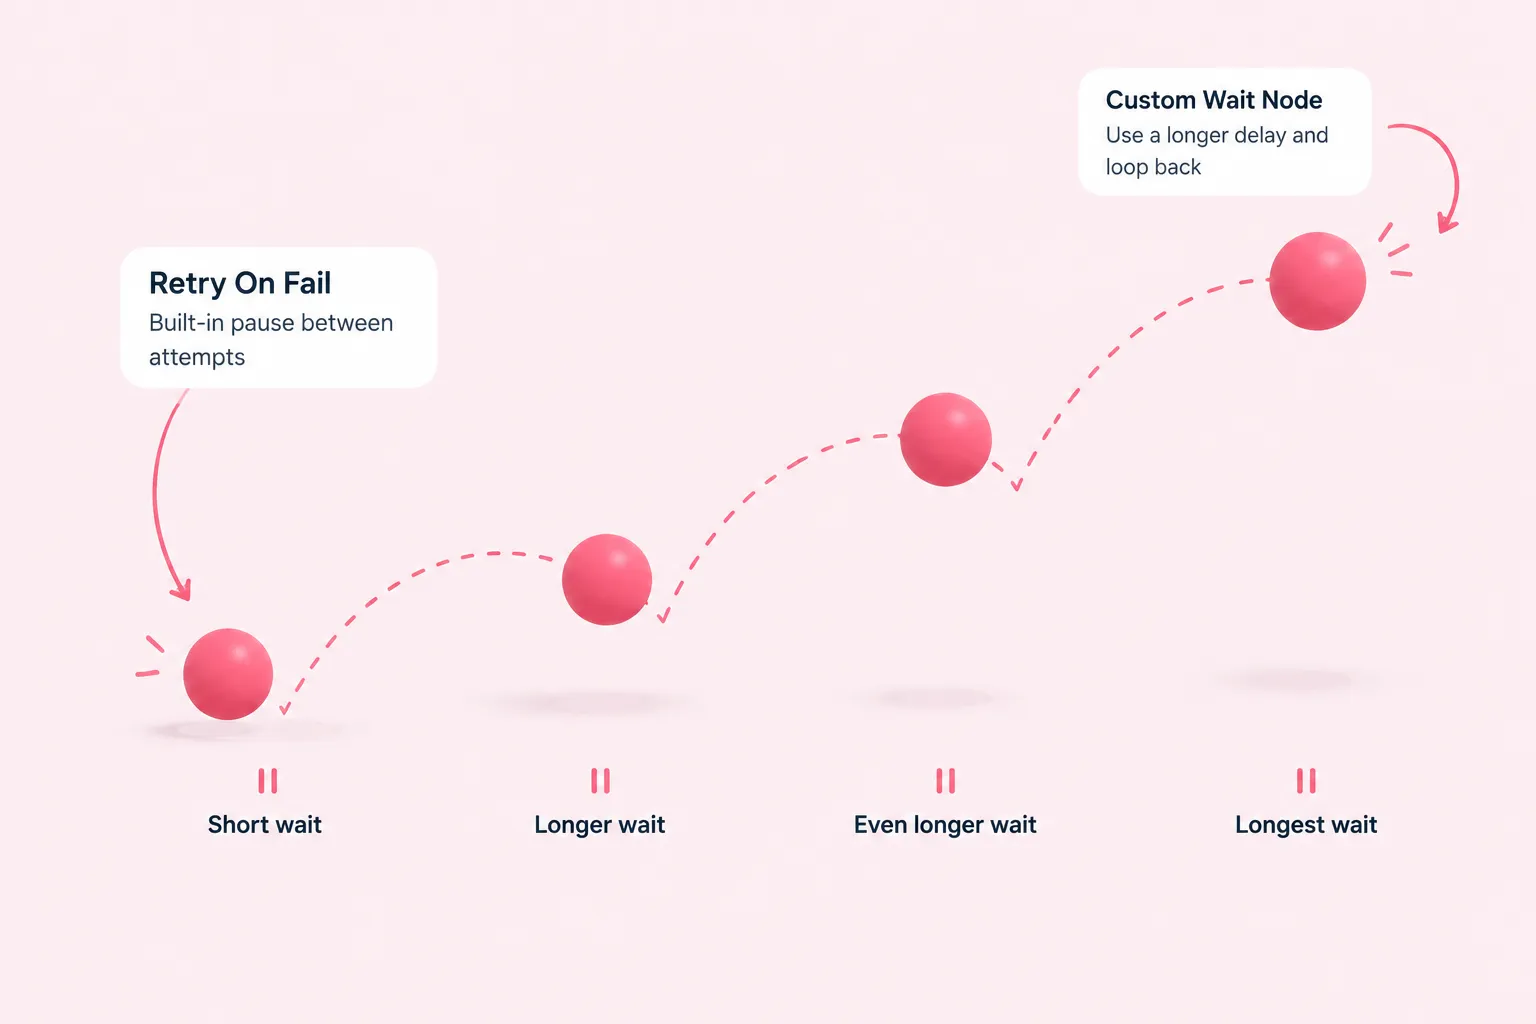
Para reintentos cortos a nivel de nodo, activa Retry On Fail en el nodo HTTP Request. La documentación de n8n describe este ajuste como una forma de añadir una pausa entre intentos de reintento automáticos, lo cual es una manera integrada de gestionar límites de tasa sin construir lógica adicional (F9). Prueba esto primero antes de recurrir a un bucle personalizado, ya que no necesita nodos adicionales.
Retry On Fail tiene un límite. Un colaborador de un foro comunitario describe que la espera de reintento incorporada del nodo tiene un tope de alrededor de 5000 milisegundos, y sortea ese límite dirigiendo la salida de error del nodo a un nodo Wait aparte configurado con el retraso más largo que se necesite, para luego volver a dirigirlo al mismo nodo (F12). Este es el relato de un colaborador en un hilo de foro y no un comportamiento documentado de n8n, así que trata el tope exacto como no verificado y pruébalo en tu propio flujo de trabajo antes de depender de él.
- Conecta la salida de error del nodo a un nuevo nodo Wait en lugar de dejar que el flujo de trabajo falle
- Configura la duración de ese nodo Wait con el retraso que realmente necesitas
- Dirige la salida del nodo Wait de vuelta al nodo original que llama a la API
- Limita el número de pasadas del bucle para que una llamada que falla persistentemente deje de reintentar en algún momento
Una idea relacionada compartida en un blog personal reemplaza una duración de Wait fija única por una calculada dinámicamente, basada en la propia señal de retry-after de la API y una curva de backoff que se alarga con cada intento, en lugar de esperar siempre la misma cantidad de tiempo (F11). Esa publicación también promociona una plantilla de flujo de trabajo de pago, y sus detalles técnicos no están confirmados por la propia documentación de n8n, así que úsala como un patrón para adaptar y verificar, no como una receta probada.
Sources: Handle rate limits | Nodes | n8n Docs, Every node: Retry on fail > max. 5000ms > why? - Questions - n8n Community, How I Ended Up Building a Stable Async Processor for n8n (and Turned It Into a PRO Tempate) - DEV Community
Paso 5 y 6: capturar los reintentos agotados y respetar Retry-After
Una vez que tu bucle Wait personalizado ha reintentado tantas veces como permitas, entrega el fallo a un flujo de trabajo de error en lugar de dejar que desaparezca. Un flujo de trabajo de error debe comenzar con un nodo Error Trigger, y el mismo flujo de trabajo de error puede reutilizarse en varios flujos de trabajo (F7). Ten en cuenta que el Error Trigger solo se activa para flujos de trabajo ejecutados automáticamente, no para ejecuciones de prueba manuales, así que no puedes confirmar esta ruta solo con hacer clic en "Execute Workflow" (F5). Para verificarlo deliberadamente, añade un nodo Stop And Error bajo una condición de prueba; obliga al flujo de trabajo a fallar y activa a propósito el flujo de trabajo de error vinculado (F8).
- Comienza el flujo de trabajo de error con un nodo Error Trigger, que puedes reutilizar en varios flujos de trabajo
- Recuerda que las ejecuciones automáticas activan el Error Trigger, no las ejecuciones de prueba manuales
- Provoca un fallo deliberado con un nodo Stop And Error para confirmar que el flujo de trabajo de error realmente se activa
Hay una interacción que no cubren las fuentes usadas aquí: cómo se comporta la reanudación de un nodo Wait si el mismo flujo de trabajo también tiene un nodo Error Trigger o Stop And Error activo al mismo tiempo. Esto no está documentado en las páginas oficiales en las que se basa este tutorial, así que prueba con cuidado tu combinación específica de nodos Wait y de gestión de errores antes de depender de ella en producción.
Cuando tu flujo de trabajo de error recibe los datos del fallo, estos incluyen un campo retryOf que solo está presente cuando la ejecución reportada fue en sí misma un reintento de una ejecución fallida anterior, lo cual es un contexto útil para distinguir un fallo por primera vez de una cadena de reintentos agotada (F6).
Por último, no adivines las duraciones de espera cuando la API te indica qué hacer. Las propias indicaciones de n8n recomiendan que, tras una respuesta 429, un flujo de trabajo lea las cabeceras de respuesta de la API y use cualquier valor de Retry-After para decidir cuánto esperar antes de volver a intentarlo, en lugar de reintentar de inmediato o según un horario fijo (F13). Introduce ese valor en la duración de tu nodo Wait para que tu ritmo siga la propia señal de la API en lugar de una suposición arbitraria.
Sources: Handle errors gracefully | Build | n8n Docs, Error Trigger | Nodes | n8n Docs, A Guide to API Rate Limiting for More Reliable Workflows – n8n Blog
Resultados esperados y resolución de problemas del nodo Wait de n8n
Con esta configuración, un flujo de trabajo que llama a una API con límite de tasa debería pausarse limpiamente en cada nodo Wait de n8n, mantener intactos sus elementos en curso porque n8n descarga los datos de ejecución a su base de datos mientras espera (F2), y reanudarse automáticamente en cuanto ocurra el intervalo, la hora, la llamada webhook o el envío de formulario que hayas configurado (F1). Los reintentos que superen tus límites integrados deberían llegar a tu flujo de trabajo de error con suficiente contexto, incluido el campo retryOf, para distinguir un fallo nuevo de una cadena de reintentos agotada (F6).
Una espera corta que se reanuda casi al instante es lo esperado, no un error (F3). Si tu flujo de trabajo de error nunca parece ejecutarse durante las pruebas, probablemente se deba a la limitación de las ejecuciones manuales ya comentada en el Paso 5 y 6, no a un problema de configuración (F5).
Sources: Wait | Nodes | n8n Docs, Error Trigger | Nodes | n8n Docs, Handle errors gracefully | Build | n8n Docs, A Guide to API Rate Limiting for More Reliable Workflows – n8n Blog