Режим черги n8n не працює: чеклист для усунення несправностей
Практичний чеклист для ситуацій, коли режим черги n8n не працює: воркери здорові, а завдання застигають — EXECUTIONS_MODE, Redis, здоров'я воркерів.
Перевірено за наведеними джерелами .
Перш ніж починати: підтвердьте симптом і зберіть дані про інстанс
Якщо ви бачите, що режим черги n8n не працює — воркери показані як онлайн, але завдання застигають у черзі або ніколи не виходять зі стану «виконується» — не поспішайте перезапускати все одразу. Витратьте п'ять хвилин, щоб точно з'ясувати, що відбувається: який workflow і тип тригера зачеплено, як довго завдання застигли, і чи почалося зависання після деплою, перезапуску Redis, чи без жодних відомих вам змін. Запишіть версію n8n, значення EXECUTIONS_MODE на main-процесі та на кожному воркері, а також чи використовуєте ви single-main чи multi-main, перш ніж проходити перевірки нижче.
Маючи ці дані під рукою, кожна перевірка перетворюється на швидке порівняння замість нового розслідування — і зазвичай саме це визначає, стане виправлення п'ятихвилинним чи затягнеться на цілий день вгадувань.
Перевірка 1–2: чи не працює режим черги n8n через EXECUTIONS_MODE або Redis?
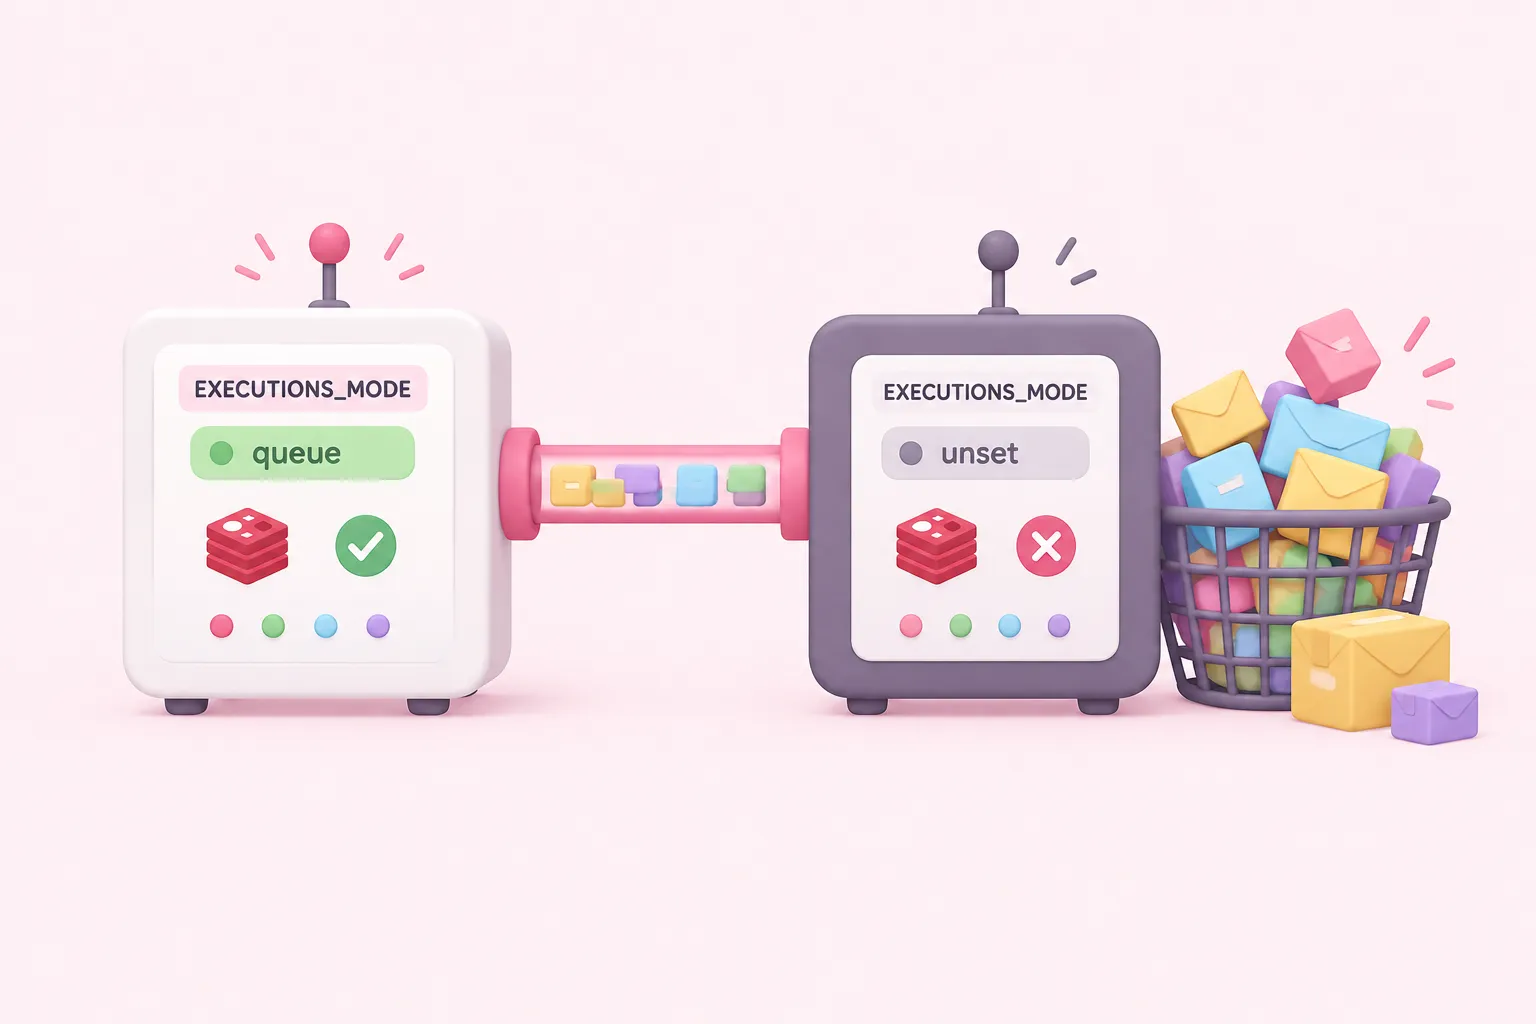
Причина, чому режим черги n8n не працює, часто зводиться до одного неузгодженого налаштування: чи однаково встановлено EXECUTIONS_MODE=queue на main-процесі та на кожному воркері. Режим черги залежить від того, щоб це значення збігалося на всіх процесах. Публікація в блозі постачальника Elestio за 2026 рік описує, що відбувається, коли це пропустили: якщо EXECUTIONS_MODE=queue встановлено на main-процесі, але не встановлено — або встановлено інакше — на воркері, цей воркер взагалі не дивиться в черзі Redis. Виконання продовжують запускатися локально на main, черга лишається порожньою, а воркери, які ви бачите як «активні», — це здорові процеси, що не роблять жодної корисної роботи.
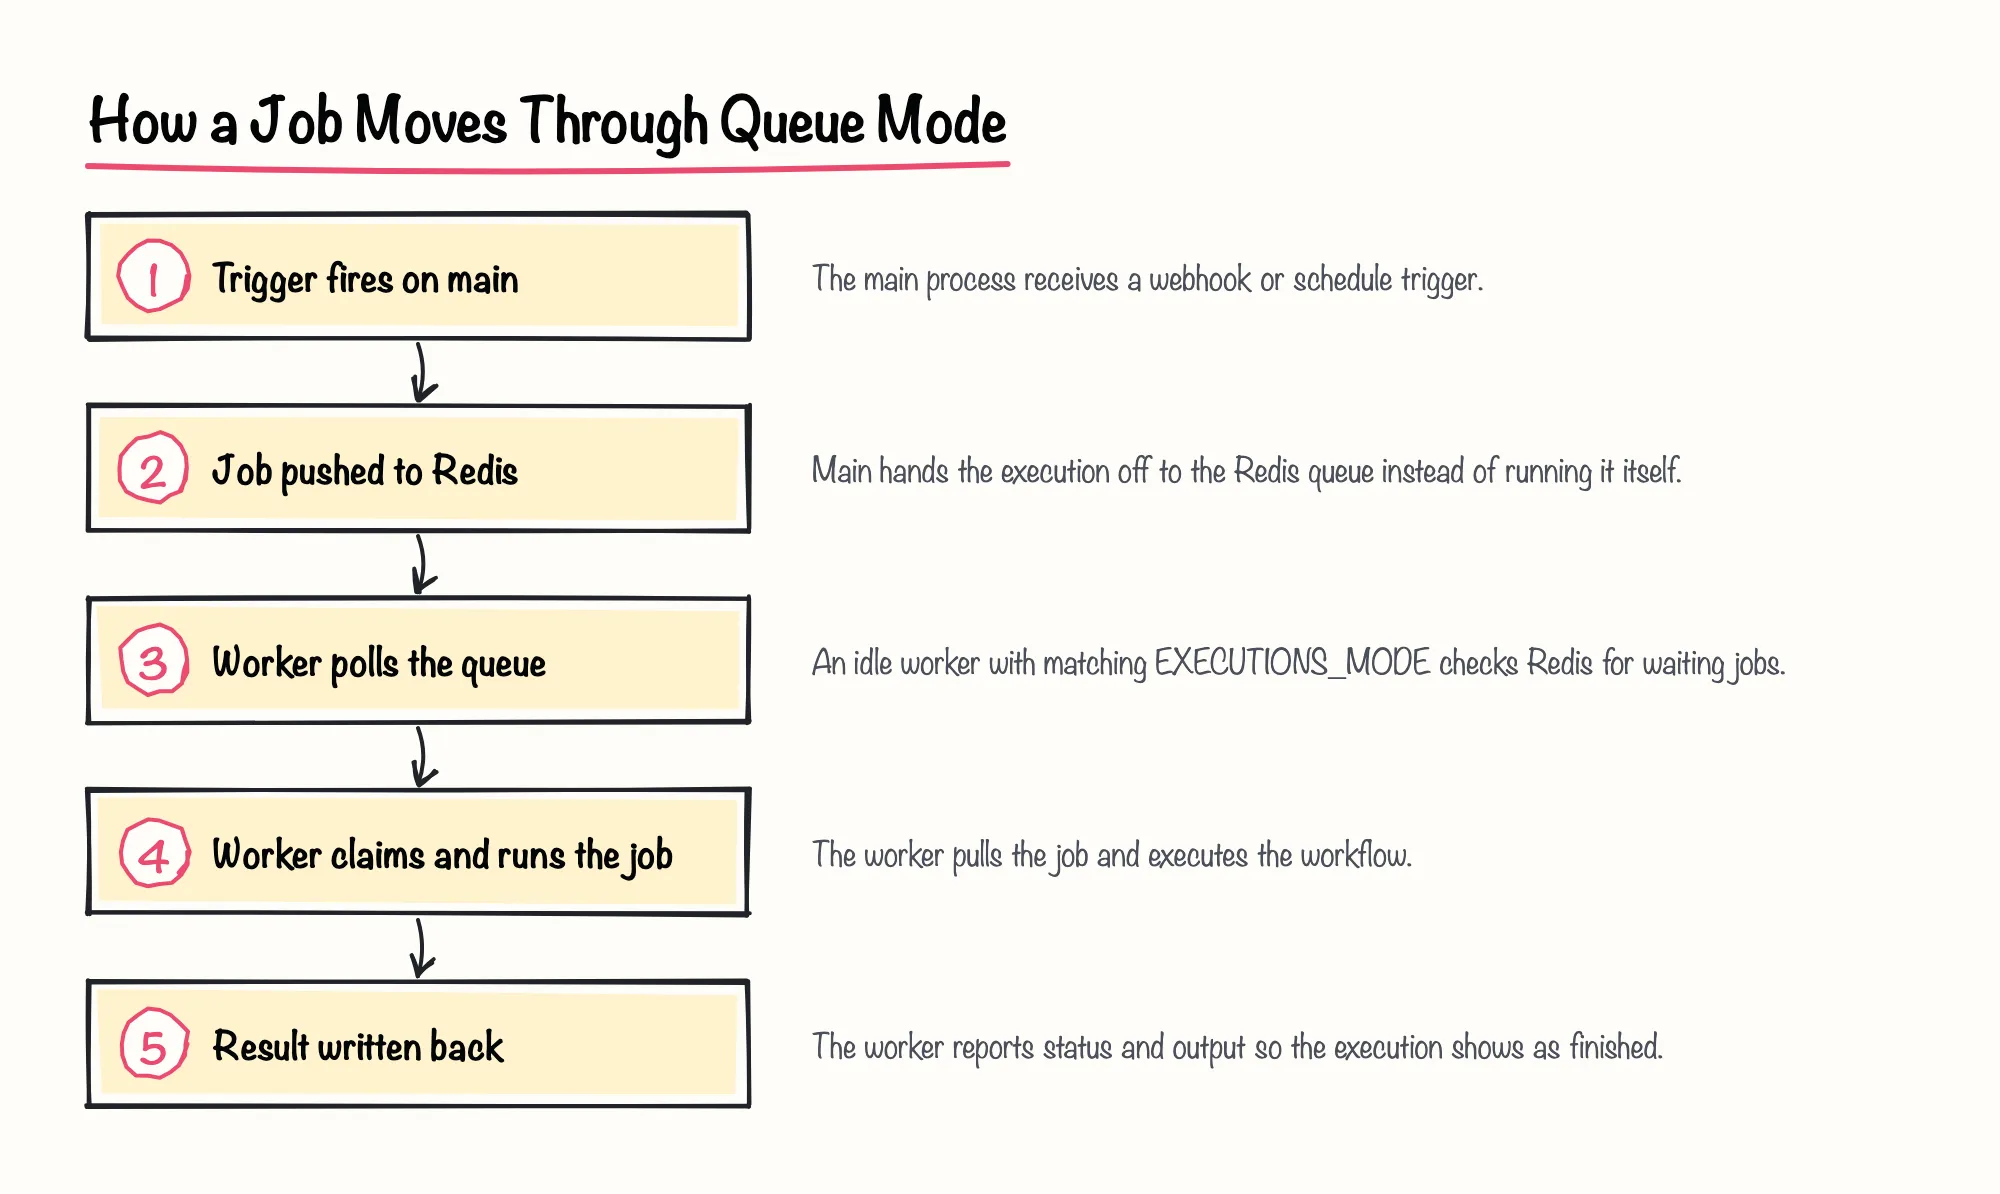
Корисно побачити, як натомість має працювати правильно налаштована система. Як описує це учасниця команди n8n Юлія Дмитрієвна у блозі n8n,
Коли EXECUTIONS_MODE підтверджено на кожному процесі, перевірте, чи можуть main і кожен воркер дійсно підключитися до Redis. Офіційна довідка n8n щодо змінних середовища документує QUEUE_BULL_REDIS_TIMEOUT_THRESHOLD як налаштовуваний таймаут цього з'єднання — варто порівняти його з реальною мережевою латентністю, особливо між контейнерами, VPC чи регіонами.
Ми б розглядали такі матеріали, як стаття Elestio, як корисну другу думку, а не перше місце для пошуку: вони описують реальні симптоми в production, але самі вимоги щодо режиму та змінних походять безпосередньо з офіційної документації n8n, тож перевіряйте саме її першою.
Sources: How to Scale n8n with Redis Queue Mode for Parallel Workflow Execution, Queue mode | Deploy | n8n Docs
Перевірка 3–4: неузгодженість ключів шифрування та стан воркерів
Друга, більш прихована причина — неузгодженість ключа шифрування. Публікація в блозі постачальника Elestio за 2026 рік стверджує, що коли N8N_ENCRYPTION_KEY відрізняється між main і воркером, кожен workflow, що використовує збережені креденшали, тихо провалюється — воркер, який не може розшифрувати креденшал, просто не може виконати ноду, якій він потрібен, і нічого явно не вказує на сам ключ.
Далі підтвердьте, що воркери справді зареєстровані, а не просто запущені. Офіційна документація n8n зазначає, що перегляд підключених воркерів через Settings > Workers в інтерфейсі — це функція self-hosted Enterprise, тож команди на Community-редакції не мають цього перегляду і потребують іншого способу перевірити стан воркерів.
Цей інший спосіб — власні health-ендпоінти n8n, і вони поводяться по-різному залежно від того, що саме ви перевіряєте. Офіційна документація з моніторингу стверджує, що для серверів-воркерів у режимі черги ендпоінт перевірки працездатності вимкнено за замовчуванням — на відміну від ендпоінту main-сервера, який завжди увімкнений. Окремо ендпоінт готовності воркера повідомляє, чи готові власні з'єднання воркера з базою даних і Redis, але лише коли увімкнено QUEUE_HEALTH_CHECK_ACTIVE.
| Ендпоінт | Стан за замовчуванням | Що він показує |
|---|---|---|
| Ендпоінт здоров'я main-сервера | Увімкнено за замовчуванням | Підтверджує, що main-процес активний |
| Ендпоінт здоров'я воркера | Вимкнено за замовчуванням | Підтверджує, що процес воркера активний, після увімкнення |
| Ендпоінт готовності воркера | Опціонально через QUEUE_HEALTH_CHECK_ACTIVE | Чи готові з'єднання цього воркера з БД і Redis |
| Інтерфейс Settings > Workers | Лише self-hosted Enterprise | Актуальний список підключених воркерів |
Sources: How to Scale n8n with Redis Queue Mode for Parallel Workflow Execution, Enable queue mode | Deploy | n8n Docs, Monitor n8n | Deploy | n8n Docs
Перевірка 5–6: налаштування конкурентності та планування тригерів
Якщо воркери здорові й доступні, але завдання все одно накопичуються, подивіться на конкурентність. Офіційна документація n8n радить встановлювати конкурентність воркера на рівні 5 або вище та попереджає, що поєднання багатьох воркерів із дуже низькою конкурентністю може виснажити пул з'єднань бази даних замість того, щоб щось прискорити.
Також перевірте N8N_CONCURRENCY_PRODUCTION_LIMIT на main-процесі. Офіційна документація стверджує, що в режимі черги ця змінна перекриває прапорець --concurrency воркера, якщо її встановлено на будь-яке значення, крім -1, тож забуте низьке значення тут може тихо обмежити пропускну здатність незалежно від того, як налаштовані окремі воркери.
Учасники спільноти повідомляють у публікації на Medium за 2026 рік, що завдання, які накопичуються рівно на межі вашого лімітa конкурентності, при зростаючій черзі очікування — найвиразніша ознака того, що потрібні додаткові воркери, а не додаткове тюнінгування. На нашу думку, саме такий порядок міркувань правильний: спочатку виключіть неузгодженості конфігурації, і лише після того, як підтвердите, що вузьке місце дійсно в пропускній здатності, додавайте потужність воркерів.
Насамкінець, якщо самі тригери перестали спрацьовувати, а не завдання застигають невиконаними, перевірте лідерство. Офіційна документація n8n щодо надійного планувальника стверджує, що в налаштуванні multi-main розклади спрацьовують лише на лідируючому інстансі, тож втрата лідерства може виглядати ідентично до поламаного режиму черги. Там, де увімкнено надійний планувальник та його метрики Prometheus, зростаюче значення n8n_scheduler_oldest_pending_age_seconds або ненульове значення n8n_scheduler_tasks_due вказують саме на проблему з плануванням, а не з виконанням.
- Завдання застигають невиконаними, хоча конкурентність нижча за ліміт воркера: ймовірно, проблема з плануванням або лідерством, а не з конкурентністю.
- Завдання накопичуються рівно на межі вашого ліміту конкурентності, і черга очікування зростає: ймовірно, справжня нестача потужності — варто розглянути додаткові воркери.
- Для workflow за розкладом не з'являється жодних нових запусків: спочатку перевірте лідерство у multi-main.
Sources: Enable queue mode | Deploy | n8n Docs, Control concurrency | Deploy | n8n Docs, n8n Queue Mode Explained: Setup, Scaling, Monitoring | Medium, Durable scheduler | Deploy | n8n Docs
Перевірка 7 і постійний моніторинг: застиглі завдання та раннє виявлення проблеми
Не кожен випадок, коли режим черги n8n не працює, походить від конфігурації — деякі виникають через завдання, які почалися, але ніколи не завершилися. Публікація в блозі постачальника Elestio за 2026 рік стверджує, що виконання, застиглі в стані «виконується» на невизначений час, зазвичай спричинені крахом воркера посеред виконання, через що завдання залишається осиротілим без будь-кого, хто оновив би його статус.
Учасники спільноти повідомляють у публікації на Medium за 2026 рік, що коли це відбувається, завдання, яке виконується, позначається в Redis як «застигле» і пізніше повторно виконується іншим воркером. Власна довідка n8n щодо змінних середовища документує QUEUE_WORKER_STALLED_INTERVAL як налаштування, що контролює, як часто воркер перевіряє саме такі застиглі завдання — варто переглянути, якщо повторні спроби відчуваються занадто повільними або занадто агресивними для вашого навантаження.
На нашу думку, варто увімкнути ендпоінти здоров'я та метрик ще до того, як ви опинитеся посеред інциденту, а не після. Офіційна документація n8n щодо моніторингу зазначає, що ендпоінт /metrics вимкнено за замовчуванням на self-hosted інстансах і його потрібно явно увімкнути, тож тиждень без зависань — це якраз правильний момент, щоб увімкнути його, а не ніч, коли щось застрягло.
Sources: How to Scale n8n with Redis Queue Mode for Parallel Workflow Execution, n8n Queue Mode Explained: Setup, Scaling, Monitoring | Medium, Queue mode | Deploy | n8n Docs, Monitor n8n | Deploy | n8n Docs, Enable queue mode | Deploy | n8n Docs