Вправа: Cloud Run проти Kubernetes (GKE) для практичного інстансу n8n
Практична вправа з порівняння Cloud Run і Kubernetes для self-hosted n8n: час запуску, зберігання, масштабування воркерів і витрати в простої.
Перевірено за наведеними джерелами .
Редакційна вправа: завдання та мета
Cloud Run проти Kubernetes — одне з перших рішень, з яким стикаються операційні та ІТ-команди, щойно вони переводять self-hosted n8n з тестового режиму в щось, що має нести реальне продакшн-навантаження. Ця редакційна вправа дає вам практичний спосіб напряму порівняти обидві платформи, використовуючи власний практичний інстанс n8n, а не чужий готовий бенчмарк. Мета вузька: розгорнути однакове self-hosted налаштування n8n на Google Cloud Run і на Kubernetes у GKE, а потім виміряти час запуску, поведінку постійного зберігання даних, масштабування воркерів у режимі черги та вартість у режимі простою на кожній платформі.
Це позначена редакційна вправа, а не перевірений бенчмарк. Ми самі не виконували ці розгортання, і жодне офіційне джерело не вказує в секундах затримку холодного старту чи запуску пода для жодної з платформ. Саме ви отримуєте ці цифри; наведені нижче кроки лише гарантують, що ви вимірюєте одне й те саме, однаковим способом, на обох сторонах.
Передумови, вхідні дані та обмеження
Перш ніж починати, вам потрібен проєкт Google Cloud з увімкненим білінгом, робочі знання з self-hosting n8n (Docker, змінні середовища, база даних) та практичний інстанс n8n, який ви готові знищити. Не спрямовуйте цю вправу на продакшн-інстанс: ви навмисно будете форсувати перезапуски, події масштабування до нуля та повторні розгортання.
Обмежте масштаб вправи. Блог постачальника LOW/CODE Agency у порівнянні за вересень 2026 року оцінює, що перше самостійне розгортання n8n на Docker займає від двох до чотирьох годин, і окремо зазначає, що масштабне self-hosting на Kubernetes додає значну складність налаштування для команд без досвіду в DevOps; сприймайте це як орієнтовну оцінку, а не вимірюваний результат, і натомість засічіть час власного налаштування. Ми б не намагалися відтворювати повноцінний високодоступний кластер для цієї вправи — одного пулу вузлів GKE Standard і одного сервісу Cloud Run достатньо, щоб чесно порівняти платформи.
Sources: n8n Self-Hosted vs Cloud: Which Is Right? | LOW/CODE
Cloud Run проти Kubernetes: розгортання та вимірювання часу запуску
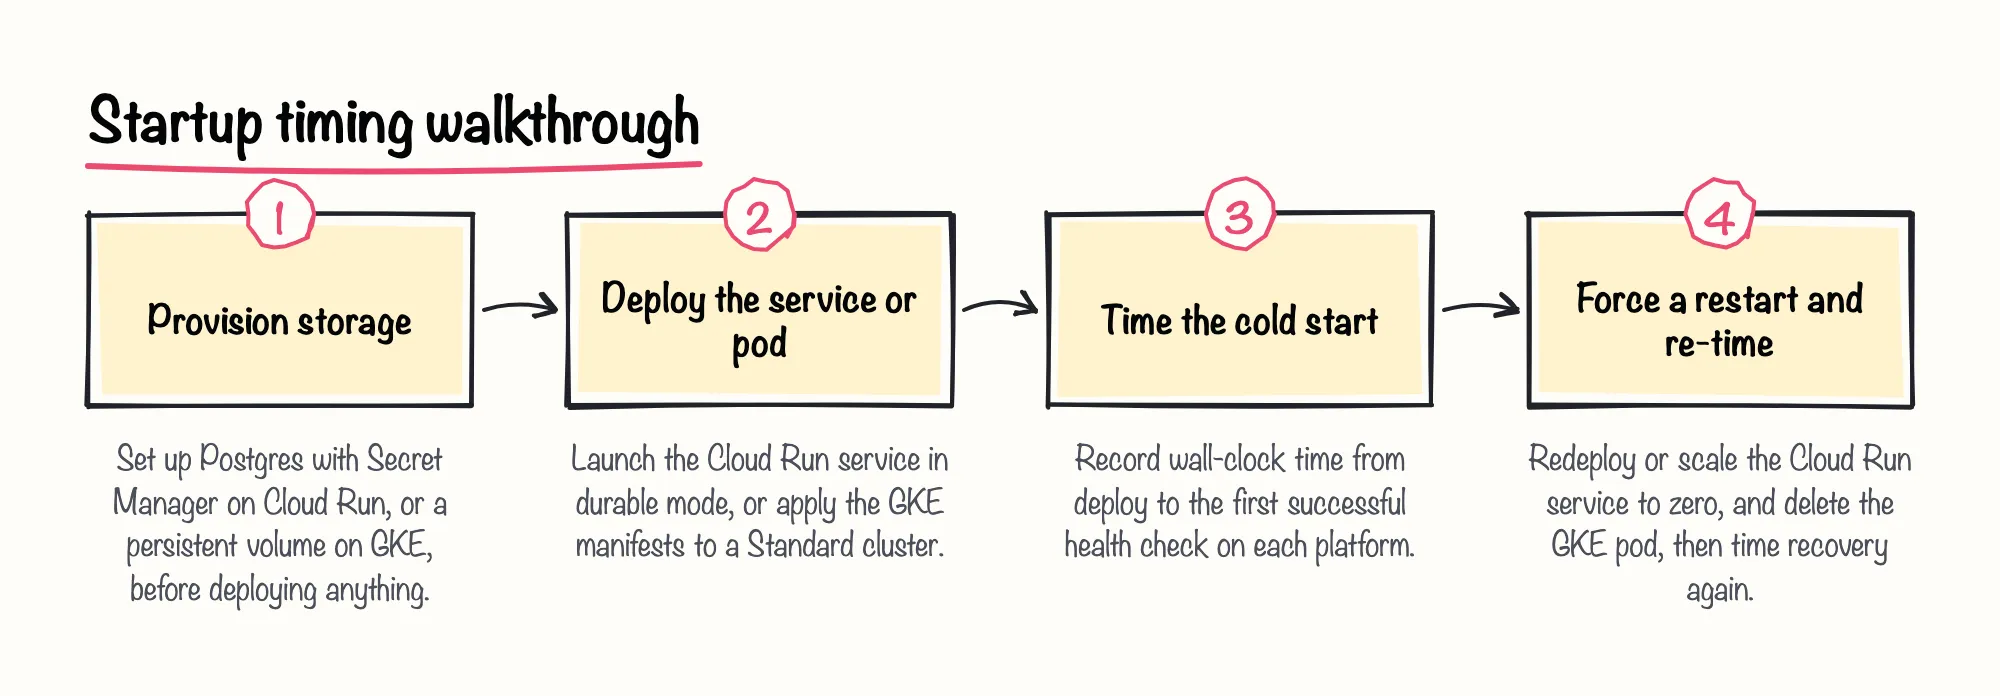
У Cloud Run власний посібник із розгортання n8n описує два режими. Простіший «easy mode» зберігає дані n8n у пам'яті, і ці дані втрачаються щоразу, коли сервіс Cloud Run масштабується до нуля або повторно розгортається, згідно з офіційним посібником n8n. Надійніший «durable mode» додає Postgres і Secret Manager; розгортайте саме цей варіант, а не easy mode, якщо хочете отримати цифри, які мають сенс для продакшн-рішення. Той самий посібник зазначає, що Cloud Run резервує стандартний шлях /healthz для власних перевірок стану платформи, що конфліктує зі стандартною кінцевою точкою перевірки стану n8n, тож вам потрібно встановити N8N_ENDPOINT_HEALTH, перш ніж сервіс почне звітувати про здоровий стан.
У Kubernetes офіційний посібник n8n з GKE вимагає кластер «Standard»; за цим посібником, n8n не працює з кластером Autopilot. Той самий посібник каже, що розгортання Postgres потребує постійного тому (persistent volume) для збереження даних між перезапусками подів. Підготуйте цей том, перш ніж почати вимірювати час.
Sources: Deploy to Google Cloud Run | Deploy | n8n Docs, Deploy to Google Kubernetes | Deploy | n8n Docs
Тестування постійного зберігання на кожній платформі
Постійне зберігання — це те місце, де розрив між Cloud Run і Kubernetes проявляється найшвидше, ще до того, як ви дійдете до масштабування воркерів. Виконайте одні й ті самі три події на обох платформах: звичайний перезапуск, повторне розгортання і — лише для Cloud Run — масштабування до нуля. На шляху easy mode у Cloud Run очікуйте втрати даних на кроці масштабування до нуля або повторного розгортання, саме так, як описує офіційний посібник n8n з розгортання. На шляху durable mode Postgres має пережити всі три події, за умови що Secret Manager зберігає деталі з'єднання незмінними між ревізіями, хоча дані цієї вправи не документують цей результат напряму.
У GKE поведінку простіше зрозуміти, коли постійний том із власних маніфестів n8n вже на місці, оскільки саме том, а не под, зберігає стан, згідно з офіційним посібником n8n. Фіксуйте точно те, що відбувається на кожній платформі для кожної події, а не припускайте, що обидві поводитимуться так, як передбачає їхня документація.
| Платформа / режим | Перезапуск | Повторне розгортання | Масштабування до нуля |
|---|---|---|---|
| Cloud Run easy mode | Дані втрачено (документовано) | Дані втрачено (документовано) | Дані втрачено (документовано) |
| Cloud Run durable mode (Postgres) | Не документовано — перевірте самостійно | Не документовано — перевірте самостійно | Не документовано — перевірте самостійно |
| GKE з постійним томом (маніфести n8n) | Том має зберігати дані згідно з посібником n8n | Не документовано — перевірте самостійно | Не застосовується в документованому воркер-налаштуванні n8n |
Sources: Deploy to Google Cloud Run | Deploy | n8n Docs, Deploy to Google Kubernetes | Deploy | n8n Docs
Масштабування воркерів у режимі черги: слабке місце з обох боків
Режим черги знову змінює вимоги до зберігання. Власна документація n8n каже, що запуск режиму черги з базою даних SQLite не рекомендується для self-hosted n8n на жодному хості, і що режим черги не підтримує зберігання бінарних даних у файловій системі. Плануйте перехід на Postgres перед увімкненням режиму черги на будь-якій платформі та перевірте безпосередньо в документації n8n альтернативний варіант зберігання бінарних даних, який там описано, оскільки деталі цієї альтернативи не потрапили до дослідження цієї вправи.
Автомасштабування воркерів — ось де обидві платформи почуваються некомфортно. У публікації на форумі спільноти n8n за липень 2026 року команда, що самостійно розгортає n8n у режимі черги на Cloud Run, повідомила, що автоскейлер Cloud Run повністю «не бачить» глибину черги Redis, тому він ніколи не масштабує воркери під навантаженням; їхнім обхідним рішенням було обмежити кожен воркер одним vCPU і запускати безперервний health-ping, щоб змусити CPU-орієнтований автоскейлер додавати інстанси. Ми вважаємо це обхідне рішення прийнятним тимчасовим заходом, але воно є ознакою того, що стандартний сигнал автомасштабування платформи не відповідає тому, як насправді поводяться воркери n8n.
| Варіант | Сигнал масштабування | Відома обмеженість |
|---|---|---|
| Стандартний автоскейлер Cloud Run | Власний сигнал CPU/конкурентності Cloud Run | За повідомленням однієї команди спільноти, не бачить глибини черги Redis |
| Пули воркерів Cloud Run (GA, квітень 2026) | Немає — фіксована кількість воркерів | Немає автомасштабування і кінцевої точки з балансуванням навантаження, за документацією Google |
| GKE з CPU-орієнтованим HPA | Утилізація CPU пода | За повідомленням спільноти, часто не спрацьовує для воркерів n8n, прив'язаних до I/O |
| GKE з Redis-скейлером KEDA | Довжина черги Redis / Bull | Обговорюється спільнотою, не є офіційним шляхом розгортання n8n |
Kubernetes також не вирішує це автоматично. Учасник обговорення на форумі спільноти n8n за лютий–березень 2026 року пояснив, що воркери n8n прив'язані до вводу-виводу (I/O-bound) — вони чекають на зовнішні відповіді, а не споживають CPU, — тому звичайне CPU-орієнтоване горизонтальне автомасштабування подів (HPA) часто не спрацьовує для масштабування воркерів n8n. Той самий учасник вказав на Redis-скейлер KEDA, який стежить за фактичною довжиною черги, як на альтернативу, яку варто оцінити. Документація підтримуваного спільнотою Helm-чарта n8n також попереджає, що вузли-воркери, які використовують персистентність ReadWriteOnce, не можуть застосовувати автомасштабування, тож вибір зберігання, який ви тестували на попередньому кроці, також може непомітно блокувати масштабування.
Є два новіші шляхи обходу, які варто протестувати, а не просто відкинути. Документація Google щодо GKE стверджує, що GKE версії 1.37 або новішої може налаштувати горизонтальне автомасштабування подів так, щоб масштабувати робоче навантаження до нуля реплік за відсутності попиту, хоча власний посібник n8n з Kubernetes не документує це для подів-воркерів. У Cloud Run пули воркерів (worker pools) досягли загальної доступності (GA) 14 квітня 2026 року, згідно з нотатками про випуск Google, — варіант розгортання без автомасштабування чи URL із балансуванням навантаження, за документацією Google щодо worker pools, — який деякі команди можуть використовувати для більш передбачуваного хостингу воркерів у режимі черги.
На нашу думку, Redis-скейлер KEDA є більш перспективним рішенням із цих двох саме для n8n, оскільки він реагує на те, що справді має значення — глибину черги, — а не на сигнал CPU, який прив'язані до вводу-виводу воркери рідко провокують.
Sources: Enable queue mode | Deploy | n8n Docs, Autoscaling Queue Workers on Google Cloud Run (Redis/BullMQ) – How do you solve the HTTP-blindness? - Feedback - n8n Community, Horizontal Pod autoscaling | Google Kubernetes Engine (GKE) | Google Cloud Documentation, Redis Lists | KEDA, n8n Queue Mode Setup | OpenCharts, N8n Kubernetes Queue Mode: Jobs Not Distributed Across Multiple Workers (HPA/Scaling Not Working) - Questions - n8n Community, Implantar pools de worker no Cloud Run | Google Cloud Documentation, Cloud Run release notes | Google Cloud Documentation
Фіксація вартості в режимі простою
Фіксуйте вартість у режимі простою як два окремі рядки, а не як одне усереднене число. У Cloud Run, за даними сторінки цін Google, прості інстанси, які не є мінімальними інстансами, не оплачуються, тож розгортання n8n з масштабуванням до нуля має показувати нульову вартість обчислень у простої між викликами — якщо ви не закріпите мінімальний інстанс, що радить посібник n8n для durable mode задля зниження ризику втрати даних, і в такому разі цей інстанс оплачується безперервно. Та ж сторінка цін вказує на щомісячний безкоштовний рівень у перші 240 000 vCPU-секунд на місяць для біллінгу на основі CPU інстансів, згідно зі сторінкою цін Cloud Run від Google, що додатково знижує вартість періоду простою для малонавантаженого практичного інстансу.
У GKE, за даними сторінки цін Google, фіксована плата за керування кластером у розмірі 0,10 $ за кластер на годину застосовується до всіх кластерів GKE незалежно від режиму, розміру чи топології, і ця плата нараховується навіть тоді, коли кластер GKE з n8n простоює, на додаток до вартості будь-яких запущених обчислювальних вузлів. Ця фіксована плата — це той рядок, якого в Cloud Run немає взагалі, і його варто фіксувати окремо, а не змішувати в одну загальну цифру «вартість GKE».
| Платформа | Рядок вартості в простої | Примітка |
|---|---|---|
| Cloud Run, без мінімальних інстансів | Немає плати за обчислення в простої, за сторінкою цін Google | Перші 240 000 vCPU-секунд на місяць безкоштовні |
| Cloud Run, із закріпленим мінімальним інстансом | Безперервна плата за цей інстанс | Рекомендація durable mode — закріпити один для знижен ризику втрати даних |
| GKE | Фіксована плата 0,10 $ за кластер на годину | Застосовується незалежно від режиму, розміру чи топології, плюс вартість запущених вузлів |
Sources: Cloud Run pricing | Google Cloud, Google Kubernetes Engine pricing | Google Cloud
Критерії завершення та рекомендована рефлексія
Вправу вважається завершеною, коли для обох платформ у вас є: зафіксований час холодного старту й перезапуску, заповнена власними тестами таблиця постійного зберігання, протестована (або хоча б випробувана) конфігурація масштабування воркерів у режимі черги та два окремі рядки вартості в простої, розбиті так, як показано вище.
Рекомендована рефлексія, а не перевірений висновок: команди з невеликим досвідом Kubernetes можуть вважати durable mode Cloud Run швидшим для запуску, тоді як команди, що вже використовують GKE для інших навантажень, можуть легше змиритися з платою за кластер і обмеженнями worker pools, ніж із переходом на нову безсерверну платформу. Ухвалення цього рішення Cloud Run проти Kubernetes для продакшну, ймовірно, менше залежить від часу запуску чи вартості в простої і більше — від того, з яким режимом відмови масштабування воркерів ваша команда готова жити й справлятися, оскільки стандартні налаштування жодної з платформ наразі чітко не працюють для режиму черги n8n.