El modo cola de n8n no funciona: lista de verificación para solucionarlo
Lista práctica para cuando el modo cola de n8n no funciona: workers sanos pero trabajos bloqueados. Cubre EXECUTIONS_MODE, Redis y la salud de los workers.
Comprobado con las fuentes citadas el .
Antes de empezar: confirma el síntoma y recopila los datos de la instancia
Si estás viendo que el modo cola de n8n no funciona —los workers aparecen en línea, pero los trabajos se quedan en la cola o nunca salen del estado 'en ejecución'— resiste la tentación de reiniciar todo primero. Dedica cinco minutos a confirmar qué estás viendo exactamente: qué workflow y tipo de trigger está afectado, cuánto tiempo llevan atascados los trabajos, y si el bloqueo comenzó tras un despliegue, un reinicio de Redis o sin ningún cambio del que tengas constancia. Anota tu versión de n8n, tu configuración de EXECUTIONS_MODE en main y en cada worker, y si ejecutas single-main o multi-main, antes de revisar las comprobaciones siguientes.
Tener estos datos a mano convierte cada comprobación en una comparación rápida en lugar de una investigación nueva, y suele ser la diferencia entre una solución de cinco minutos y una tarde entera de suposiciones.
Comprobación 1-2: ¿El modo cola de n8n no funciona por EXECUTIONS_MODE o por Redis?
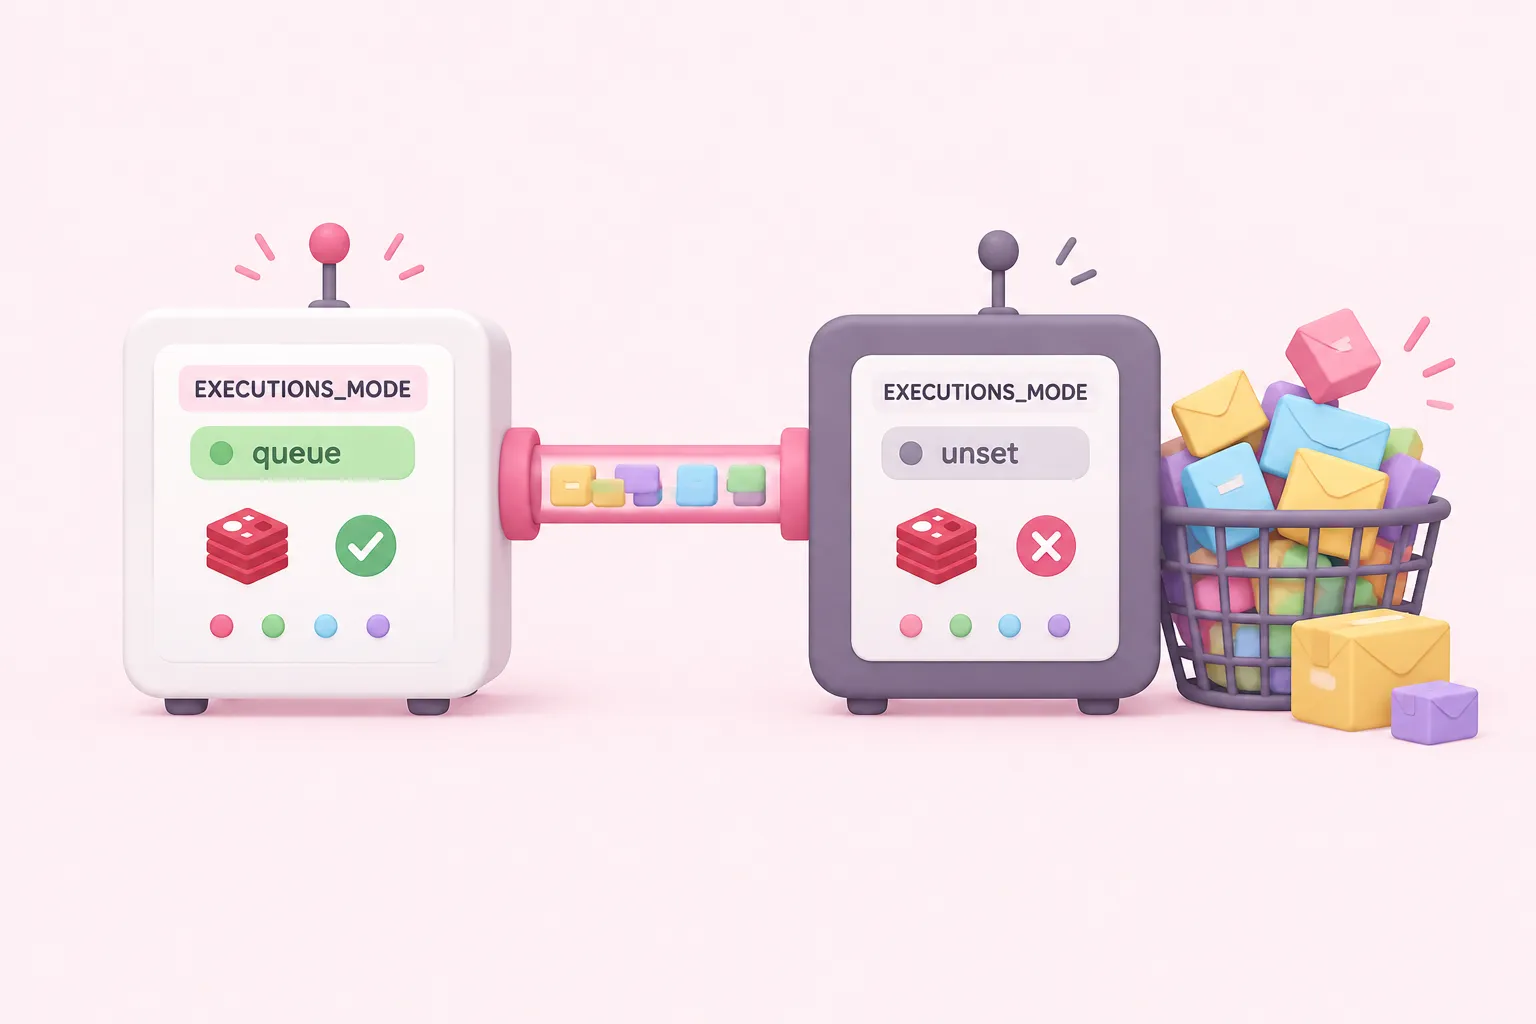
El modo cola de n8n no funciona a menudo se remonta a un único ajuste desalineado: si EXECUTIONS_MODE=queue está configurado de la misma manera en el proceso main y en cada worker. El modo cola depende de que ese ajuste coincida en todos los procesos. Una entrada de blog de proveedor de 2026 de Elestio describe qué ocurre cuando esto se pasa por alto: cuando EXECUTIONS_MODE=queue está configurado en el proceso main pero no está definido, o está configurado de otra forma, en un worker, ese worker nunca llega a mirar la cola de Redis. Las ejecuciones siguen corriendo localmente en main, la cola permanece vacía, y los workers que ves como 'activos' son procesos sanos que no hacen nada útil.
Ayuda ver qué debería hacer en cambio una configuración correcta. Como lo describe Yulia Dmitrievna, miembro del equipo de n8n, en el Blog de n8n,
Una vez confirmado EXECUTIONS_MODE en cada proceso, comprueba si main y cada worker pueden realmente alcanzar Redis. La referencia oficial de variables de entorno de n8n documenta QUEUE_BULL_REDIS_TIMEOUT_THRESHOLD como el tiempo de espera configurable para esa conexión, que vale la pena comparar con tu latencia de red real, especialmente entre contenedores, VPC o regiones.
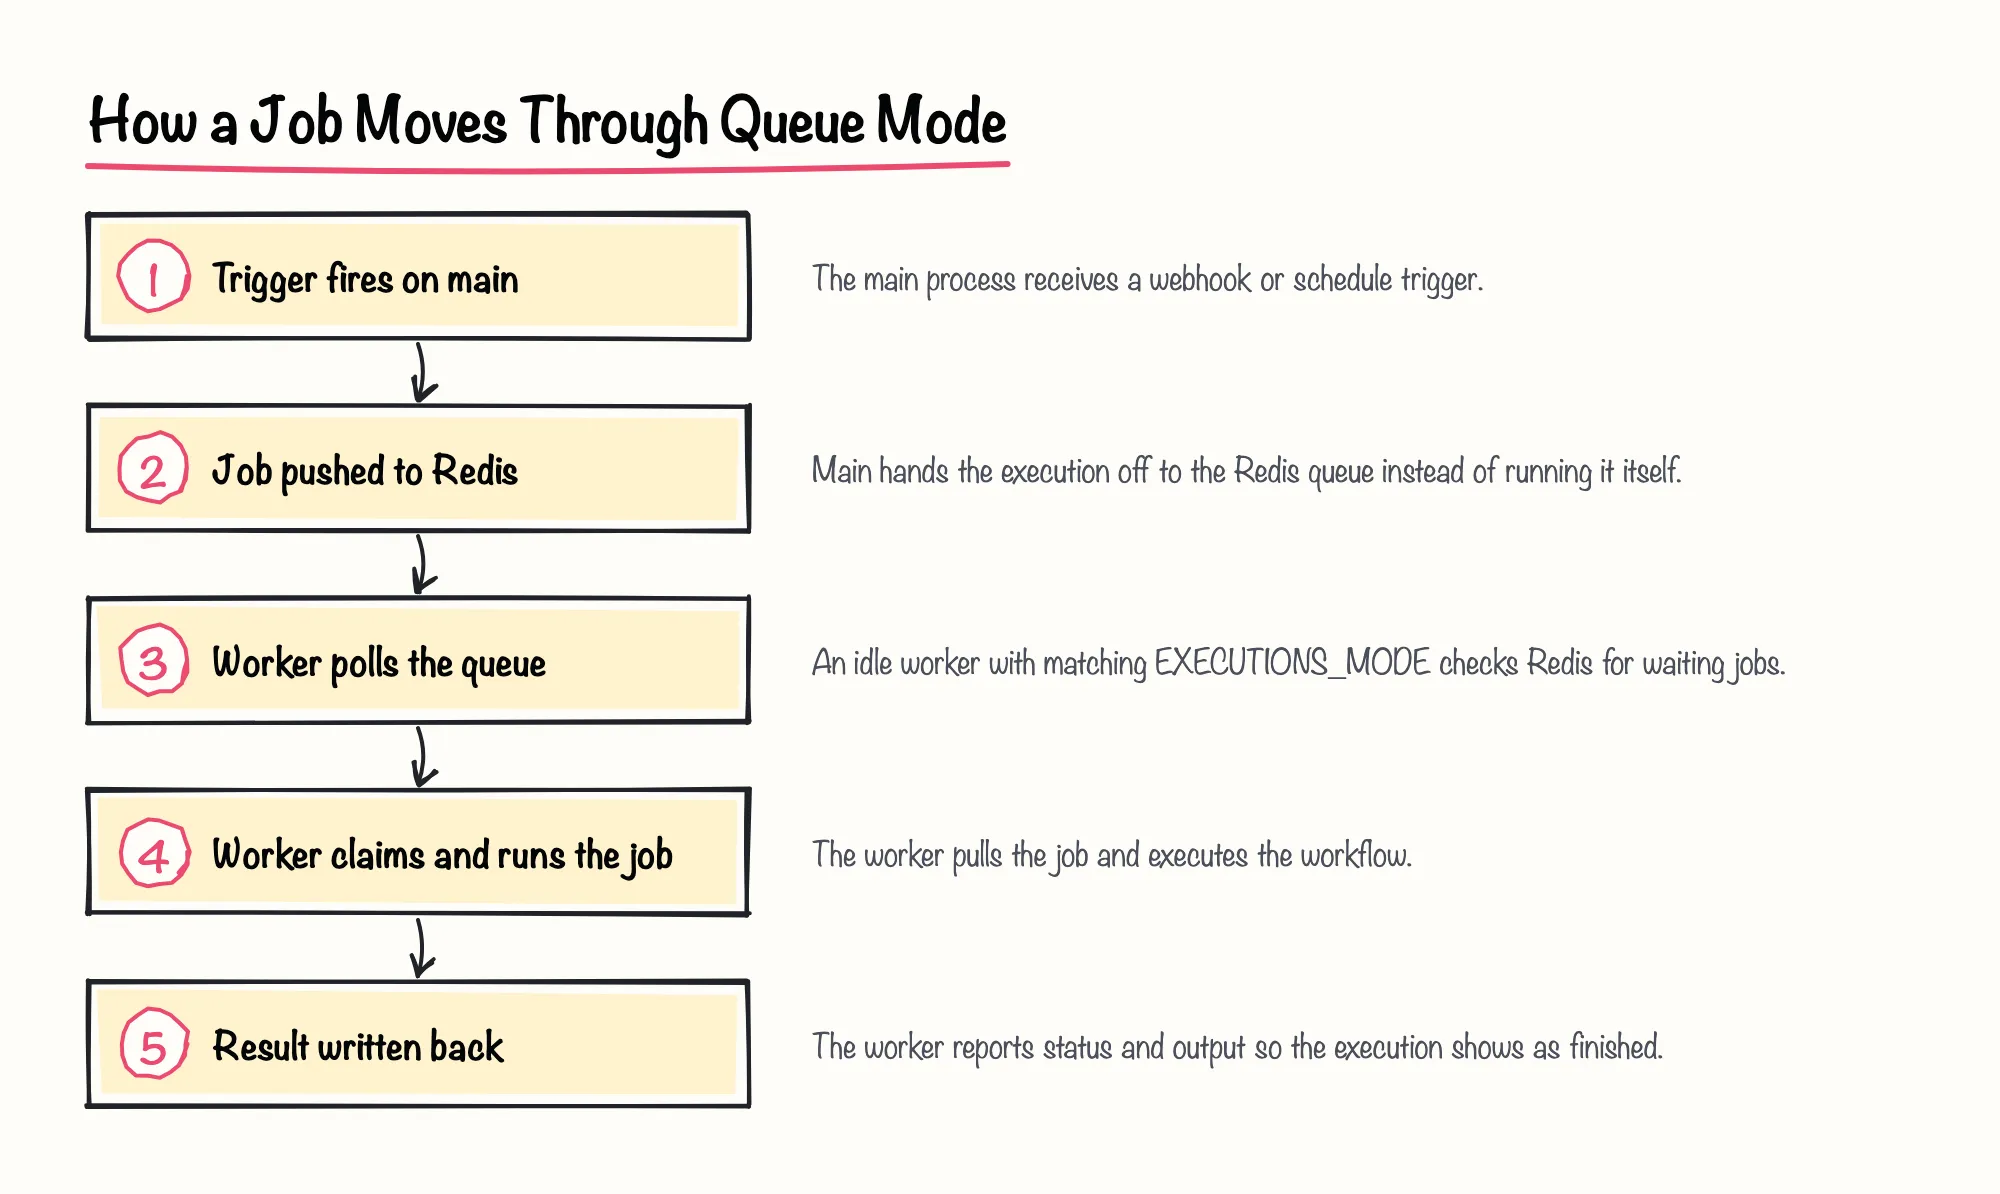
Nosotros trataríamos artículos como el de Elestio como una segunda opinión útil, no como el primer lugar donde buscar: describen síntomas reales de producción, pero los requisitos del modo y de las variables en sí provienen directamente de la propia documentación de n8n, así que consúltala primero.
Sources: How to Scale n8n with Redis Queue Mode for Parallel Workflow Execution, Queue mode | Deploy | n8n Docs
Comprobación 3-4: discrepancias en la clave de cifrado y salud de los workers
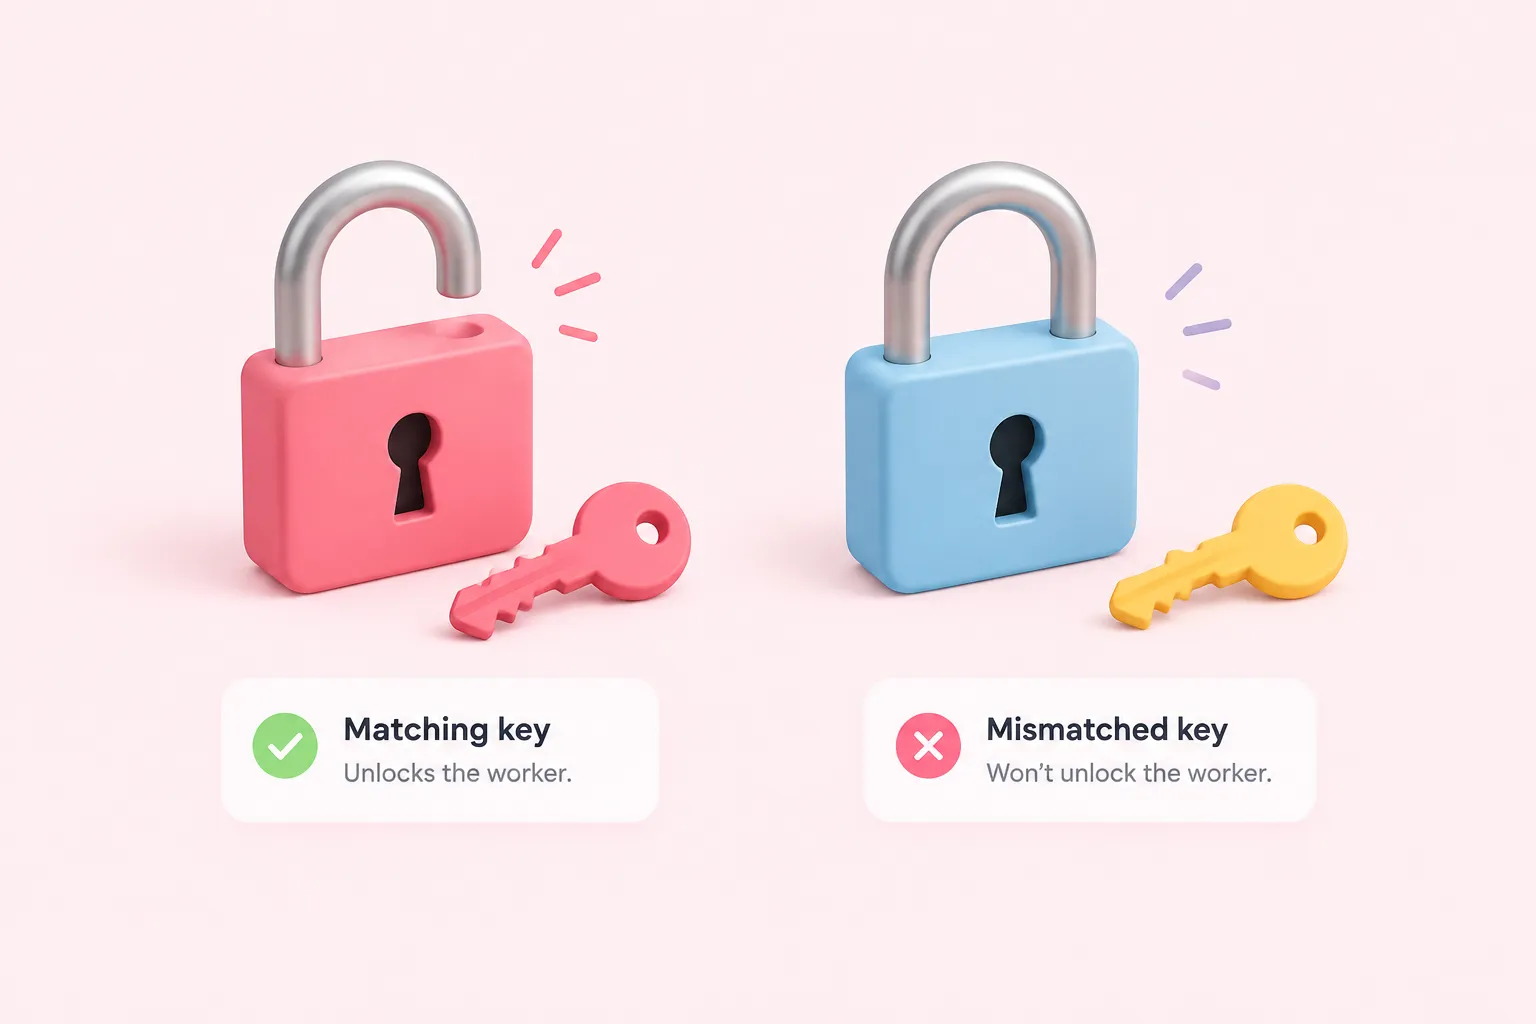
Una segunda causa, más difícil de detectar, es una discrepancia en la clave de cifrado. Una entrada de blog de proveedor de 2026 de Elestio afirma que cuando N8N_ENCRYPTION_KEY difiere entre main y un worker, cualquier workflow que use credenciales almacenadas falla de forma silenciosa: un worker que no puede descifrar una credencial simplemente no puede ejecutar el nodo que la necesita, sin nada evidente que señale hacia la clave en sí.
A continuación, confirma que los workers están realmente registrados, no solo en ejecución. La documentación oficial de n8n señala que ver los workers conectados a través de Settings > Workers en la interfaz es una función de Enterprise autoalojado, por lo que los equipos en la edición Community no tendrán esa vista y necesitan otra forma de comprobar la salud de los workers.
Esa otra forma son los propios endpoints de salud de n8n, y se comportan de manera distinta según lo que estés inspeccionando. La documentación oficial de monitorización indica que, para los servidores worker en modo cola, el endpoint de comprobación de salud está desactivado por defecto, a diferencia del endpoint del servidor main, que siempre está activo. Por separado, el endpoint de preparación (readiness) de un worker informa si las conexiones de base de datos y Redis de ese worker están listas, pero solo una vez activado QUEUE_HEALTH_CHECK_ACTIVE.
| Endpoint | Estado por defecto | Qué informa |
|---|---|---|
| Endpoint de salud del servidor main | Activado por defecto | Confirma que el proceso main está en funcionamiento |
| Endpoint de salud del worker | Desactivado por defecto | Confirma que un proceso worker está en funcionamiento, una vez activado |
| Endpoint de preparación del worker | Opcional mediante QUEUE_HEALTH_CHECK_ACTIVE | Si las conexiones de BD y Redis de ese worker están listas |
| Interfaz de Settings > Workers | Solo Enterprise autoalojado | Lista en vivo de los workers conectados |
Sources: How to Scale n8n with Redis Queue Mode for Parallel Workflow Execution, Enable queue mode | Deploy | n8n Docs, Monitor n8n | Deploy | n8n Docs
Comprobación 5-6: ajustes de concurrencia y programación de triggers
Si los workers están sanos y son accesibles pero los trabajos siguen acumulándose, mira a continuación la concurrencia. La documentación oficial de n8n recomienda fijar la concurrencia del worker en 5 o más, y advierte que combinar muchos workers con una concurrencia muy baja puede agotar el pool de conexiones de tu base de datos en lugar de acelerar algo.
Comprueba también N8N_CONCURRENCY_PRODUCTION_LIMIT en el proceso main. La documentación oficial indica que, en modo cola, esta variable sobrescribe el flag --concurrency de un worker siempre que esté configurada con un valor distinto de -1, de modo que un valor bajo olvidado aquí puede limitar silenciosamente el rendimiento sin importar cómo estén configurados los workers individuales.
Miembros de la comunidad informan en una publicación de Medium de 2026 que ver los trabajos acumularse exactamente en tu límite de concurrencia, con la cola de espera todavía creciendo, es la señal más clara de que necesitas más workers en lugar de más ajustes. En nuestra opinión, ese es el orden correcto para razonar: descarta primero las discrepancias de configuración, y añade capacidad de worker solo una vez que hayas confirmado que el cuello de botella es realmente de rendimiento.
Por último, si los propios triggers han dejado de activarse en lugar de haber trabajos sin ejecutar, comprueba el liderazgo. La documentación oficial del durable scheduler de n8n indica que, en una configuración multi-main, solo la instancia líder dispara las programaciones, por lo que perder el liderazgo puede parecer idéntico a que el modo cola esté roto. Donde el durable scheduler y sus métricas de Prometheus están habilitados, un valor creciente de n8n_scheduler_oldest_pending_age_seconds, o un recuento distinto de cero de n8n_scheduler_tasks_due, apuntan ambos a la programación, y no a la ejecución, como el problema real.
- Los trabajos quedan sin ejecutar mientras la concurrencia está por debajo del límite de tu worker: probablemente un problema de programación o de liderazgo, no de concurrencia.
- Los trabajos se acumulan exactamente en tu tope de concurrencia, con los elementos en espera creciendo: probablemente capacidad real insuficiente, considera añadir más workers.
- No aparecen nuevas ejecuciones para workflows programados: comprueba primero el liderazgo multi-main.
Sources: Enable queue mode | Deploy | n8n Docs, Control concurrency | Deploy | n8n Docs, n8n Queue Mode Explained: Setup, Scaling, Monitoring | Medium, Durable scheduler | Deploy | n8n Docs
Comprobación 7 y monitorización continua: trabajos bloqueados y cómo detectarlo antes
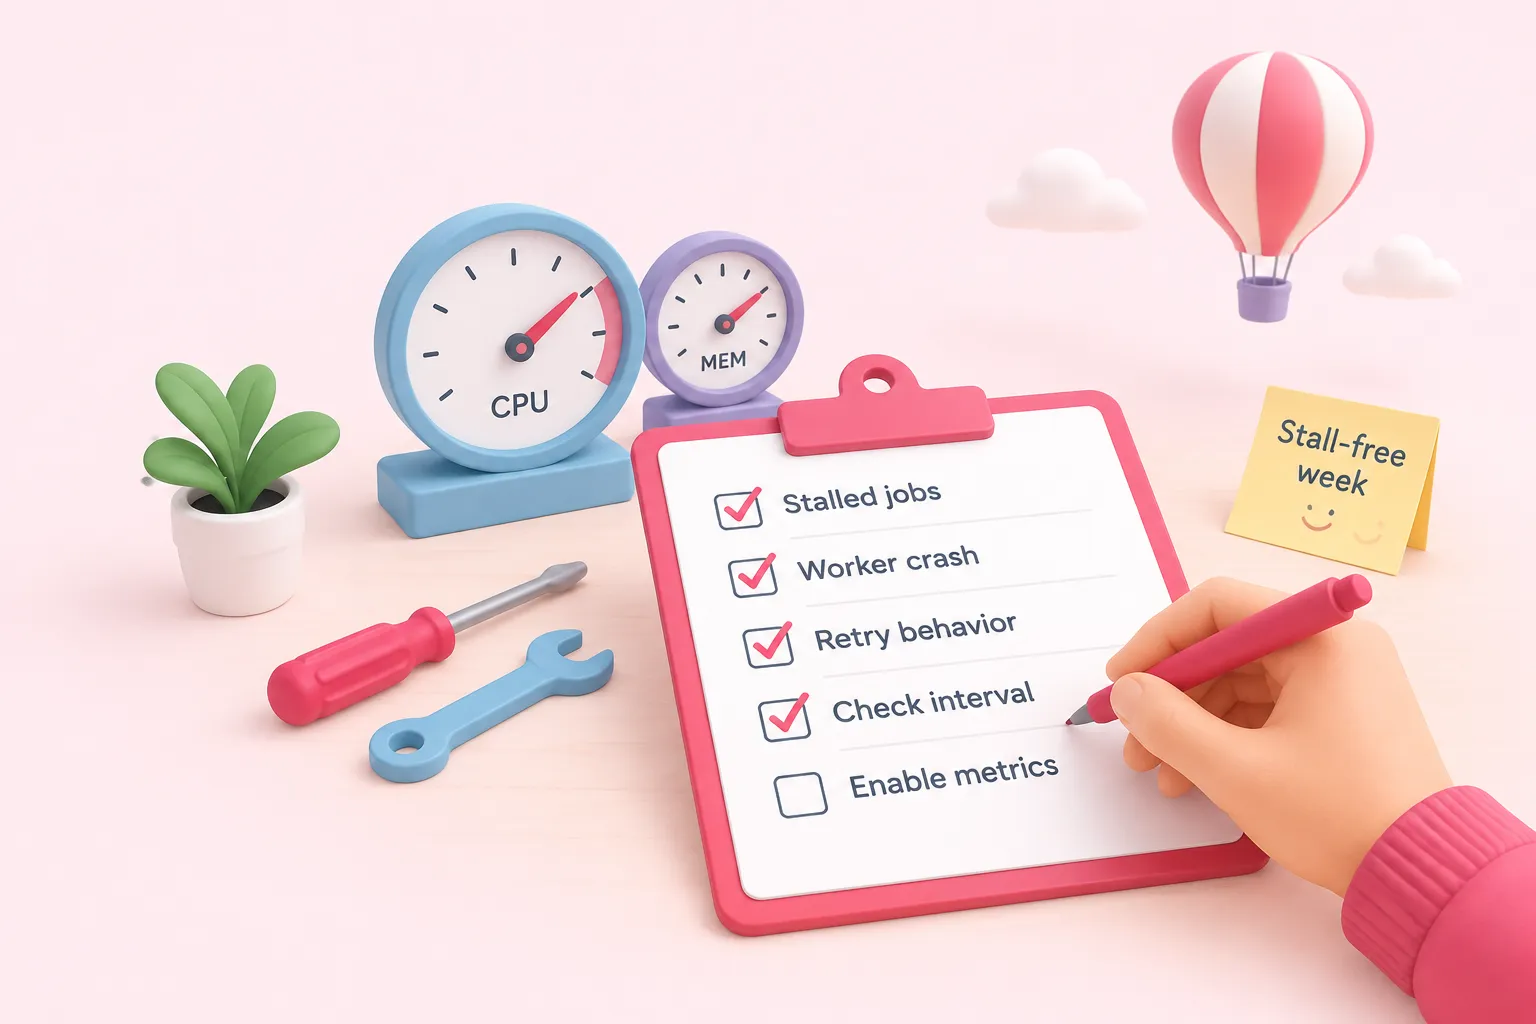
No todos los casos de modo cola de n8n no funciona provienen de la configuración; algunos provienen de trabajos que empezaron pero nunca terminaron. Una entrada de blog de proveedor de 2026 de Elestio afirma que las ejecuciones atascadas indefinidamente en el estado 'en ejecución' suelen deberse a un worker que falla a mitad de la ejecución, dejando el trabajo huérfano sin nada que actualice su estado.
Miembros de la comunidad informan en una publicación de Medium de 2026 que, cuando esto ocurre, el trabajo en curso se marca como 'stalled' (bloqueado) en Redis y más tarde lo reintenta otro worker. La propia referencia de variables de entorno de n8n documenta QUEUE_WORKER_STALLED_INTERVAL como el ajuste que controla cada cuánto un worker comprueba este tipo exacto de trabajo bloqueado, algo que vale la pena revisar si los reintentos te parecen demasiado lentos o demasiado agresivos para tu carga de trabajo.
Creemos que vale la pena activar los endpoints de salud y métricas antes de estar en medio de un incidente, no después. La documentación oficial de monitorización de n8n señala que el endpoint /metrics está desactivado por defecto en las instancias autoalojadas y debe activarse explícitamente, así que una semana sin bloqueos es precisamente el momento adecuado para activarlo, no la noche en que algo se atasca.
Sources: How to Scale n8n with Redis Queue Mode for Parallel Workflow Execution, n8n Queue Mode Explained: Setup, Scaling, Monitoring | Medium, Queue mode | Deploy | n8n Docs, Monitor n8n | Deploy | n8n Docs, Enable queue mode | Deploy | n8n Docs