Приклади n8n, які навчають відстежувати збій, а не просто перелічувати ноди
Ці приклади n8n навчають відстежувати збій від тригера до результату за допомогою інструментів налагодження n8n, error workflows і закріплення даних.
Перевірено за наведеними джерелами .
Що відрізняє приклади налагодження n8n від переліку нод
Якщо шукати приклади n8n в інтернеті, більшість результатів пояснює, що робить кожна нода окремо: ця отримує дані, та перетворює їх, ще одна надсилає повідомлення. Це корисно як глосарій, але не показує, що насправді важливо, коли щось ламається — як рухатися назад від неправильного результату, крізь ланцюжок нод, до тригера, що запустив виконання.
Приклад із налагодження — це інше. Він показує, як насправді виглядало невдале виконання, яка нода створила неочікувані дані і як ви це підтвердили. Мало які приклади n8n роблять це явно, адже це означає показати помилку, а не охайний готовий воркфлоу. Розділи нижче вказують на інструменти, які роблять таке відстеження можливим, і на те, де їхня власна документація не доходить до повністю розібраного реального збою.
n8n Balloon Challenges, практичний навчальний сайт, на якому базується цей гайд, будує свої уроки так само: ви обираєте завдання, самостійно будуєте воркфлоу і зараховуєте його лише після того, як ментор перевірить вашу робочу версію. Такий формат змушує вас отримати реальне виконання, яке можна простежити, а не просто прочитати його опис.
Sources: Hands-on n8n Automation Challenges · n8n Balloon Challenges
Вбудовані інструменти: Debug in Editor, Copy to Editor та Error Workflows
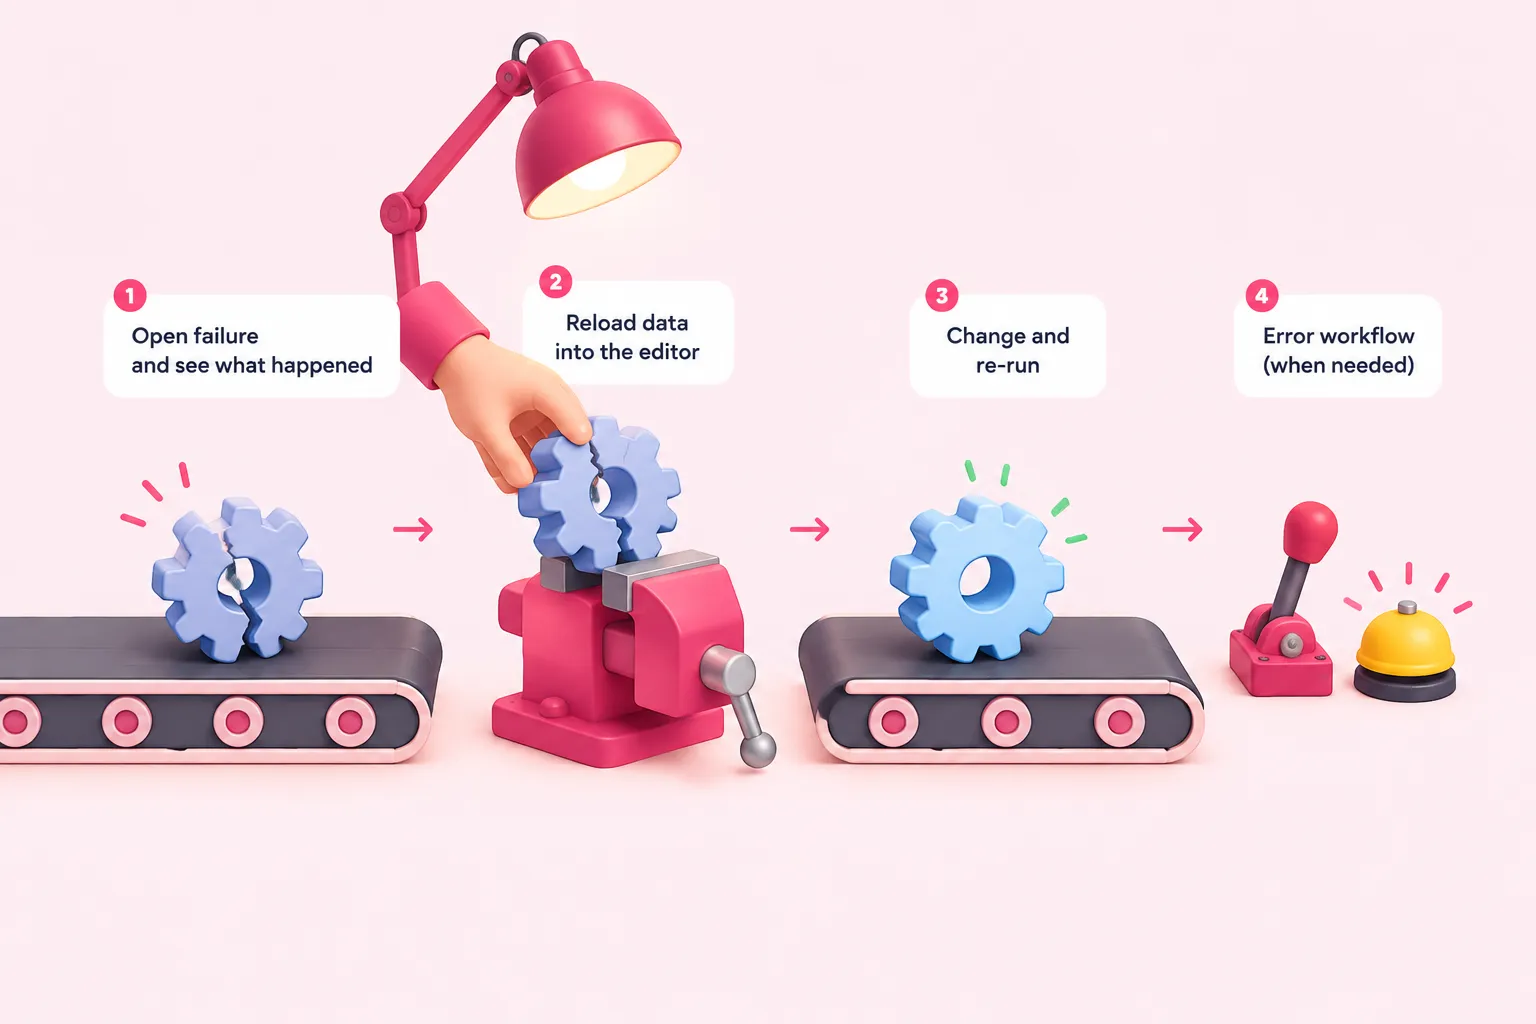
Офіційна документація n8n описує прямий спосіб відстежити збій: коли виконання завершується невдачею, ви можете відкрити його, побачити, що саме сталося, і завантажити ці дані назад у редактор, щоб змінити воркфлоу та запустити його повторно на тих самих вхідних даних. Це основний механізм відстеження збою замість здогадок — ви налагоджуєте на тих точних даних, які спричинили помилку, а не на новому запуску, що може поводитися інакше. Ми вважаємо, що варто опанувати цей вбудований механізм повторного відтворення ще до звернення до будь-якого стороннього інструменту, адже він відповідає на питання, з якого насправді починається більшість налагоджень: що отримав воркфлоу і де саме щось пішло не так.
Для збоїв, про які потрібно комусь повідомити або які мають запускати запасний сценарій, n8n вимагає окрему ноду Error Trigger на початку окремого воркфлоу обробки помилок, перш ніж спрямовувати до нього збої. Практикувати цей патерн простіше, ніж здається: n8n також має ноду Stop And Error, яку можна додати в будь-який воркфлоу, щоб примусово викликати збій за командою — це зручний спосіб створити збій для відстеження, не чекаючи на справжній.
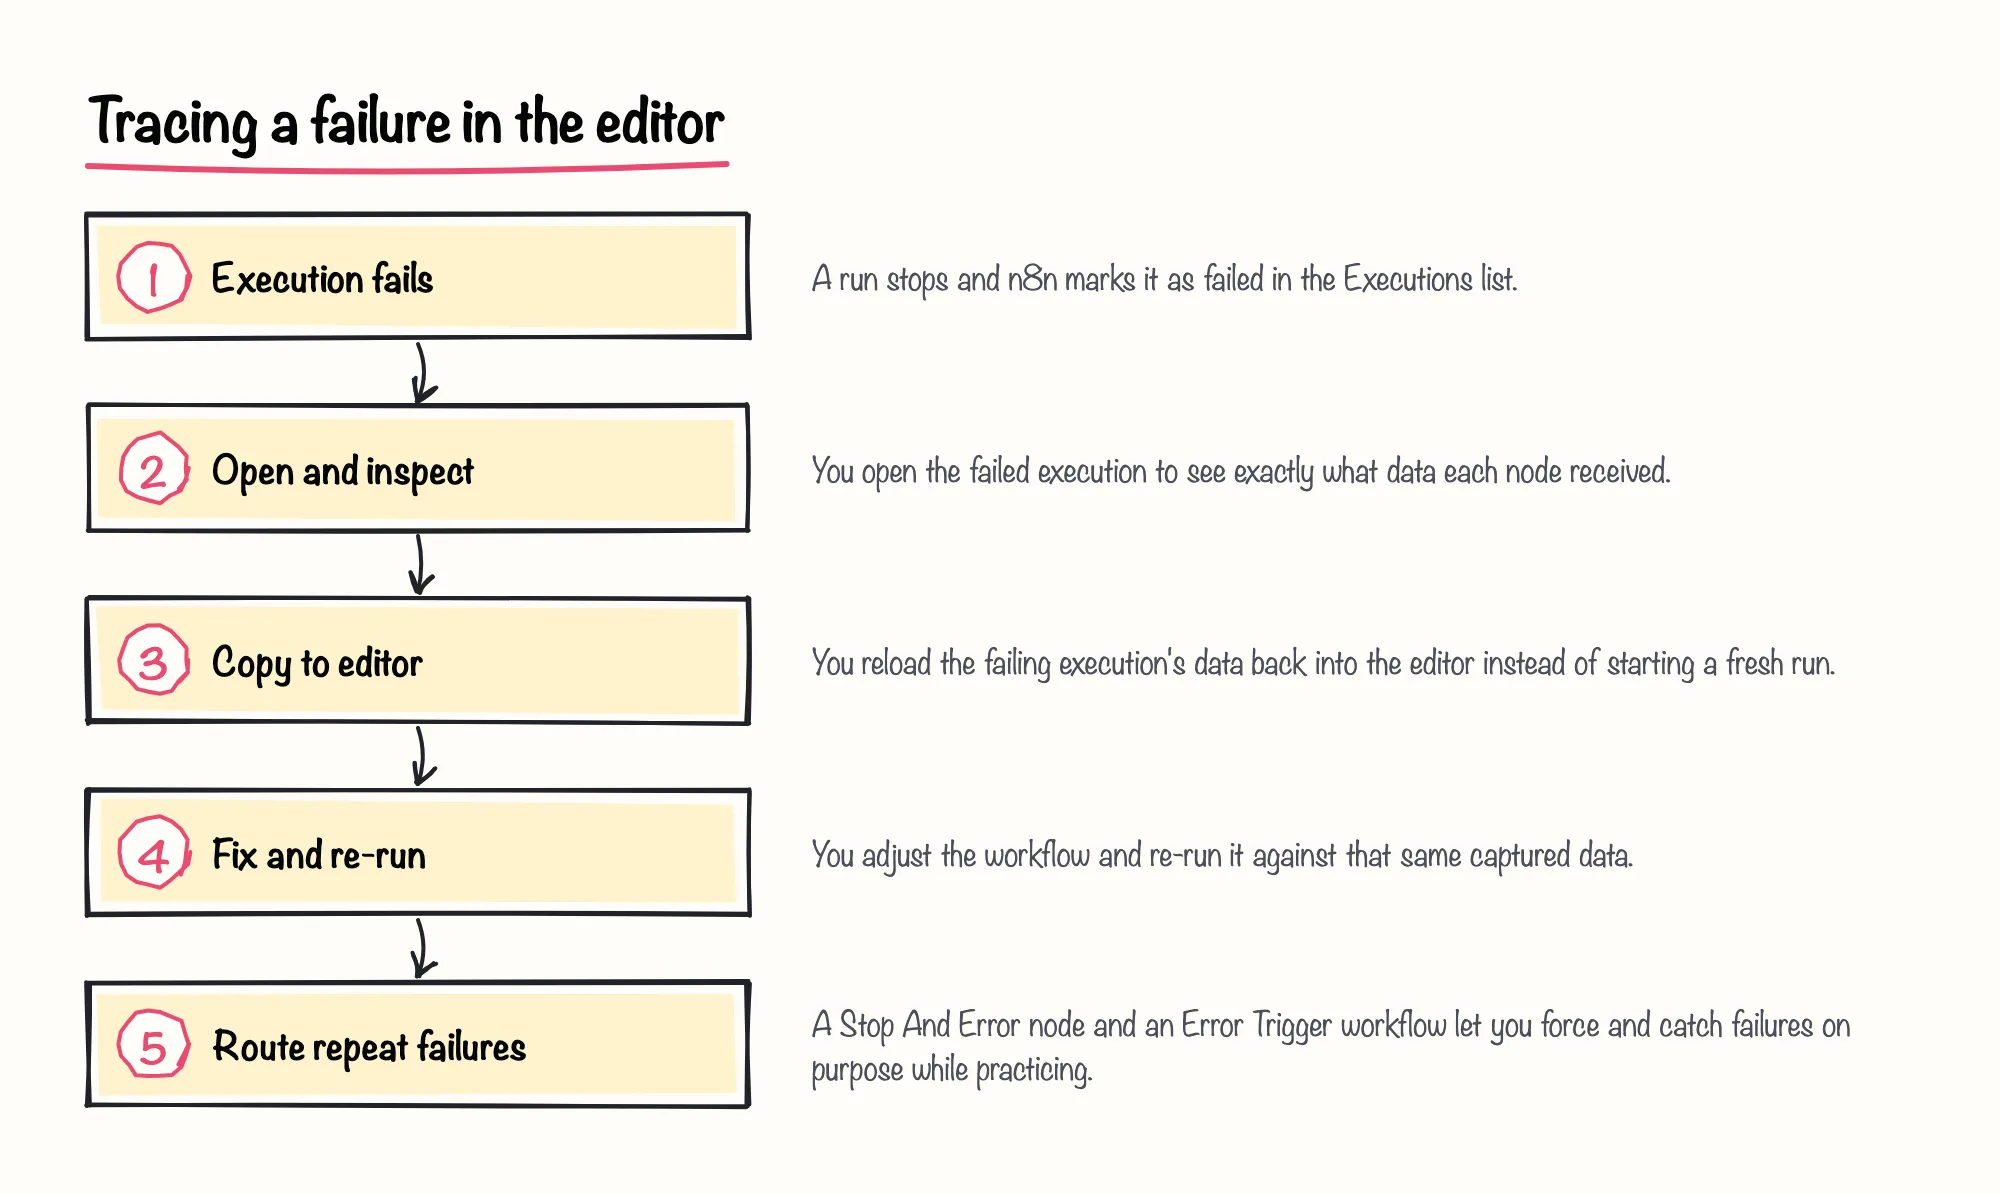
Жодна з цих документацій не розбирає один конкретний збій від початку до кінця; вони лише описують, що робить кожен інструмент, а застосувати їх до реального зламаного мапінгу — ваше завдання. Саме для цього й потрібна практика на власному воркфлоу, про що йдеться в одному з наступних розділів.
Sources: Debug executions | Build | n8n Docs, Handle errors gracefully | Build | n8n Docs
Локалізація збою: закріплення даних і покроковий шаблон
Коли ви підозрюєте, що проблема саме в конкретній ноді, закріплення даних (data pinning) дозволяє заморозити вихідні дані цієї ноди і повторно використовувати їх у кожному наступному запуску замість отримання нових даних щоразу. Це перетворює довгий ланцюжок на щось, що можна проходити нода за нодою, адже все, що перед нею, залишається незмінним, поки ви коригуєте те, що йде після. Закріплення працює лише під час розробки в редакторі, а не в реальних продакшн-виконаннях, тож це інструмент для локалізації збою під час побудови воркфлоу, а не для відстеження того, що вже стався в продакшні.
Якщо ви радше підете за покроковим посібником, ніж розбиратиметеся самостійно, галерея шаблонів n8n містить інтерактивний урок, надісланий учасником спільноти, у якому ви безпосередньо перевіряєте вхідні й вихідні дані кожної ноди та використовуєте console.log() у нодах Code, щоб спостерігати, як дані насправді змінюють форму під час руху. Оскільки це матеріал від спільноти, а не офіційний туторіал, ми радимо сприймати його як гарну розминку, а не як єдиний урок про рух даних, який вам потрібен.
Sources: Pin and mock data | Build | n8n Docs, Learn n8n interactively, lesson 1: data flow, execution & debugging | n8n workflow template
Практикуйте відстеження самостійно: створіть завдання, а потім зламайте його
Найнадійніший спосіб навчитися відстежувати збій — створити щось невелике, навмисно зламати це і знайти власну помилку. Сприймайте це як маленькі проєкти n8n, які можна безпечно ламати: ставки низькі, і ви вже знаєте, де саме заховали баг. Якщо хочете вивчити воркфлоу, який уже містить елементи обробки збоїв, завдання «Нехай ресторанні замовлення рухаються далі» на цьому сайті використовує ноди Manual Trigger, HTTP Request, Loop Over Items, Wait, Data Table та Error Trigger, щоб відновлювати замовлення з API, яке обмежує частоту запитів і непередбачувано падає.
Кілька інших завдань для початківців на цьому сайті, як-от «Якість повітря у Валенсії», також містять готовий розв'язок для порівняння після того, як ви зробите власну спробу, щоб звірити ваше власне відстеження з чиєюсь робочою версією. Це перетворює практичні завдання на приклади n8n, з яких ви дійсно вчитеся, а не просто читаєте про них.
Sources: Debug executions | Build | n8n Docs, Handle errors gracefully | Build | n8n Docs, Pin and mock data | Build | n8n Docs
Коли командам потрібна спеціалізована обсерваційність — і які тут компроміси
Коли команда запускає в продакшні багато воркфлоу, відстеження одного збою в редакторі перестає бути достатнім; потрібно бачити закономірності в багатьох виконаннях. У публікації учасника спільноти за 2026 рік описано створення окремого інструментарію обсерваційності навколо n8n — трасування виконань для кожного воркфлоу, дослідник метрик і аудит-логування — як спосіб спостерігати за збоями в багатьох запусках одночасно, а не по одному. Оскільки це одна самопрезентаційна публікація про власний інструмент автора, варто сприймати її як один із підходів спільноти, а не як приклад, задокументований у n8n.
Для команди, яка ще вчиться відстежувати один окремий збій, такий інструментарій — це варіант для пізнішого етапу, а не відправна точка. Ми б пропустили його, доки вбудований потік налагодження та воркфлоу обробки помилок, описані вище, не стануть звичною справою, і зверталися б до додаткової обсерваційності лише тоді, коли доведеться налагоджувати десятки виконань одночасно, а не одне.
Sources: Show HN: N8n-trace – Grafana-like observability for n8n workflows - DEV Community