Ejemplos de n8n que te enseñan a rastrear un fallo, no solo a enumerar nodos
Estos ejemplos de n8n enseñan a rastrear un fallo del disparador a la salida, usando depuración, flujos de error y fijación de datos de n8n.
Comprobado con las fuentes citadas el .
Qué diferencia a los ejemplos de depuración en n8n de una lista de nodos
Busca ejemplos de n8n en internet y la mayoría de lo que aparece explica qué hace cada nodo por separado: este obtiene datos, aquel los transforma, otro envía un mensaje. Eso es útil como glosario, pero no muestra lo que importa cuando algo realmente se rompe: cómo retroceder desde una salida incorrecta, a través de la cadena de nodos, hasta el disparador que inició la ejecución.
Un ejemplo de depuración es distinto. Recorre cómo fue realmente una ejecución fallida, qué nodo produjo los datos inesperados y cómo lo confirmaste. Pocos ejemplos de n8n hacen esto de forma explícita, porque implica mostrar un error en lugar de un flujo de trabajo terminado y limpio. Las secciones siguientes señalan las herramientas que hacen posible ese tipo de rastreo, y dónde su propia documentación se queda corta de un fallo completo y trabajado.
n8n Balloon Challenges, el sitio de aprendizaje práctico detrás de esta guía, estructura sus lecciones de la misma manera: eliges un reto, construyes el flujo de trabajo tú mismo, y solo lo recoges una vez que un mentor ha revisado tu versión funcionando. Ese formato te obliga a producir una ejecución real que puedas rastrear, no solo leer la descripción de una.
Sources: Hands-on n8n Automation Challenges · n8n Balloon Challenges
Herramientas integradas: depurar en el editor, copiar al editor y flujos de error
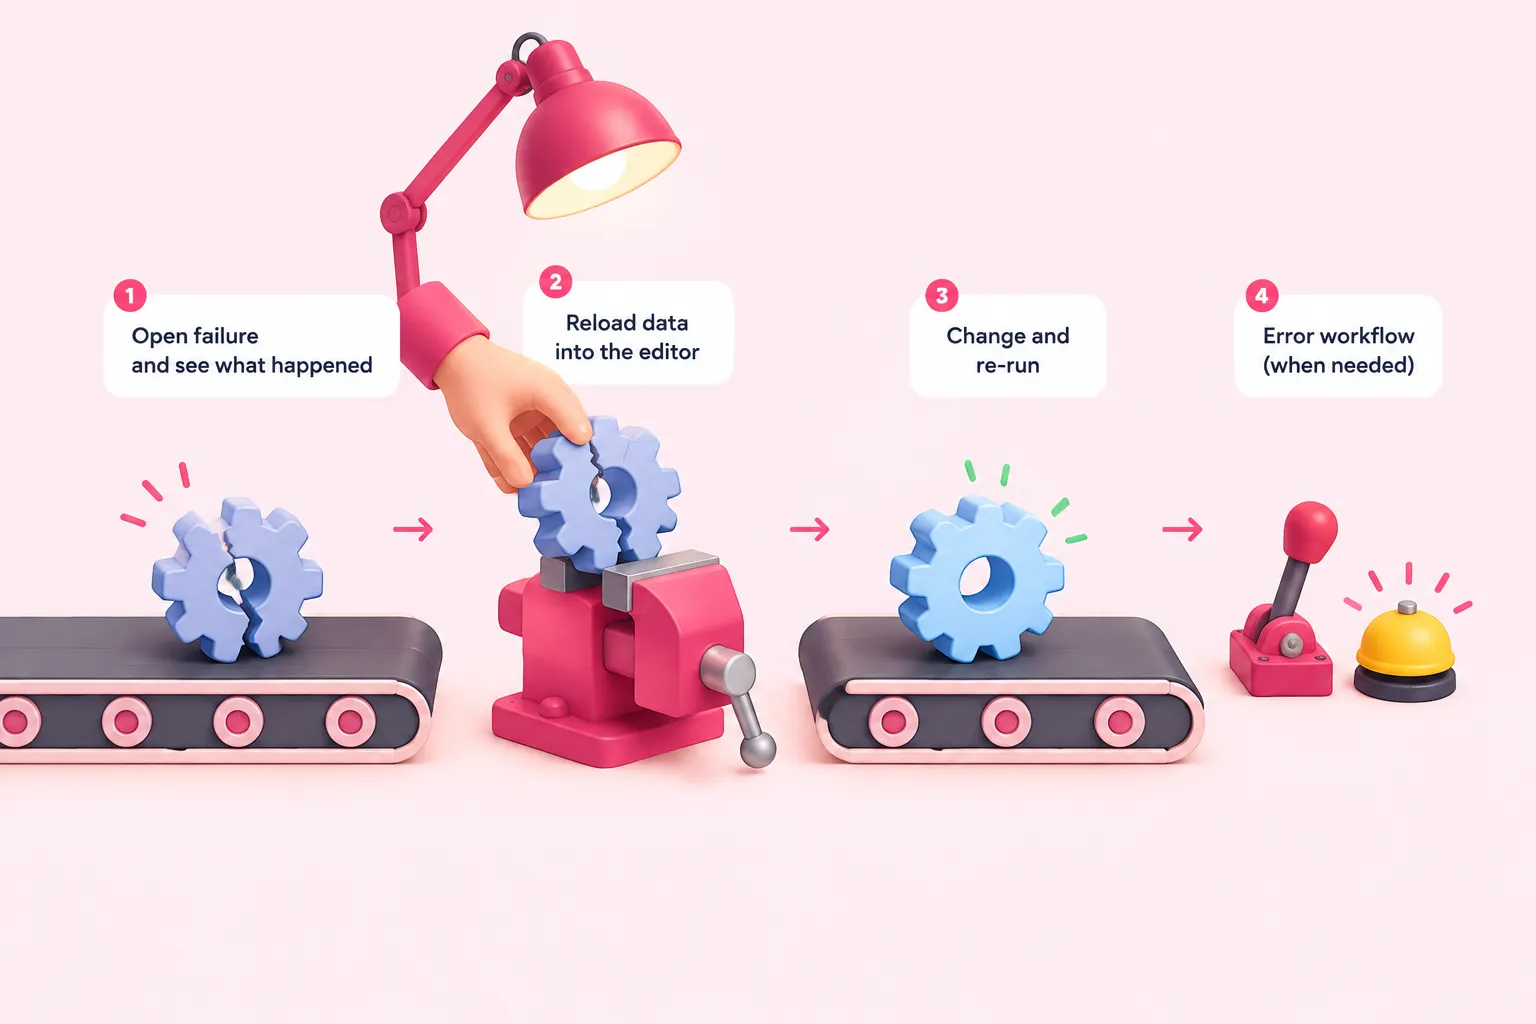
La propia documentación de n8n describe una forma directa de rastrear un fallo: cuando una ejecución falla, puedes abrirla, ver exactamente qué pasó y recargar sus datos de vuelta en el editor para poder cambiar el flujo de trabajo y volver a ejecutarlo con la misma entrada. Ese es el mecanismo central para rastrear un fallo en lugar de adivinarlo: estás depurando con los datos exactos que causaron el error, no con una ejecución nueva que podría comportarse de otra manera. Creemos que vale la pena aprender esta repetición integrada antes de recurrir a cualquier herramienta de terceros, porque responde a la pregunta con la que suele empezar la mayoría de la depuración: qué recibió el flujo de trabajo y dónde se equivocó.
Para los fallos que deberían notificar a alguien o activar una alternativa, n8n exige un nodo Error Trigger dedicado al inicio de un flujo de trabajo de error independiente antes de enrutar los fallos hacia él. Practicar este patrón es más fácil de lo que parece: n8n también incluye un nodo Stop And Error que puedes colocar en cualquier flujo de trabajo para forzar que falle a voluntad, lo cual es una forma conveniente de generar un fallo que rastrear sin esperar a que ocurra uno real.
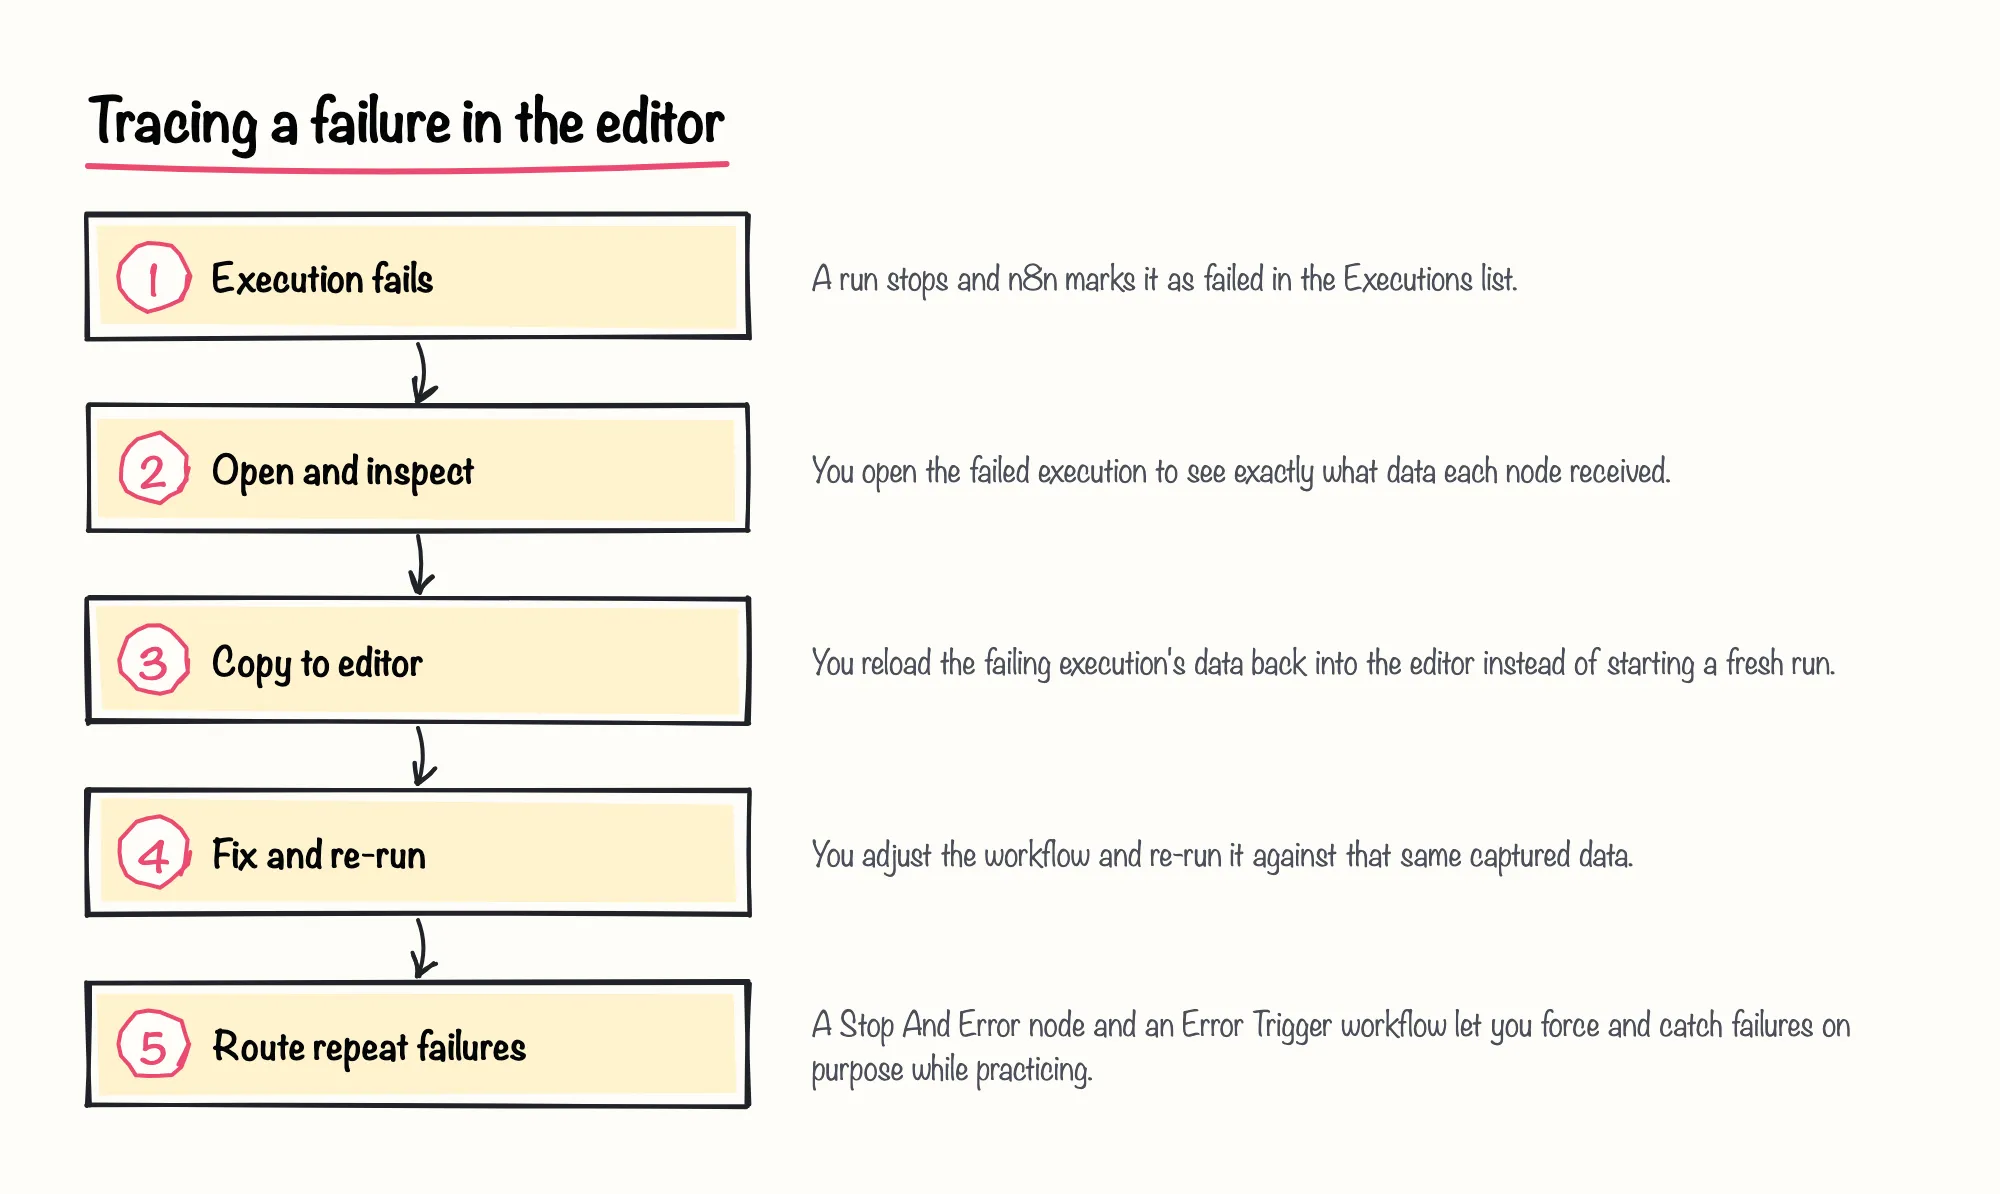
Ninguna de estas documentaciones recorre un fallo específico de principio a fin; describen qué hace cada herramienta, y depende de ti aplicarlas a un mapeo realmente roto. Ese vacío es exactamente para lo que sirve practicar con tu propio flujo de trabajo, algo que cubre una sección posterior.
Sources: Debug executions | Build | n8n Docs, Handle errors gracefully | Build | n8n Docs
Aislar el fallo: fijación de datos y una plantilla guiada
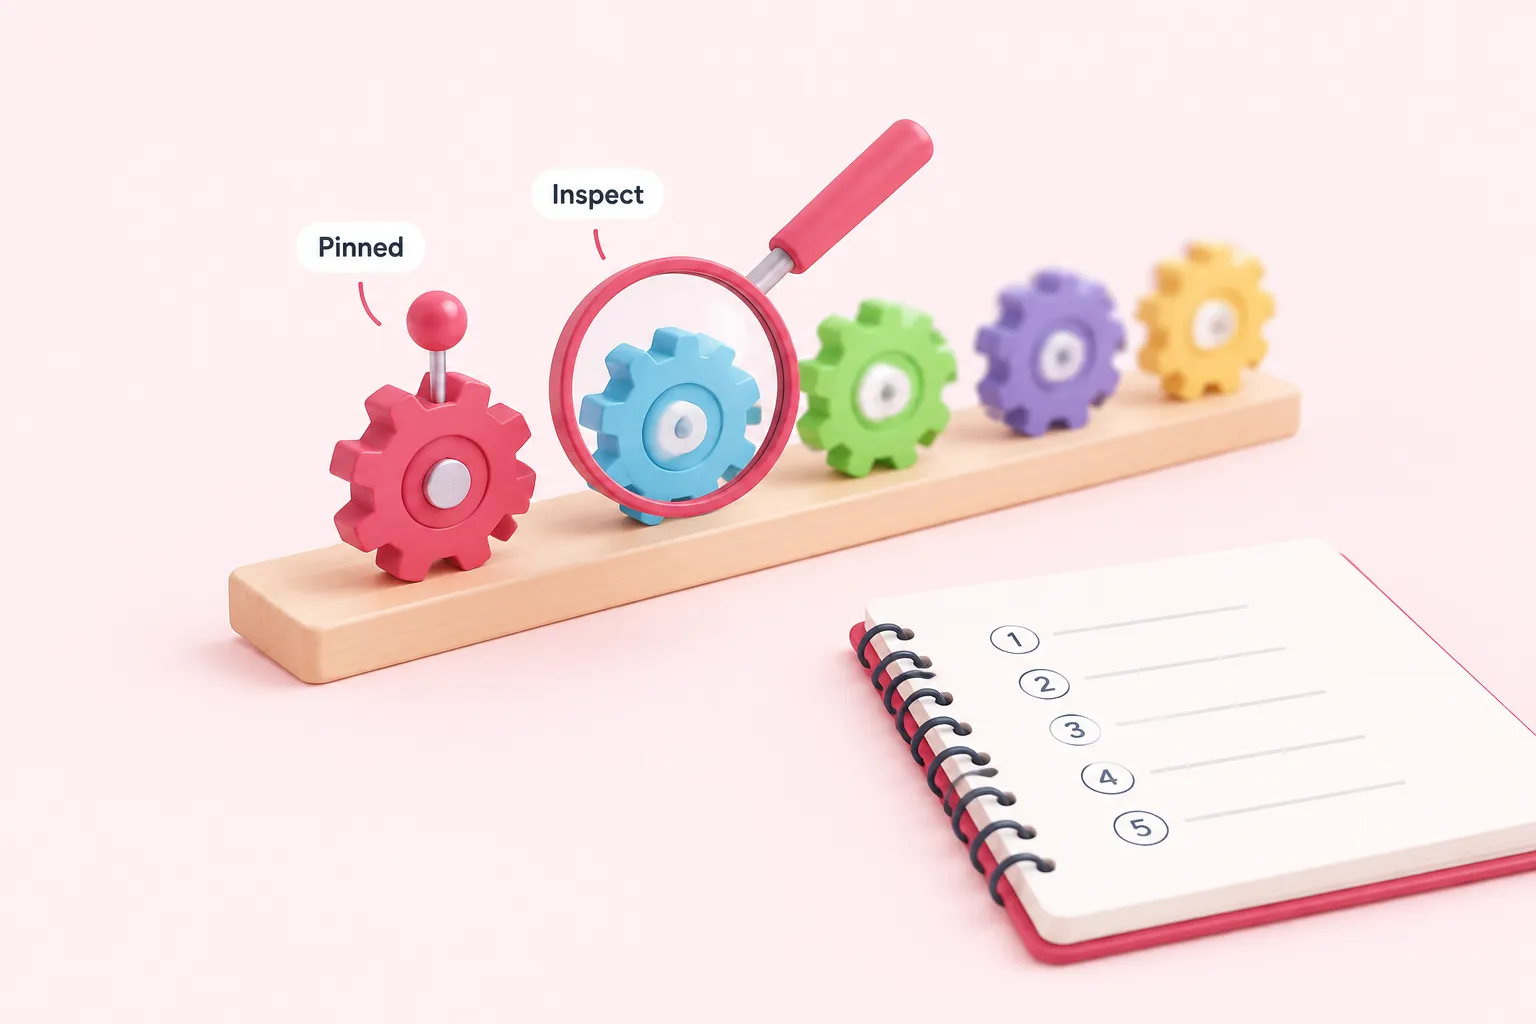
Una vez que sospechas que un nodo específico es el problema, la fijación de datos (pinning) te permite congelar la salida de ese nodo y reutilizar los datos fijados en cada ejecución posterior, en lugar de obtener datos nuevos cada vez. Eso convierte una cadena larga en algo que puedes recorrer paso a paso, un nodo a la vez, porque todo lo anterior permanece fijo mientras ajustas lo que viene después. La fijación solo funciona mientras estás desarrollando en el editor, no en ejecuciones de producción en vivo, así que es una herramienta para aislar un fallo mientras aún estás construyendo, no para rastrear uno que ya ocurrió en producción.
Si prefieres seguir un recorrido guiado en lugar de resolverlo solo, la propia galería de plantillas de n8n alberga una lección interactiva, enviada por un miembro de la comunidad, que te hace inspeccionar la entrada y salida de cada nodo directamente y usar console.log() dentro de nodos Code para observar cómo cambian realmente de forma los datos a medida que se mueven. Como es una aportación de la comunidad y no un tutorial oficial, la trataríamos como un buen ejercicio de calentamiento más que como la única lección que necesitas sobre el flujo de datos.
Sources: Pin and mock data | Build | n8n Docs, Learn n8n interactively, lesson 1: data flow, execution & debugging | n8n workflow template
Practica el rastreo tú mismo: construye un reto y luego rómpelo
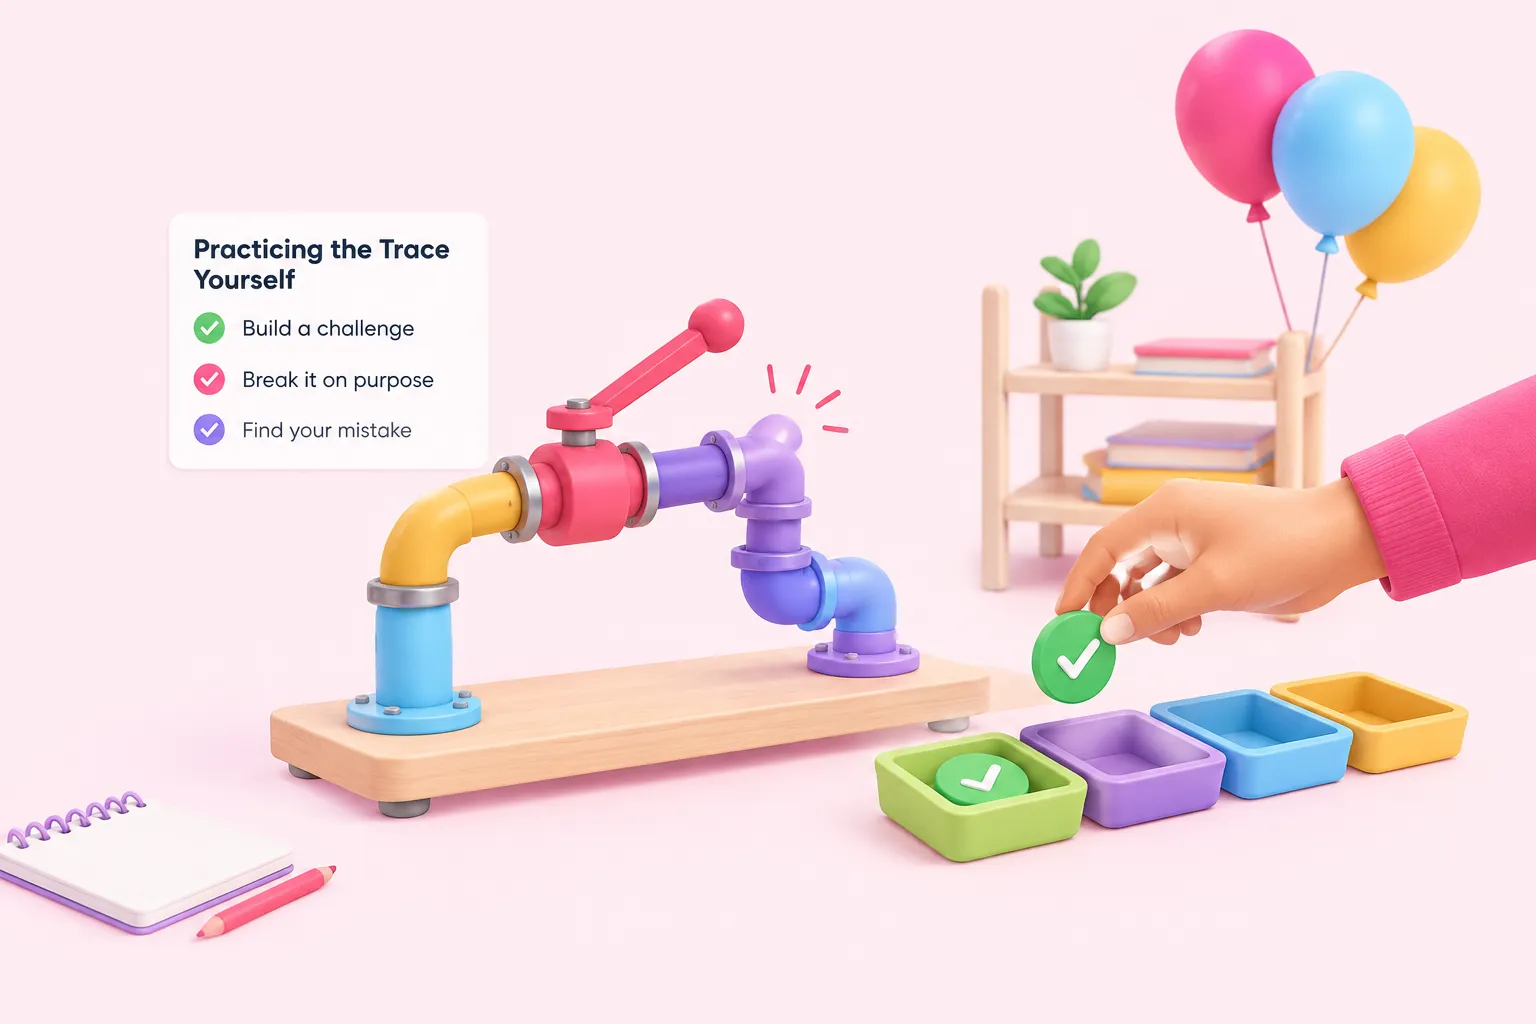
La forma más fiable de aprender a rastrear un fallo es construir algo pequeño, romperlo a propósito y encontrar tu propio error. Trátalos como pequeños proyectos de n8n que puedes romper sin riesgo: lo que está en juego es poco, y ya sabes dónde pusiste el error. Si quieres un flujo de trabajo que ya incluya piezas de manejo de fallos para estudiar, el reto Que los pedidos del restaurante sigan adelante en este sitio usa los nodos Manual Trigger, HTTP Request, Loop Over Items, Wait, Data Table y Error Trigger para recuperar pedidos de una API que limita la velocidad de las solicitudes y falla de forma inesperada.
Varios de los otros retos para principiantes del sitio, como Calidad del aire en Valencia, también incluyen una solución resuelta con la que comparar una vez que has construido tu propio intento, de modo que puedas cotejar tu propio rastreo con la versión funcional de otra persona. Eso convierte los retos de práctica en ejemplos de n8n de los que realmente aprendes, no solo que lees.
Sources: Debug executions | Build | n8n Docs, Handle errors gracefully | Build | n8n Docs, Pin and mock data | Build | n8n Docs
Cuándo los equipos recurren a observabilidad dedicada, y las concesiones que implica
Una vez que un equipo ejecuta muchos flujos de trabajo en producción, rastrear un fallo en el editor deja de ser suficiente; necesitas ver patrones a través de las ejecuciones. Una publicación de 2026 de un miembro de la comunidad describe la construcción de herramientas de observabilidad independientes alrededor de n8n —trazas de ejecución por flujo de trabajo, un explorador de métricas y registro de auditoría— como una forma de vigilar fallos a través de muchas ejecuciones en lugar de una a la vez. Como es una única publicación autopromocional sobre la herramienta propia del autor, trátala como un enfoque de la comunidad entre otros, no como un ejemplo documentado por n8n.
Para un equipo que todavía está aprendiendo a rastrear un solo fallo, ese tipo de herramientas es una opción de etapa posterior, no un punto de partida. Nosotros la evitaríamos hasta que el flujo de depuración integrado y los flujos de error anteriores resulten rutinarios, y solo recurriríamos a observabilidad adicional una vez que estés depurando a través de decenas de ejecuciones en lugar de una sola.
Sources: Show HN: N8n-trace – Grafana-like observability for n8n workflows - DEV Community