Cómo probar de forma segura un flujo de errores reutilizable de n8n sin publicar tu automatización real
Una guía para principiantes sobre cómo separar una automatización real, un gestor de errores reutilizable y una prueba programada desechable para verificar la gestión controlada de fallos con una exposición limitada.
Comprobado con las fuentes citadas el .
Comprende la configuración segura de tres flujos de trabajo
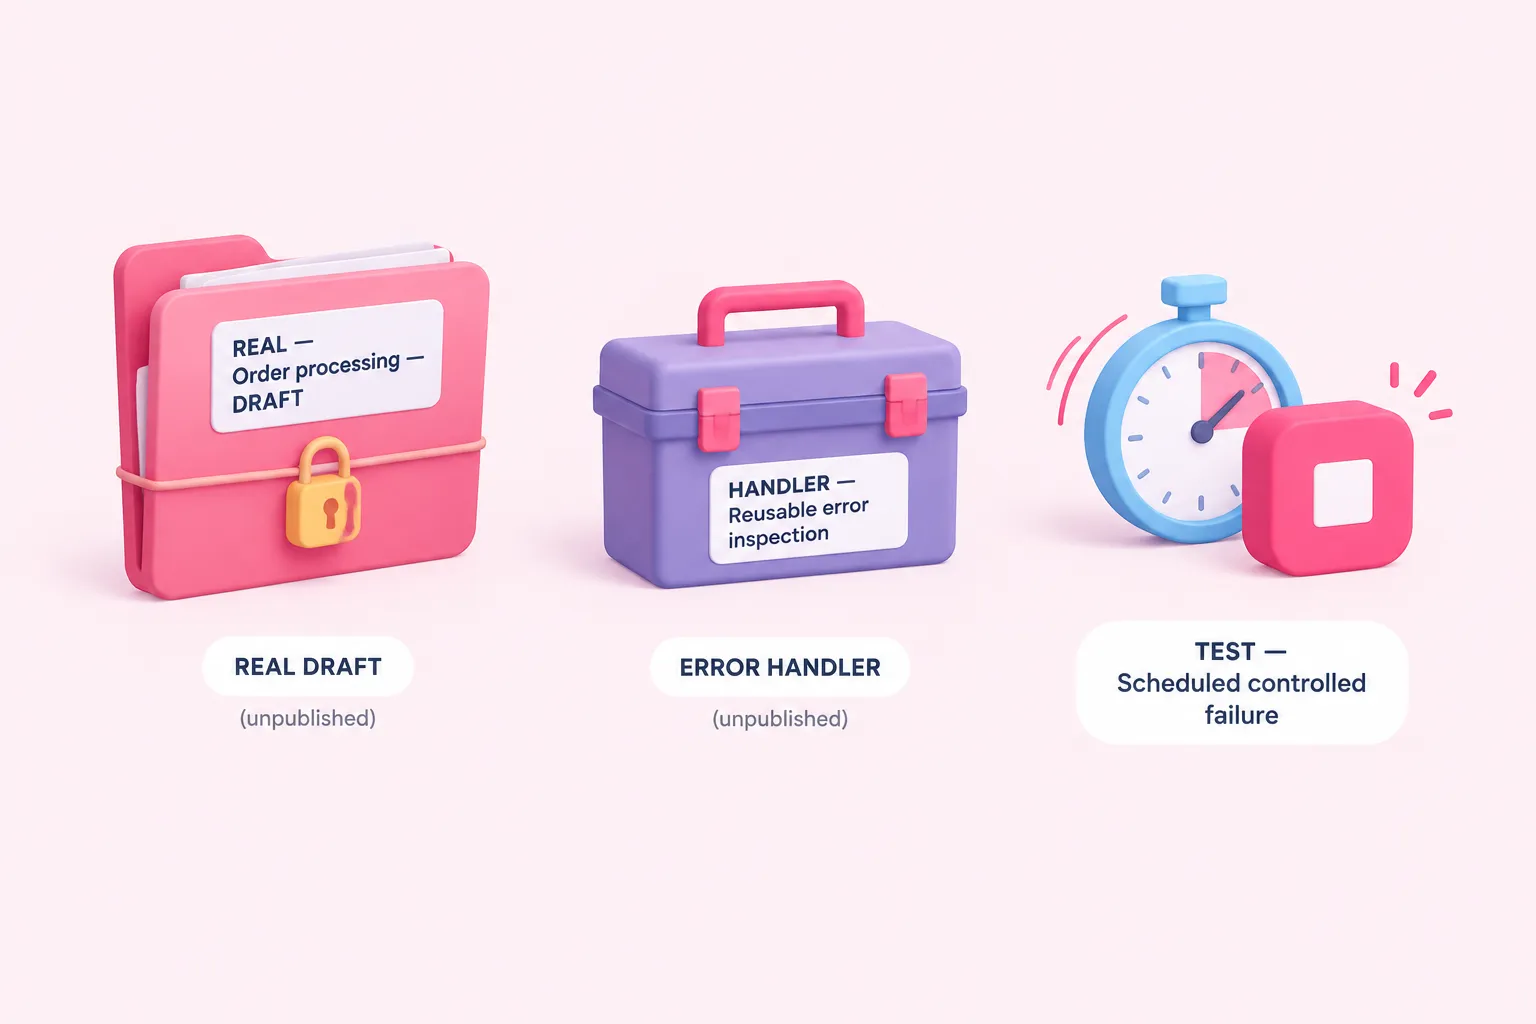
Una forma prudente de abordar este ejercicio es separar tres responsabilidades diferentes. Mantén tu automatización real como borrador sin publicar. Crea un segundo flujo de trabajo que reciba los errores y que pueda reutilizarse más adelante. Después, crea un tercer flujo de trabajo desechable cuyo único propósito sea fallar de forma programada. Esta separación es un patrón de seguridad editorial elaborado a partir del comportamiento documentado de n8n; reduce la posibilidad de involucrar la automatización real, pero no elimina todos los riesgos de la prueba.
Asigna nombres inequívocos a los flujos de trabajo, como “REAL — Procesamiento de pedidos — BORRADOR”, “HANDLER — Inspección reutilizable de errores” y “TEST — Fallo controlado programado”. Los nombres claros son especialmente útiles al seleccionar un flujo de errores en los ajustes o revisar las listas de ejecuciones. Antes de continuar, comprueba que el flujo de prueba no contenga datos de clientes, credenciales de producción, destinatarios de notificaciones ni acciones irreversibles.
El límite de publicación es fundamental para esta configuración. Las modificaciones de un borrador permanecen fuera de producción hasta que se publican, mientras que una ejecución programada automáticamente requiere un disparador no manual y un flujo de trabajo publicado. La consecuencia práctica es sencilla: deja la automatización real sin publicar y publica posteriormente solo el flujo de prueba aislado.
Crea y guarda el gestor de errores reutilizable
Crea el gestor como un flujo de trabajo independiente y coloca primero Error Trigger. Un flujo de errores debe comenzar con este disparador, y varios flujos de trabajo pueden seleccionar el mismo gestor. Esto permite utilizarlo como un punto de inspección reutilizable, en lugar de vincularlo permanentemente a esta prueba desechable.
Para una comprobación inicial, procura que todo lo situado después de Error Trigger tenga un riesgo bajo. Un enfoque sugerido consiste en inspeccionar los datos de la ejecución entrante o pasar campos seleccionados a un paso de transformación sencillo. No empieces con notificaciones a clientes, creación de tickets, escrituras en bases de datos ni otras acciones que puedan producir efectos no deseados mientras todavía estás aprendiendo qué contiene la carga útil.
Guarda el gestor, pero no lo publiques. n8n permite que un flujo de trabajo con Error Trigger permanezca sin publicar. Tampoco confíes en una ejecución manual para demostrar que el disparador funciona: el gestor está pensado para ejecutarse cuando un flujo de trabajo vinculado falla a través de la ruta de ejecución automática correspondiente.
Conecta los flujos mediante los ajustes de Error Workflow
Abre los ajustes del flujo de prueba desechable y busca la opción Error Workflow. Selecciona allí el gestor reutilizable guardado. Este ajuste indica a n8n qué flujo de trabajo debe iniciar cuando falle el flujo de prueba.
Confirma cuidadosamente la selección antes de publicar nada. Los nombres parecidos pueden hacer que selecciones el gestor equivocado, otra razón para utilizar prefijos explícitos como REAL, HANDLER y TEST. En este punto, tu flujo real todavía debe estar separado, sin publicar y sin intervenir. El gestor debe estar guardado, pero sin publicar, mientras que el flujo de prueba estará listo para recibir su disparador y su fallo controlado.
Crea un flujo de prueba programado que falle deliberadamente
En el flujo de prueba desechable, conecta un Schedule Trigger a un nodo Stop And Error. Configura una programación breve pero controlada que te dé tiempo suficiente para revisar la configuración antes de que se ejecute. Evita un intervalo innecesariamente frecuente, porque el flujo continuará fallando hasta que dejes de publicarlo o detengas de otra manera sus ejecuciones automáticas.
Utiliza Stop And Error para generar un mensaje u objeto inequívoco y exclusivo de la prueba. Un mensaje sugerido es “CONTROLLED TEST FAILURE — safe to remove”. Un objeto sugerido podría contener campos como testPurpose, expectedFailure y cleanupReminder. Estos ejemplos son sugerencias editoriales, no plantillas validadas, y no deben contener secretos ni información real de clientes.
Stop And Error está diseñado para crear una ejecución fallida y puede transmitir información de error personalizada. Esto hace que el fallo sea intencionado y más fácil de distinguir de un problema inesperado en otra parte. Mantén este flujo al mínimo: Schedule Trigger, Stop And Error y ningún nodo operativo adicional.
Publica únicamente el flujo de prueba y verifica el fallo automático
Revisa los tres flujos de trabajo antes de publicar. La automatización real permanece como borrador sin publicar. El gestor reutilizable permanece guardado y sin publicar. Solo se publica el flujo desechable que contiene la programación y el fallo controlado. Esta disposición sigue la distinción documentada entre las modificaciones de borradores y las ejecuciones de producción.
No utilices Execute Workflow ni otra ejecución manual como método principal para verificar Error Trigger. La prueba debe ejecutarse mediante su disparador no manual y publicado para que el flujo de errores vinculado pueda recibir el fallo. Espera una ejecución programada en vez de cambiar repetidamente el flujo de trabajo o iniciar ejecuciones no relacionadas.
Cuando haya pasado la hora programada, revisa el historial de ejecuciones de la prueba desechable. Deberías encontrar su ejecución fallida deliberadamente. Después, revisa las ejecuciones del gestor y comprueba si recibió los datos de error correspondientes. Si el gestor no se ejecutó, vuelve a comprobar que seleccionaste el flujo correcto en el ajuste Error Workflow del flujo de prueba y que el fallo procedía de la ejecución programada automática.
Inspecciona los datos de error recibidos y limpia de forma segura
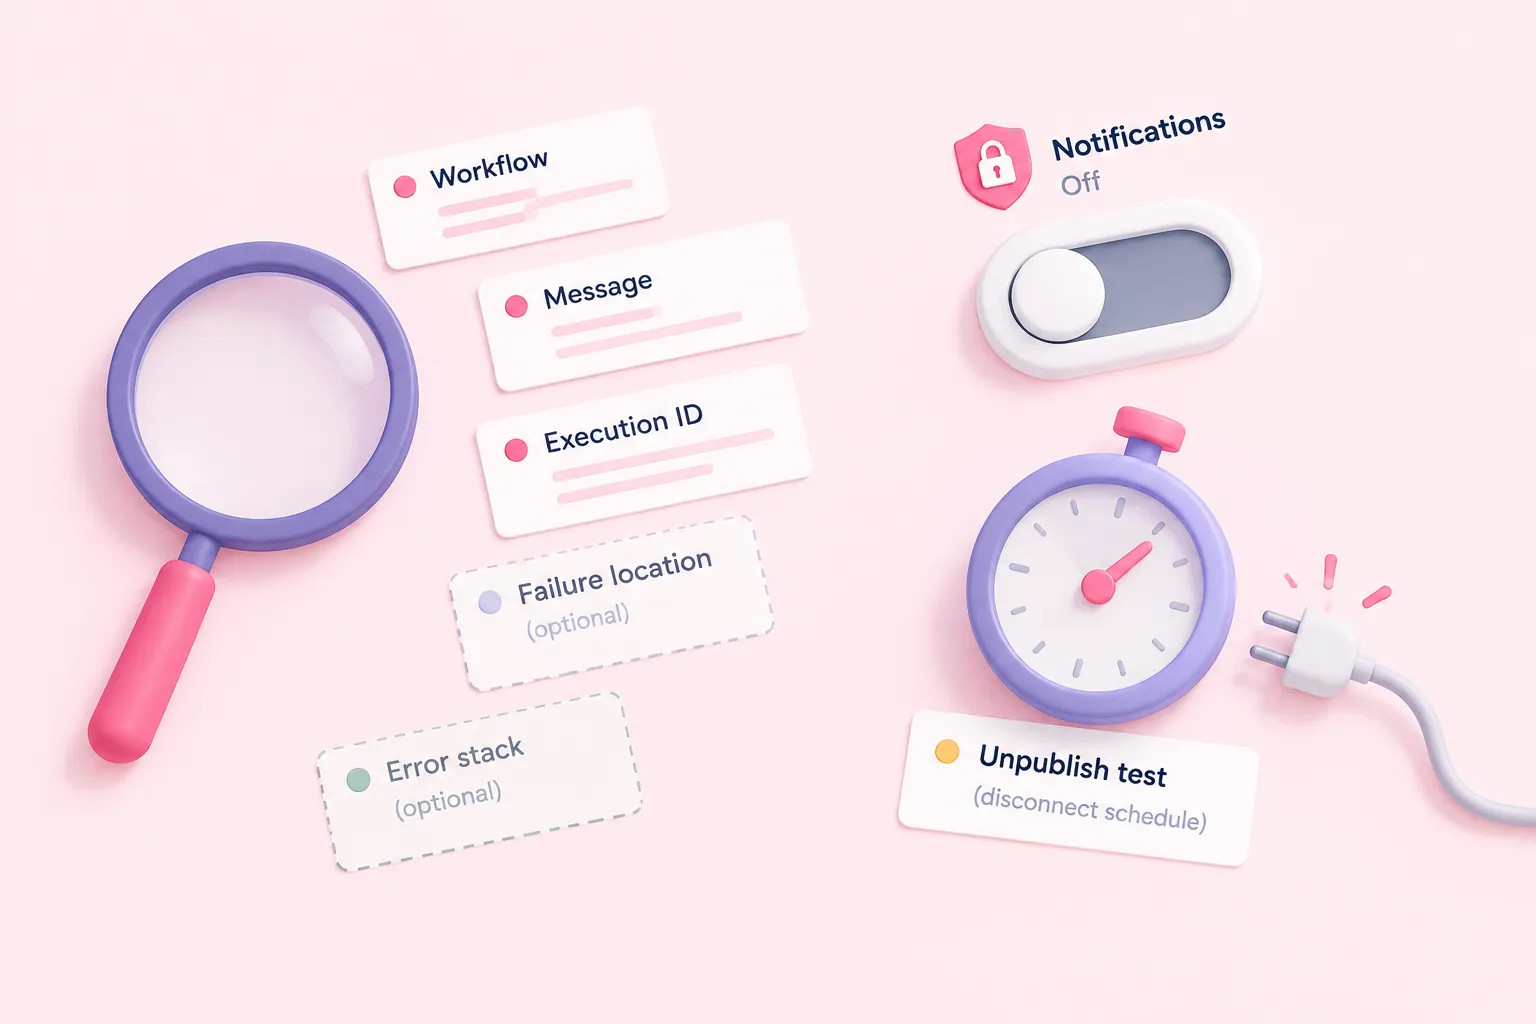
Examina la carga útil de forma defensiva en lugar de asumir que todos los campos estarán siempre presentes. La información de error puede variar según el contexto del fallo. Los identificadores de ejecución dependen de la persistencia en la base de datos, y un fallo en un nodo disparador puede producir una carga útil con una estructura diferente. Si más adelante creas reglas de enrutamiento o notificaciones alrededor de este gestor, trata los valores opcionales como opcionales y proporciona alternativas razonables.
Entre las preguntas útiles para la inspección se incluyen: ¿Qué flujo de trabajo falló? ¿Qué mensaje de error llegó? ¿Hay un identificador de ejecución disponible? ¿El fallo ocurrió en un nodo normal o durante la activación? Estas son preguntas de revisión sugeridas, no un instrumento de diagnóstico validado. Su propósito es ayudarte a detectar suposiciones antes de añadir acciones de mayor impacto a un gestor reutilizable.
Cuando hayas confirmado la ejecución fallida de la prueba y la ejecución del gestor, deja de publicar el flujo programado desechable para impedir que continúe fallando según la programación. Conserva o elimina la prueba de acuerdo con las prácticas de tu propio espacio de trabajo. La separación reduce la exposición del flujo real durante este ejercicio, pero las credenciales, los ajustes de la instancia, las políticas de almacenamiento de ejecuciones, las programaciones, los permisos, las cuotas y cualquier nodo posterior todavía pueden influir en las consecuencias.
Practica la depuración de flujos de trabajo con fallos controlados
Un gestor de errores reutilizable adquiere más valor cuando comprendes ambos lados de la ruta: cómo falla un flujo de trabajo y qué información puede consumir el gestor de forma segura. Repite el ejercicio con variaciones inocuas, como cambiar el mensaje personalizado de la prueba o comprobar cómo se comporta el paso de inspección cuando falta un campo esperado. Mantén cada variación aislada y detén su programación después de una ejecución verificada.
Como ejercicio adicional sugerido, esboza los futuros puntos de decisión del gestor antes de añadir acciones operativas: identifica el flujo de trabajo que falló, normaliza los campos opcionales, clasifica el error y solo entonces decide si corresponde enviar una notificación u ofrecer otra respuesta. Esta es una secuencia de práctica editorial, no una prueba de que todos los gestores de producción deban utilizar el mismo diseño.