Modo Queue vs Modo Normal en n8n: Cuándo cambiar
Comparación práctica entre el modo queue y el modo normal de n8n: qué cambia, qué muestra el benchmark de n8n y cuándo cambiar.
Comprobado con las fuentes citadas el .
Modo Queue vs Modo Normal en n8n: qué es realmente cada uno
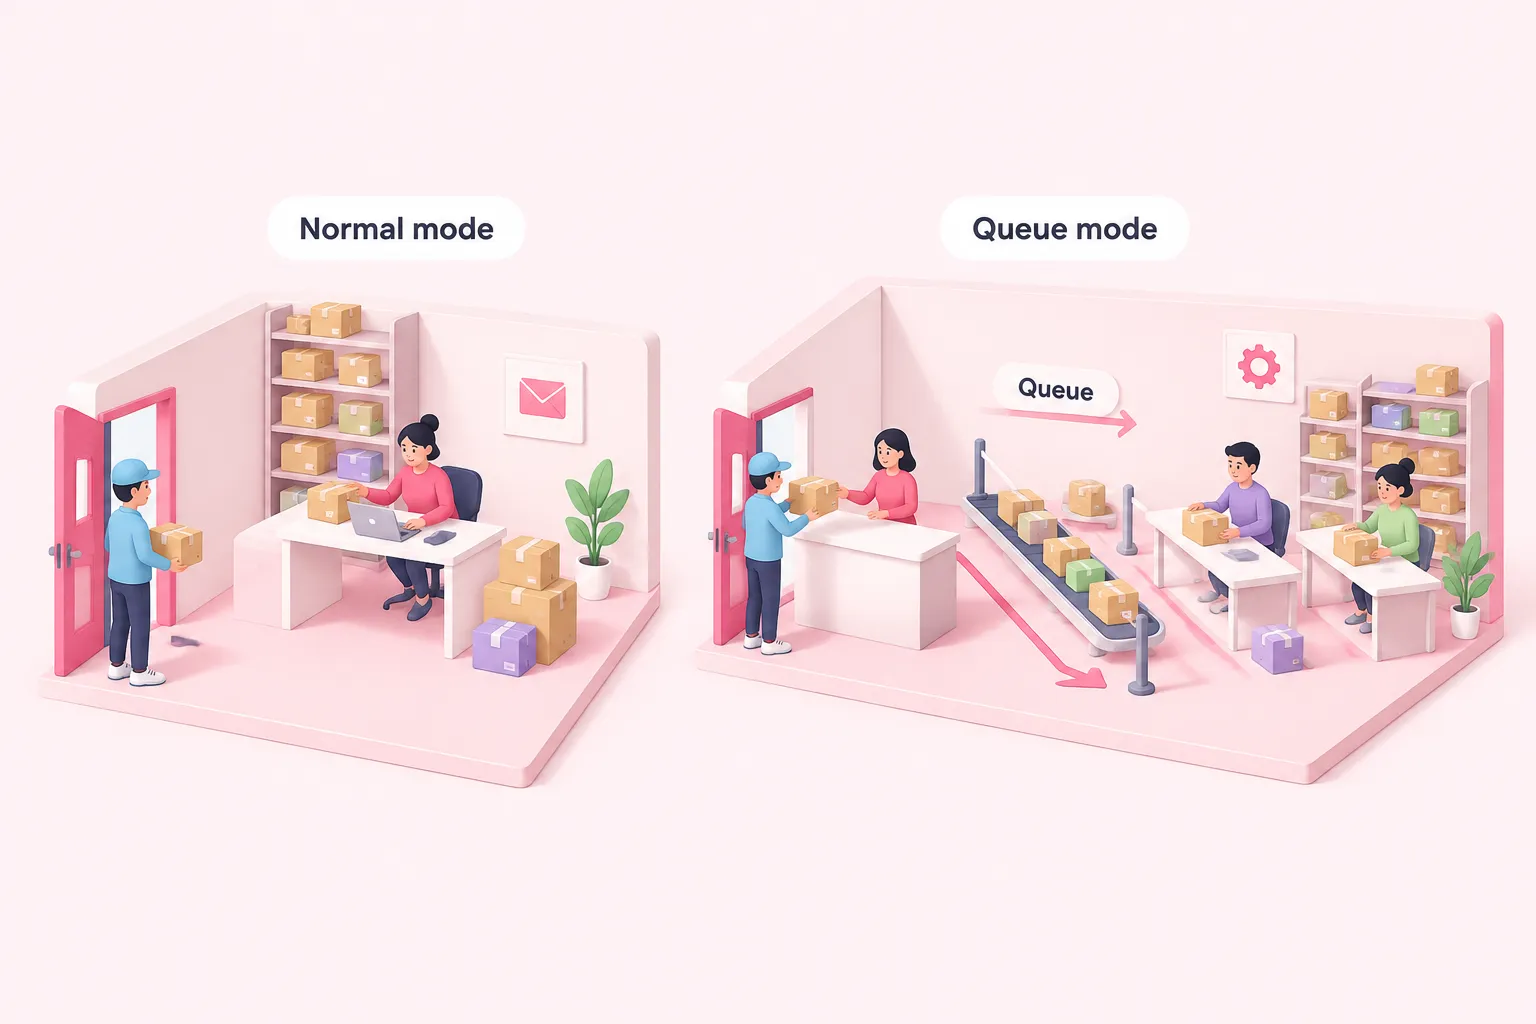
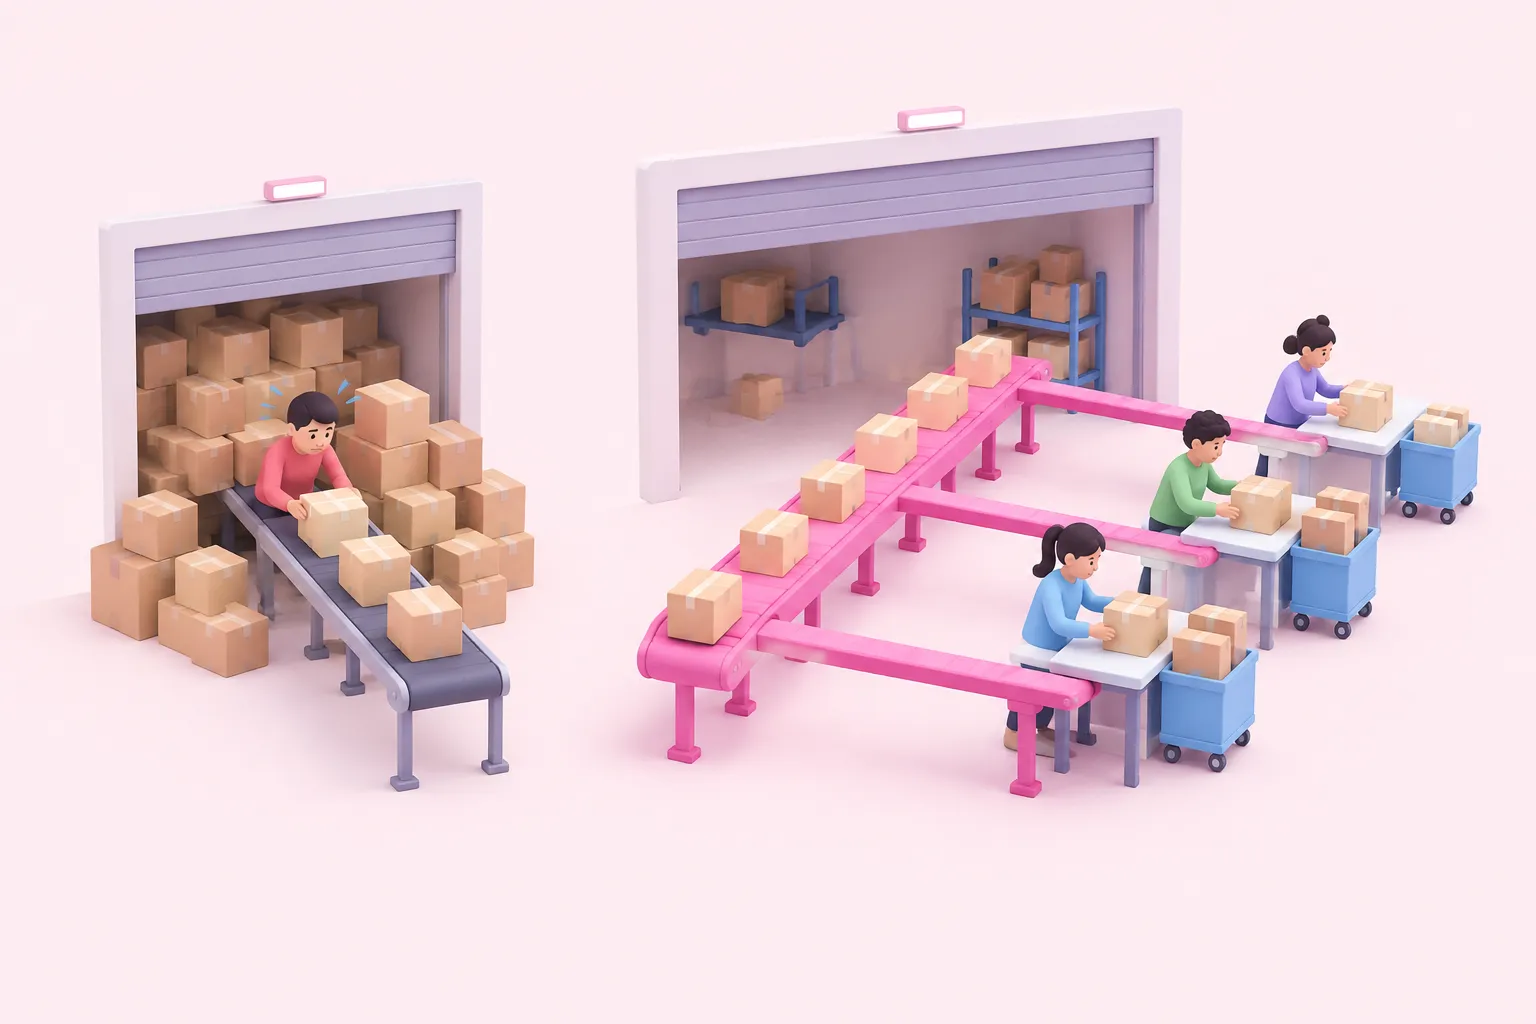
Cuando los equipos de ingeniería comparan el modo queue y el modo normal de n8n, la diferencia empieza por dónde se ejecuta realmente un workflow. En lo que la documentación de n8n llama modo regular, y que este artículo llama simplemente modo normal, un único proceso de n8n recibe cada disparador (trigger) y cada llamada webhook, y también ejecuta el workflow resultante, todo dentro de un mismo bucle de eventos (event loop). El modo queue divide ese trabajo: la documentación de n8n indica que el modo queue es la vía recomendada para lograr la mejor escalabilidad, porque separa la recepción de la ejecución entre varios procesos. Esa separación importa sobre todo cuando el factor limitante de un equipo deja de ser el código y pasa a ser la capacidad de proceso.
En la arquitectura del modo queue, la documentación de n8n indica que la instancia principal solo recibe triggers y webhooks, mientras que una instancia worker independiente es la que realmente ejecuta el workflow. Esa separación es lo que permite que un workflow lento o atascado se ejecute sin bloquear la instancia que está escuchando nuevas llamadas webhook o renderizando la interfaz del editor para otros usuarios. En el modo normal esa aislación no existe: la recepción y la ejecución compiten por el mismo proceso.
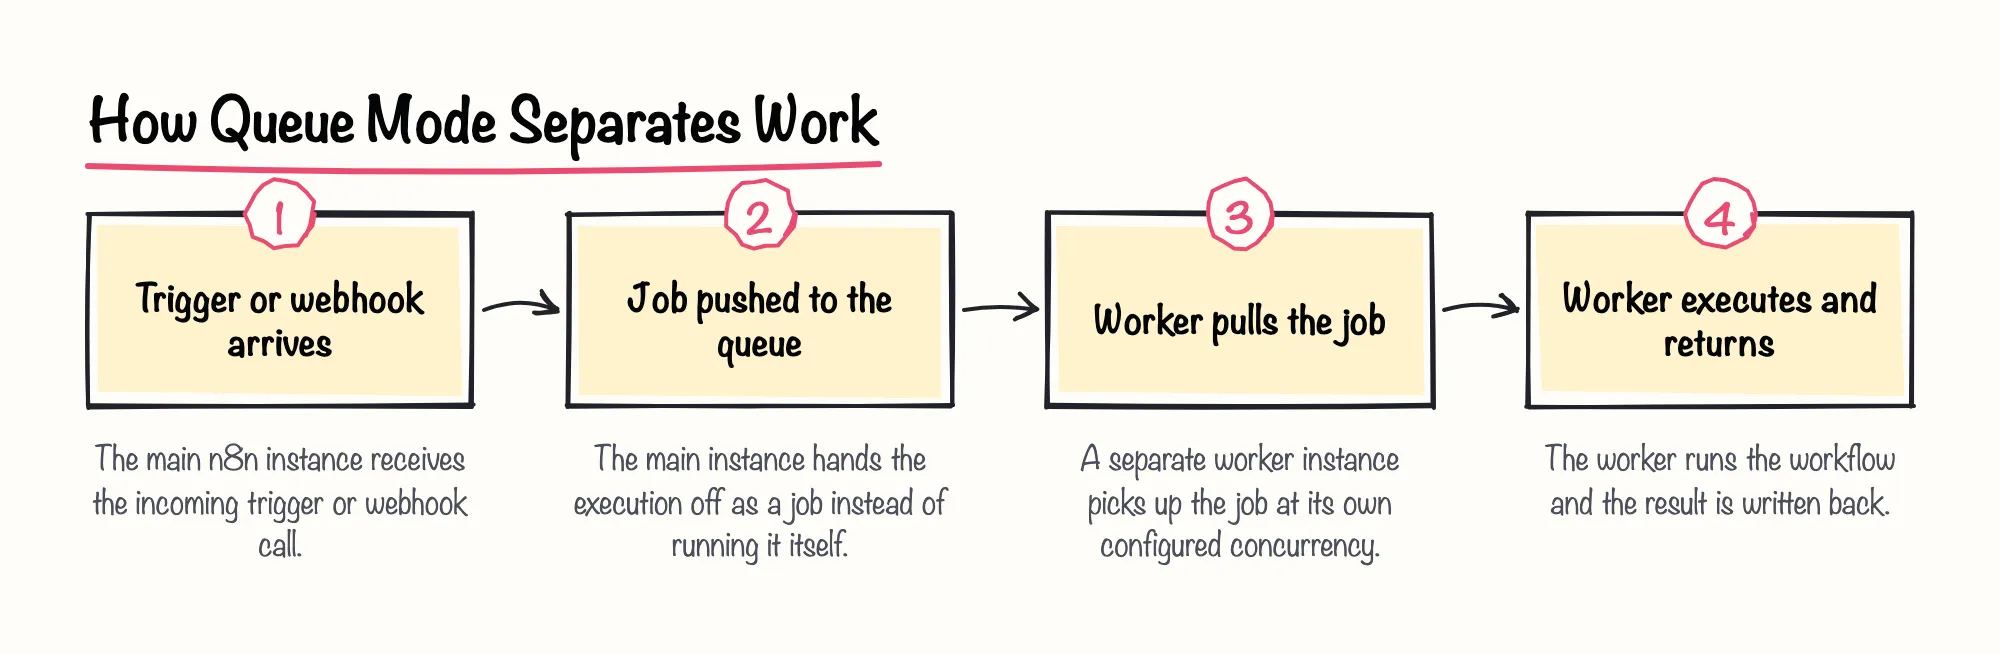
Los dos modos también controlan la concurrencia de forma distinta. La documentación de n8n sobre el modo regular advierte que demasiadas ejecuciones de producción concurrentes pueden saturar (thrash) el event loop, degradando el rendimiento y la capacidad de respuesta de toda la instancia. El modo queue, en cambio, permite que un equipo configure la concurrencia de trabajos por worker con un flag independiente, de modo que la carga de un worker no se convierte automáticamente en la carga de todo el sistema. Aun así, seríamos cautos a la hora de tratar cualquier cifra de ejecuciones como el disparador para cambiar de modo: la propia documentación de n8n describe el mecanismo detrás de esa saturación del event loop sin indicar un volumen concreto en el que empieza, así que la señal es el síntoma, no una cifra.
Sources: Scaling | Deploy | n8n Docs, Control concurrency | Deploy | n8n Docs, Enable queue mode | Deploy | n8n Docs
Qué muestra el benchmark sobre rendimiento, fallos y datos binarios
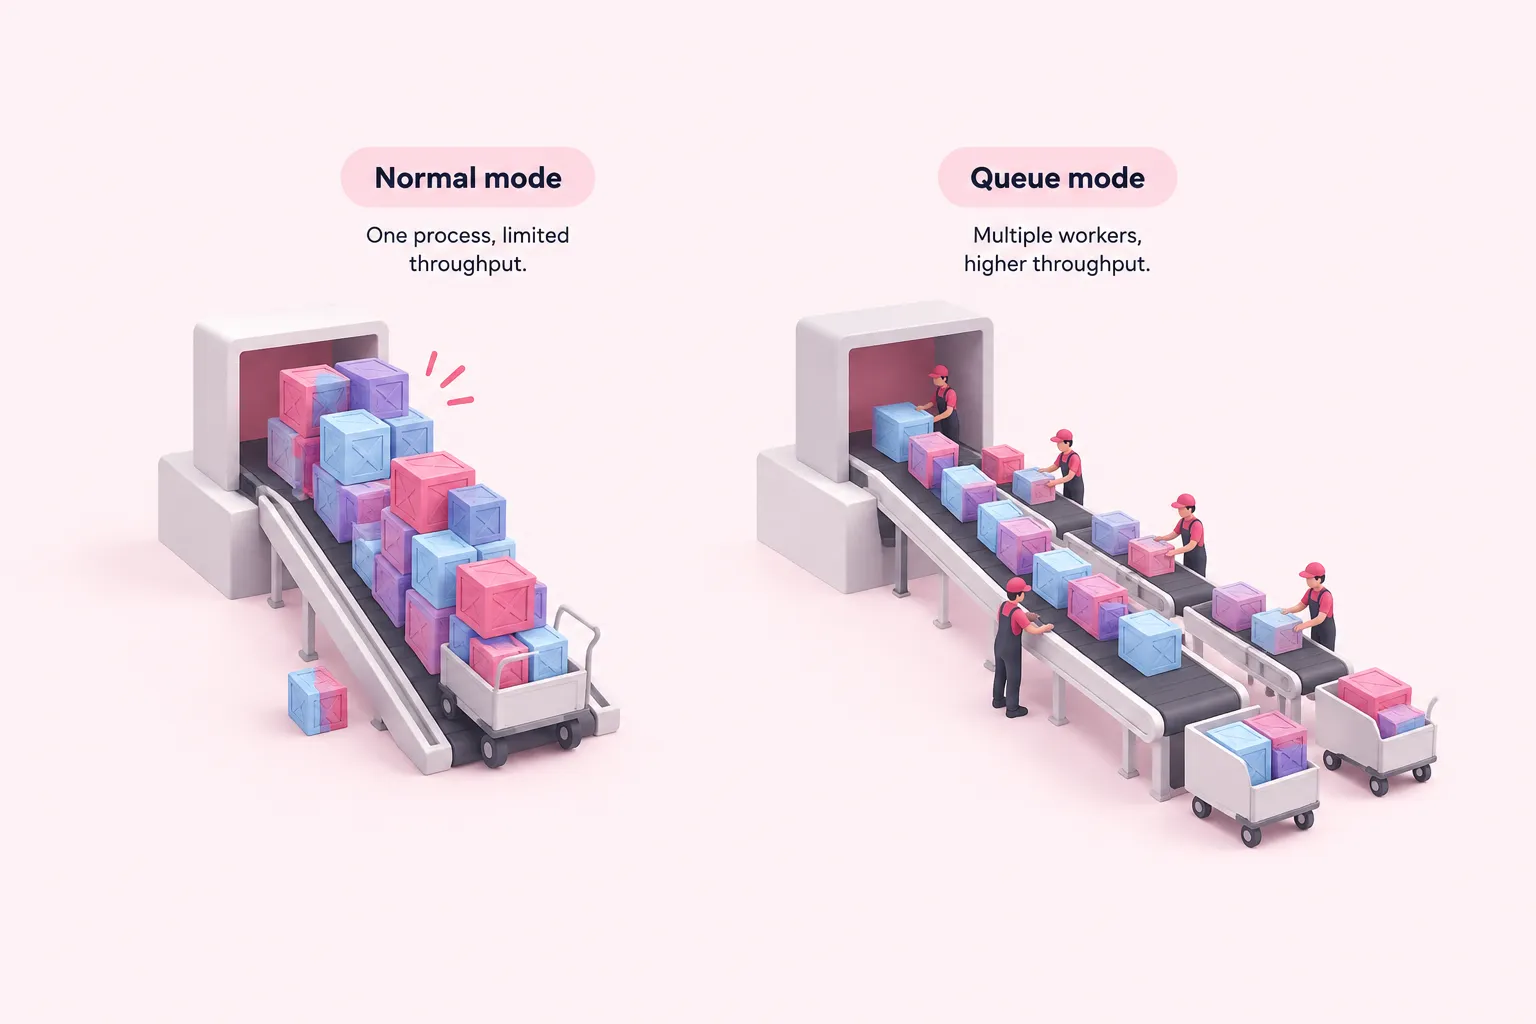
La propia documentación de rendimiento de n8n indica que una sola instancia puede gestionar hasta 220 ejecuciones de workflow por segundo antes de que un equipo necesite escalar más, y que las configuraciones multiinstancia dependen del modo queue para lograr ese escalado. Ese planteamiento ya responde en parte a la pregunta sobre el modo queue frente al modo normal de n8n: el modo normal no es necesariamente lento, pero tiene un límite ligado a un único proceso, y el modo queue es la vía documentada para superarlo.
El benchmark de escalabilidad de n8n de 2025 registró que, en una instancia c5.large, activar el modo queue elevó el rendimiento de Single Webhook a 72 solicitudes por segundo, frente al mismo hardware ejecutándose en modo normal.
| Nivel de hardware | Rendimiento de Single Webhook (modo queue) | Fuente |
|---|---|---|
| c5.large | 72 solicitudes por segundo | Benchmark de escalabilidad de n8n de 2025 |
| c5.4xlarge | 162 solicitudes por segundo | Benchmark de n8n de 2025 en hardware más potente |
En una instancia c5.4xlarge más grande, el benchmark de n8n de 2025 en hardware más potente registró un rendimiento constante de 162 solicitudes por segundo en modo queue, bajo una prueba de carga con K6 que escalaba hasta 200 usuarios virtuales. La documentación de n8n presenta ambos resultados como su propio benchmark en tipos de instancia concretos, y no como una garantía para cualquier carga de trabajo.
En el nivel de hardware más pequeño, el mismo benchmark informó que el modo queue también redujo la latencia por debajo de tres segundos y eliminó los fallos que mostraba el modo normal cuando la carga llegaba a 200 usuarios virtuales. Nuestra visión pragmática es que una cifra publicada como esta es un punto de partida, no una cifra de planificación: ejecutaríamos el propio framework de benchmarking de n8n contra los tipos de workflow y el hardware reales de un equipo antes de dimensionar la capacidad de producción, porque una carga sintética de webhooks no indica cómo se comportará un workflow lleno de lógica condicional o payloads grandes.
Los datos binarios cambian el cálculo. La documentación de n8n indica que el modo queue no admite el almacenamiento de datos binarios en el sistema de archivos local, y su guía de configuración de datos binarios instruye específicamente a cambiar el modo de almacenamiento binario predeterminado a almacenamiento en base de datos en cuanto un equipo ejecuta el modo queue, ya que el modo de sistema de archivos no es compatible ahí. Un equipo que mueve archivos grandes o respuestas de webhook voluminosas a través de sus workflows debe planificar ese cambio de almacenamiento antes de cambiar de modo, no después.
Sources: Measure performance | Deploy | n8n Docs, The n8n Scalability Benchmark – n8n Blog, Enable queue mode | Deploy | n8n Docs, Handle binary data | Deploy | n8n Docs
Alta disponibilidad, restricciones de plan y qué permanece igual
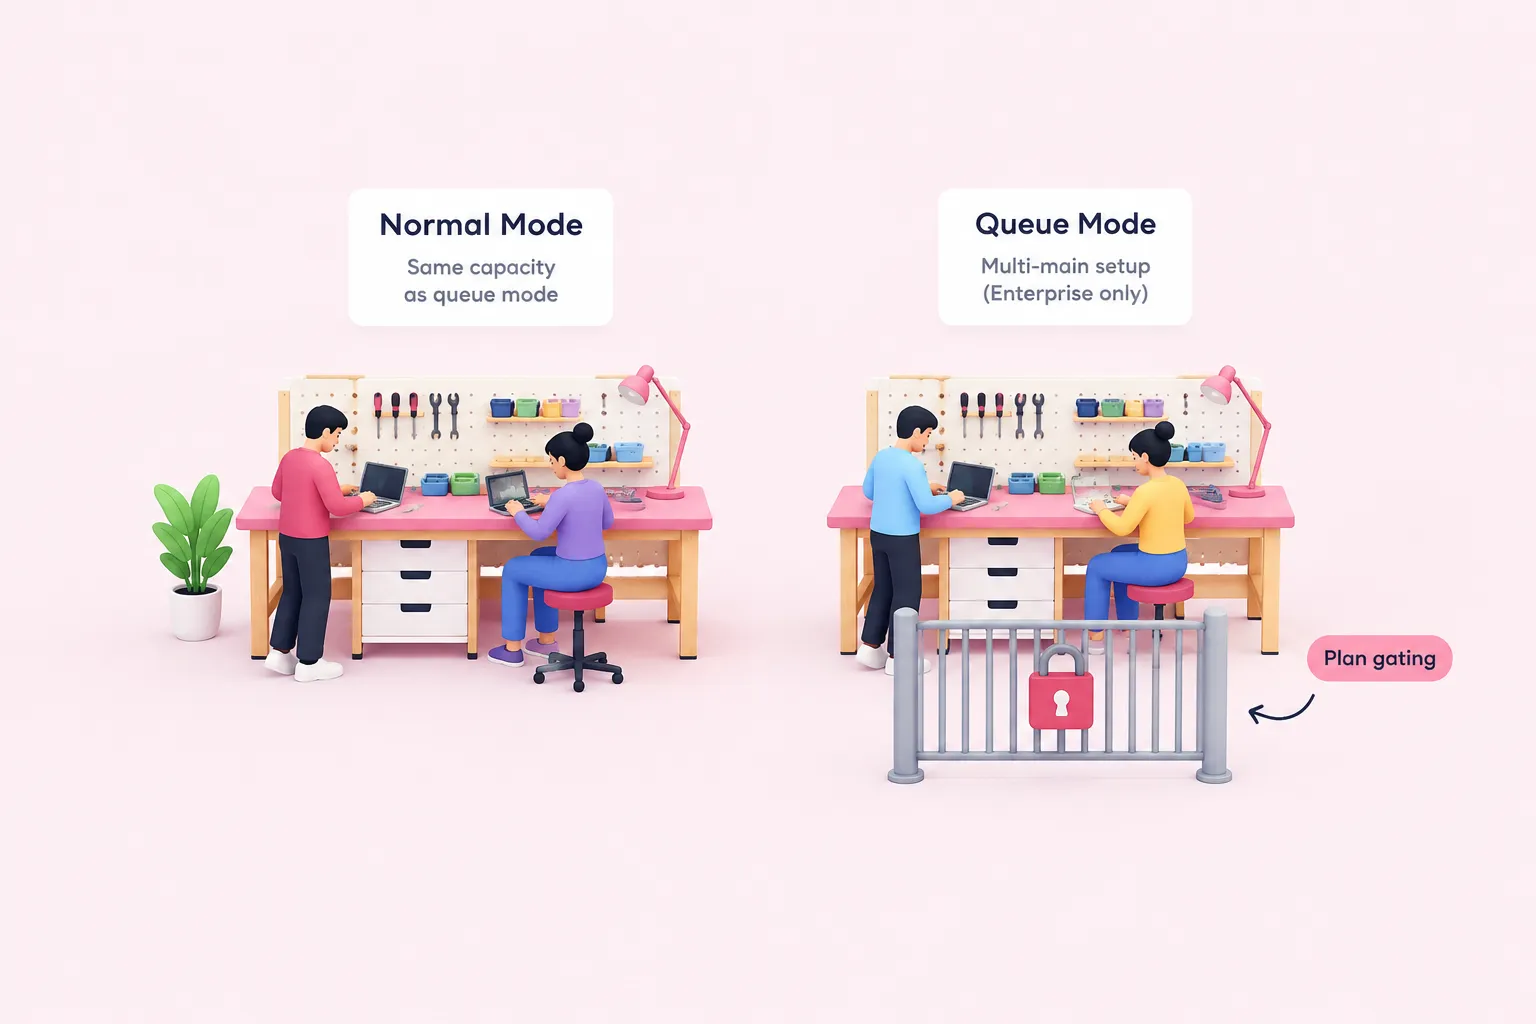
Ejecutar más de un proceso principal para lograr alta disponibilidad es, según la documentación de n8n, una capacidad exclusiva del modo queue, y está restringida a la edición Enterprise autoalojada. Un equipo con una licencia community o autoalojada no Enterprise todavía puede ejecutar workers, pero no la configuración multi-main que elimina el proceso principal como punto único de fallo.
En n8n Cloud, el propio modo queue está restringido al plan Enterprise, y la documentación de n8n indica que debe activarse contactando directamente con n8n, en lugar de mediante opciones de autoservicio; la concurrencia ahí se sigue configurando por worker, con la misma lógica que el modo queue autoalojado.
| Criterio | Modo normal | Modo queue |
|---|---|---|
| Control de concurrencia | Límite de toda la instancia; demasiadas ejecuciones concurrentes pueden saturar el event loop | Flag de concurrencia por worker, configurado por separado del límite de toda la instancia |
| Aislación de ejecución | La recepción y la ejecución comparten un solo proceso | La instancia principal solo recibe triggers y webhooks; un worker independiente ejecuta |
| Almacenamiento de datos binarios | Se admite almacenamiento en sistema de archivos | No se admite almacenamiento en sistema de archivos; el valor predeterminado debe cambiar a almacenamiento en base de datos |
| Alta disponibilidad (multi-main) | No documentado como aplicable | Disponible, restringido a Enterprise autoalojado |
| Disponibilidad en n8n Cloud | Modo de ejecución predeterminado | Restringido al plan Enterprise; se activa contactando directamente con n8n |
Algunas cosas no cambian cuando un equipo cambia de modo. n8n activa la limpieza (pruning) de datos de ejecución de forma predeterminada tanto en modo normal como en modo queue, un ajuste operativo que no depende de qué modo esté en marcha. La configuración de pruning y retención de un equipo sobrevive al cambio sin modificarse, lo cual es una cosa menos que rediseñar.
Sources: Control concurrency | Deploy | n8n Docs, Enable queue mode | Deploy | n8n Docs, Handle binary data | Deploy | n8n Docs, Understand concurrency | Deploy | n8n Docs, Manage execution data | Deploy | n8n Docs
Señales de que es momento de cambiar, y una checklist para lograrlo
En conjunto, la señal más clara para evaluar el modo queue frente al modo normal de n8n es la advertencia documentada sobre el event loop combinada con una necesidad real de escalar a más de una instancia, más que una cifra concreta de ejecuciones. Somos optimistas respecto a que los equipos que cambian de modo cuando aparecen estas señales asumen sobre todo una sobrecarga operativa, no un rediseño: los workflows en sí no cambian, solo dónde y cómo se ejecutan.
Antes de comprometer infraestructura, ayuda recorrer el cambio en orden.
La documentación de n8n no señala un umbral único de volumen de ejecuciones que obligue a cambiar de modo, así que la decisión sigue siendo un criterio basado en estas señales, no una regla fija.
Sources: Control concurrency | Deploy | n8n Docs, Measure performance | Deploy | n8n Docs