n8n Queue Mode проти Normal Mode: коли перемикатися
Практичне порівняння n8n queue mode і normal mode: що змінюється, що показує benchmark n8n і коли варто перемикатися.
Перевірено за наведеними джерелами .
n8n Queue Mode vs Normal Mode: що це насправді
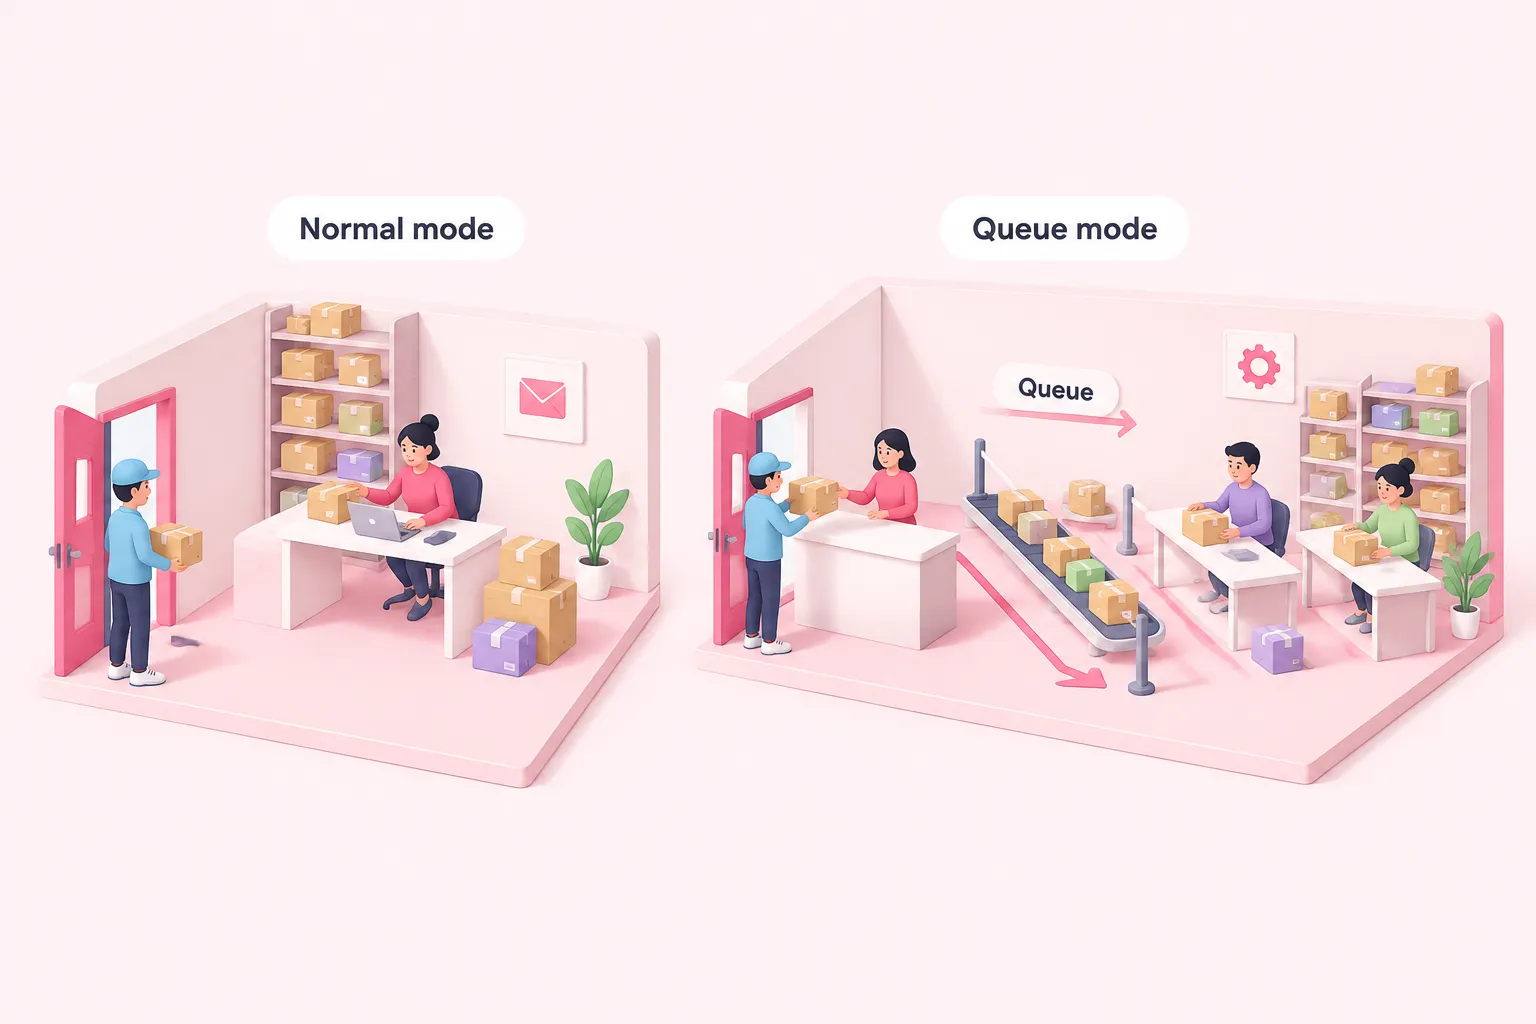
Коли інженерні команди порівнюють n8n queue mode і normal mode, різниця починається з того, де фактично виконується workflow. У тому, що документація n8n називає regular mode (далі в цій статті — normal mode), один процес n8n приймає кожен тригер і webhook-викликк, а також виконує відповідний workflow — усе в межах одного event loop. Queue mode розділяє цю роботу: документація n8n стверджує, що queue mode — рекомендований шлях для найкращої масштабованості, оскільки він розділяє прийом і виконання між кількома процесами. Цей розподіл стає найважливішим, коли обмежувальним фактором команди перестає бути код і стає пропускна здатність процесів.
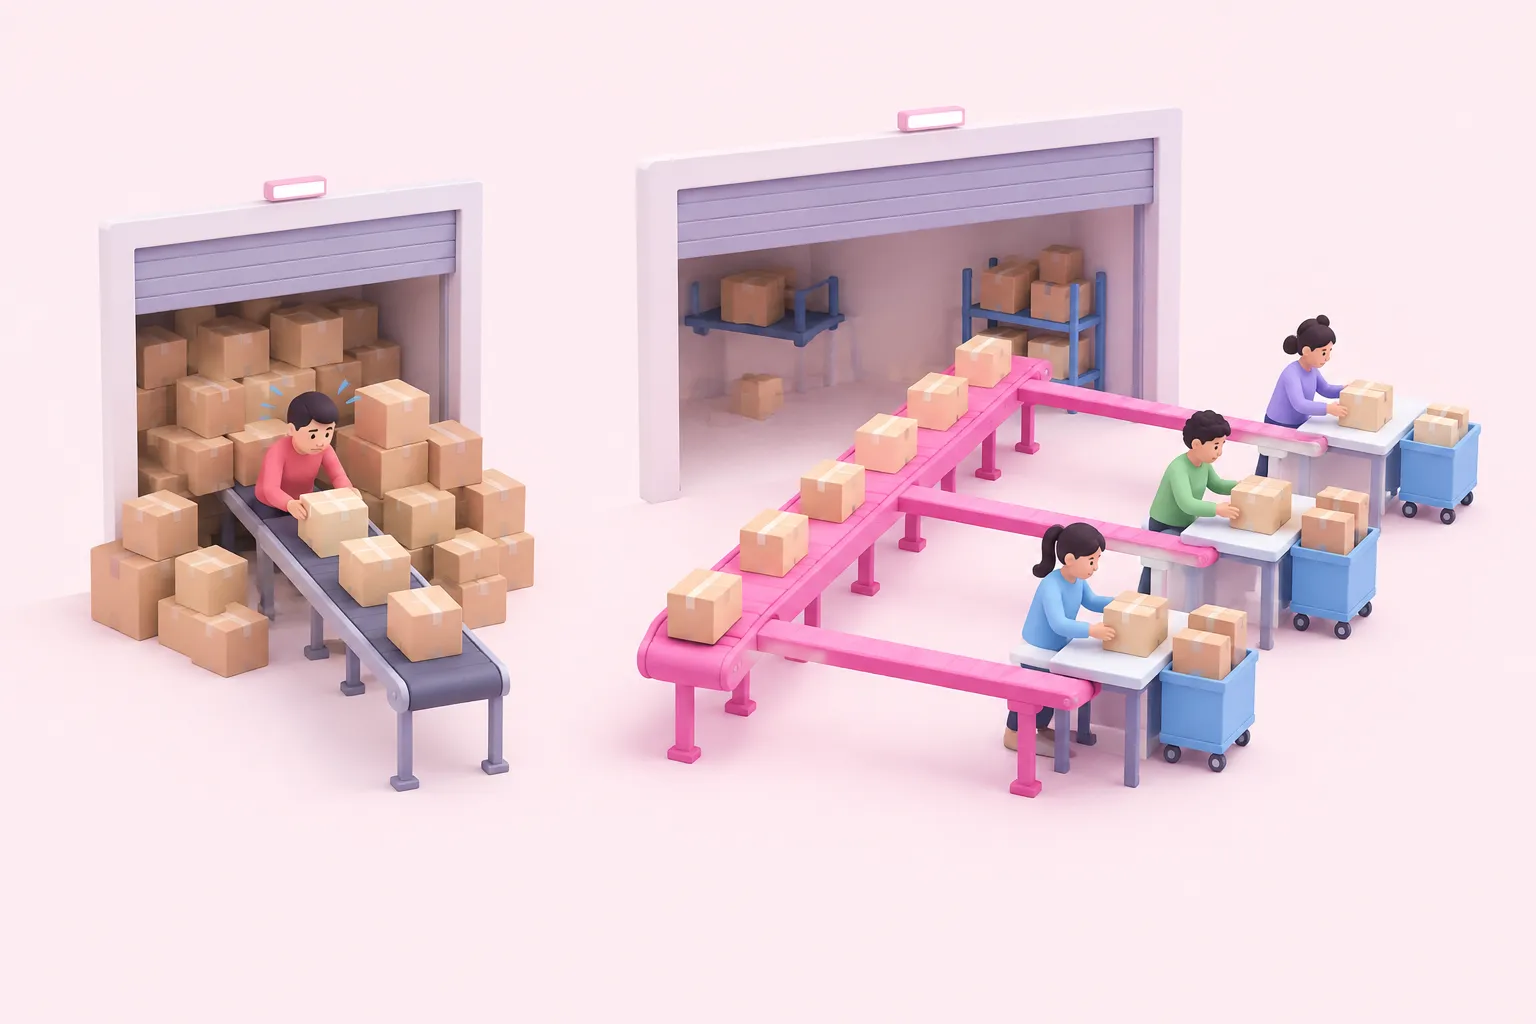
В архітектурі queue mode документація n8n стверджує, що основний інстанс (main instance) лише приймає тригери та webhook-и, тоді як окремий інстанс worker фактично виконує сам workflow. Саме це розділення дозволяє повільному або застряглому workflow виконуватися без блокування інстансу, який слухає нові webhook-викликк або рендерить UI редактора для інших користувачів. У normal mode такої ізоляції немає: прийом і виконання змагаються за один і той самий процес.
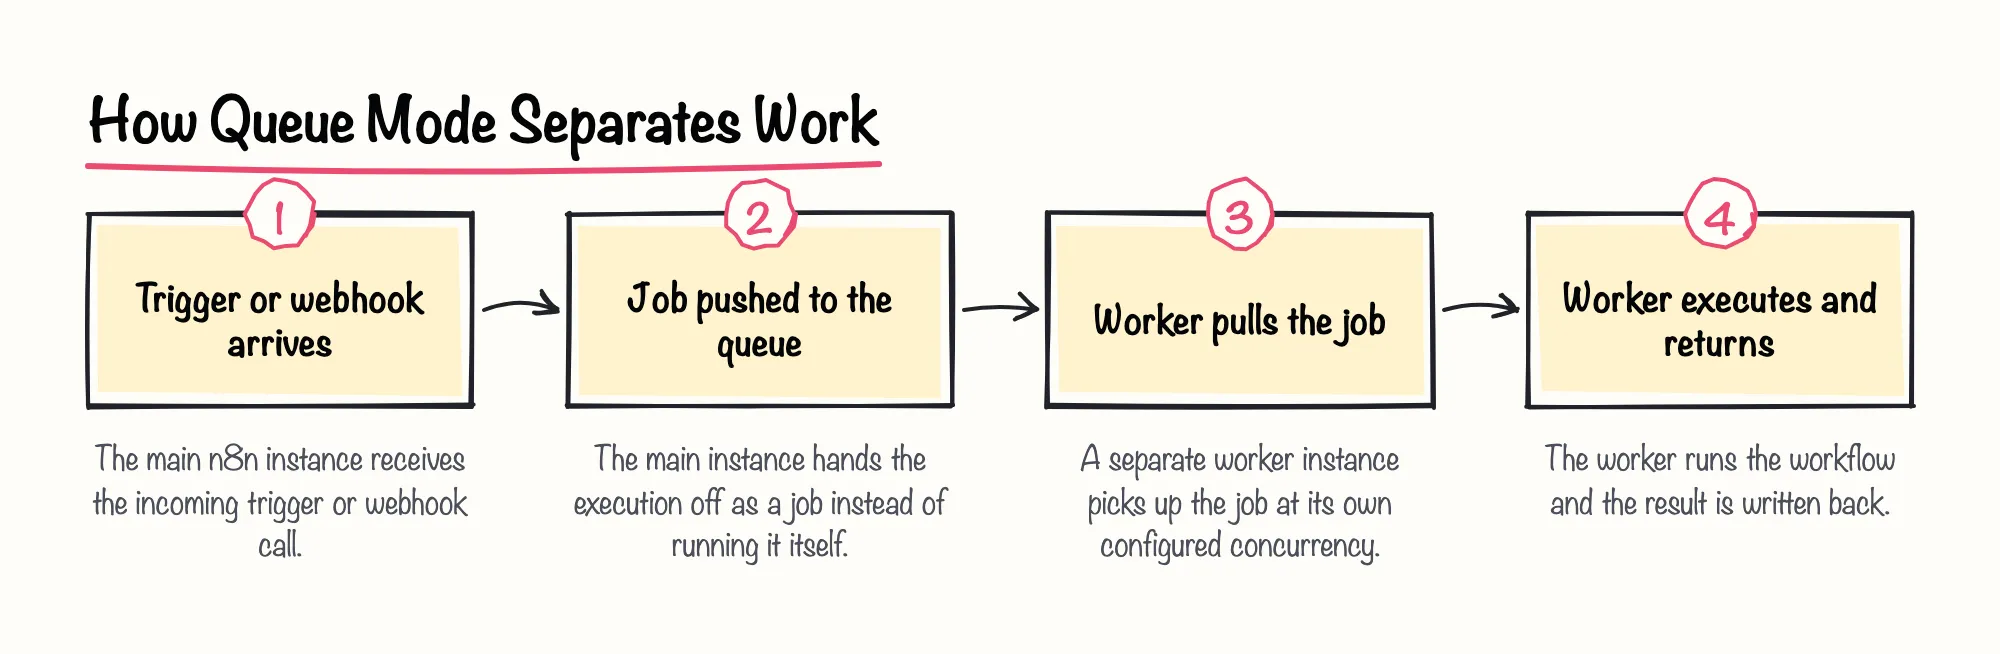
Два режими також по-різному контролюють конкурентність. Документація n8n про regular mode попереджає, що надто велика кількість одночасних production-виконань може призвести до «thrashing» event loop, погіршуючи продуктивність і відгук усього інстансу. Queue mode, натомість, дозволяє команді встановити конкурентність завдань на одного worker-а окремим флагом, тож навантаження одного worker-а автоматично не стає навантаженням усієї системи. Однак ми би обережно ставилися до того, щоб брати будь-яку конкретну кількість виконань як тригер для перемикання: власна документація n8n описує механізм thrashing event loop, не називаючи конкретний обсяг, з якого він починається, тож сигналом є симптом, а не число.
Sources: Scaling | Deploy | n8n Docs, Control concurrency | Deploy | n8n Docs, Enable queue mode | Deploy | n8n Docs
Що показує benchmark щодо пропускної здатності, відмов і бінарних даних
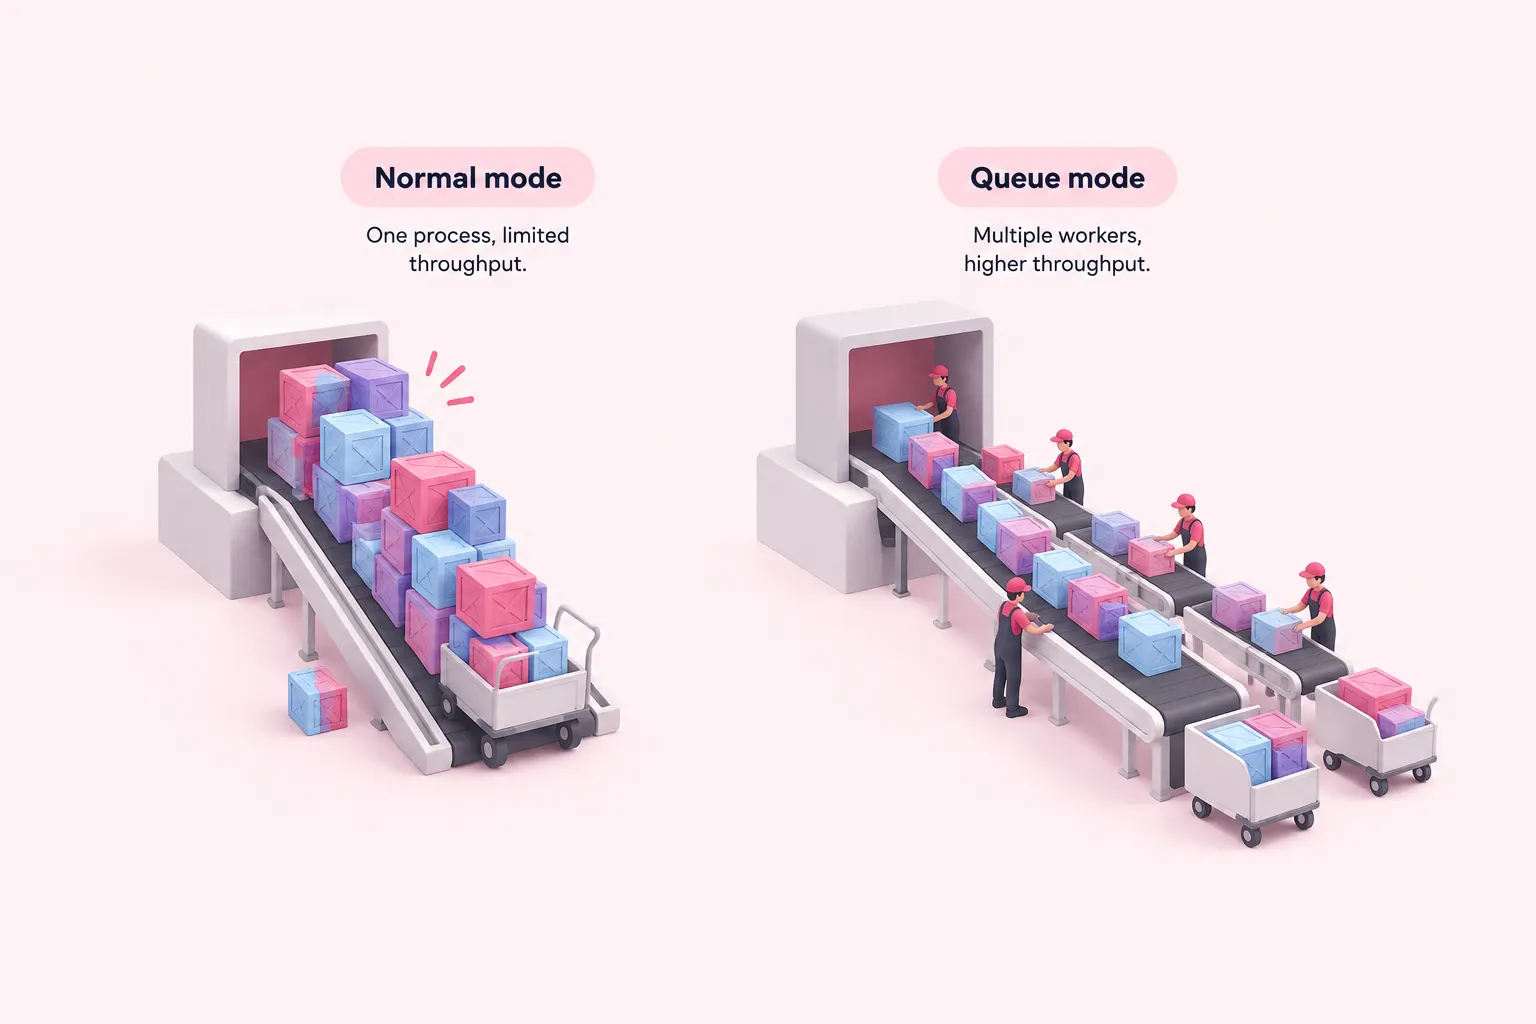
Власна документація n8n про продуктивність стверджує, що один інстанс може обробляти до 220 виконань workflow за секунду, перш ніж команді потрібно масштабуватися далі, і що багатоінстансні конфігурації покладаються на queue mode для такого масштабування. Це формулювання вже частково відповідає на питання n8n queue mode проти normal mode: normal mode не обов'язково повільний, але має стелю, пов'язану з одним процесом, а queue mode — це документований спосіб вийти за її межі.
У benchmark масштабованості n8n 2025 року зафіксовано, що на інстансі c5.large увімкнення queue mode підняло пропускну здатність Single Webhook до 72 запитів за секунду порівняно з тим самим обладнанням у normal mode.
| Рівень обладнання | Пропускна здатність Single Webhook (queue mode) | Джерело |
|---|---|---|
| c5.large | 72 запити за секунду | benchmark масштабованості n8n 2025 року |
| c5.4xlarge | 162 запити за секунду | benchmark n8n 2025 року на потужнішому обладнанні |
На більшому інстансі c5.4xlarge benchmark n8n 2025 року на потужнішому обладнанні зафіксував стабільні 162 запити за секунду в queue mode під навантажувальним тестом K6 з поступовим зростанням до 200 віртуальних користувачів. Документація n8n подає обидва результати як власний benchmark на конкретних типах інстансів, а не як гарантію для будь-якого навантаження.
На меншому рівні обладнання той самий benchmark показав, що queue mode також знизив затримку нижче трьох секунд і усунув відмови, які normal mode показував після досягнення навантаження 200 віртуальних користувачів. Наша прагматична позиція полягає в тому, що опублікована цифра, подібна до цієї, — це відправна точка, а не число для планування: ми би запустили власний фреймворк benchmarking n8n на реальних типах workflow і обладнанні команди, перш ніж визначати розмір production-потужності, оскільки синтетичне webhook-навантаження не показує, як поведеться workflow, повний логіки розгалужень або великих payload.
Бінарні дані змінюють розрахунок. Документація n8n стверджує, що queue mode не підтримує зберігання бінарних даних на локальній файловій системі, а її посібник з конфігурації бінарних даних прямо вказує перемкнути стандартний режим зберігання бінарних даних на зберігання в базі даних, щойно команда переходить на queue mode, оскільки режим файлової системи там не підтримується. Команда, яка передає великі файли або великі webhook-відповіді через свої workflow, має запланувати цю зміну зберігання до перемикання, а не після.
Sources: Measure performance | Deploy | n8n Docs, The n8n Scalability Benchmark – n8n Blog, Enable queue mode | Deploy | n8n Docs, Handle binary data | Deploy | n8n Docs
Висока доступність, обмеження за планом і що залишається незмінним
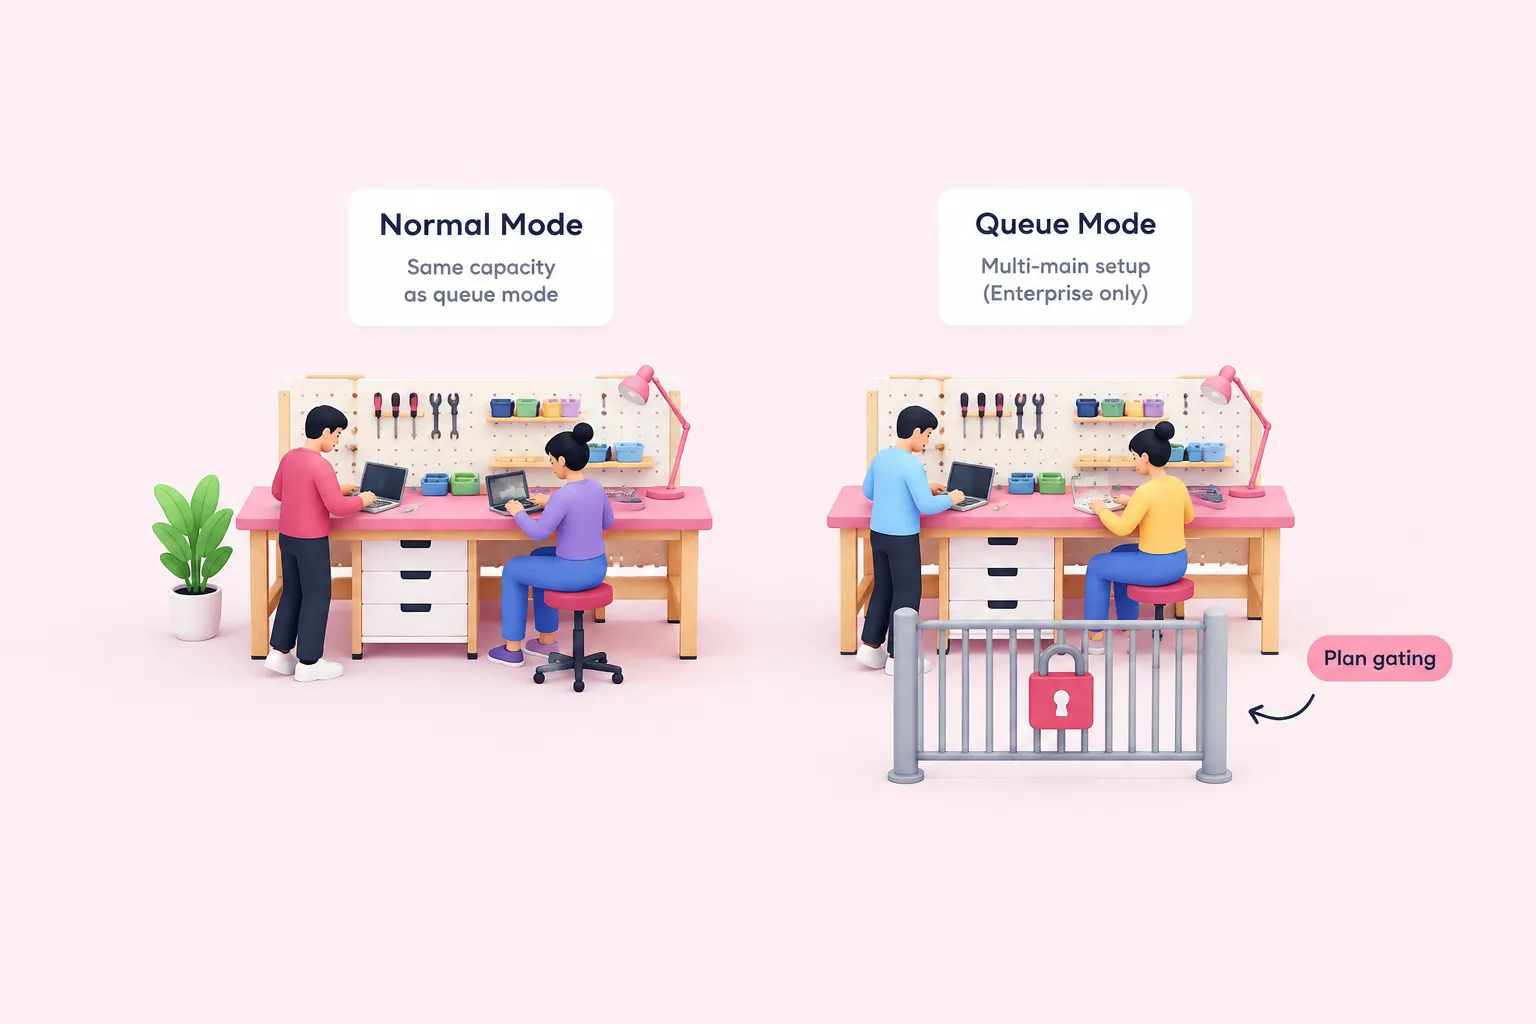
Запуск більш ніж одного основного процесу для високої доступності — це можливість, доступна лише в queue mode, за документацією n8n, і вона обмежена self-hosted Enterprise. Команда на community або не-Enterprise self-hosted ліцензії все ще може запускати worker-и, але не multi-main конфігурацію, яка усуває основний процес як єдину точку відмови.
У n8n Cloud сам queue mode обмежений планом Enterprise, і документація n8n стверджує, що його потрібно увімкнути, звернувшись безпосередньо до n8n, а не через самостійні налаштування; конкурентність там так само встановлюється на рівні worker-а — та сама логіка, що й у self-hosted queue mode.
| Критерій | Normal mode | Queue mode |
|---|---|---|
| Контроль конкурентності | Обмеження на весь інстанс; надто багато одночасних виконань може призвести до thrashing event loop | Флаг конкурентності на одного worker-а, встановлюється окремо від обмеження на весь інстанс |
| Ізоляція виконання | Прийом і виконання використовують один процес | Основний інстанс лише приймає тригери та webhook-и; окремий worker виконує |
| Зберігання бінарних даних | Підтримується зберігання у файловій системі | Зберігання у файловій системі не підтримується; стандарт потрібно перемкнути на зберігання в базі даних |
| Висока доступність (multi-main) | Не документовано як застосовне | Доступно, обмежено self-hosted Enterprise |
| Доступність у n8n Cloud | Стандартний режим виконання | Обмежено планом Enterprise; увімкнення через безпосереднє звернення до n8n |
Деякі речі не змінюються, коли команда перемикається. n8n за замовчуванням увімкнює очищення даних виконання (execution-data pruning) як у normal mode, так і в queue mode — це операційне налаштування не пов'язане з тим, який режим працює. Налаштування очищення та зберігання команди переживають перемикання незмінними, що на одну річ менше для перепроєктування.
Sources: Control concurrency | Deploy | n8n Docs, Enable queue mode | Deploy | n8n Docs, Handle binary data | Deploy | n8n Docs, Understand concurrency | Deploy | n8n Docs, Manage execution data | Deploy | n8n Docs
Сигнали, що настав час перемикатися, і чеклист для цього
Разом узяті, найчіткіший сигнал для оцінки n8n queue mode проти normal mode — це документоване попередження про event loop у поєднанні з реальною потребою масштабуватися на більш ніж один інстанс, а не конкретна кількість виконань. Ми оптимістично налаштовані щодо того, що команди, які перемикаються, коли ці сигнали з'являються, здебільшого беруть на себе операційні витрати, а не перепроєктування: самі workflow не змінюються, лише те, де і як вони виконуються.
Перш ніж виділяти інфраструктуру, варто пройти перемикання по порядку.
Документація n8n не називає єдиного порогу обсягу виконань, який би зобов'язував перемикатися, тож рішення залишається суб'єктивною оцінкою, побудованою на цих сигналах, а не фіксованим правилом.
Sources: Control concurrency | Deploy | n8n Docs, Measure performance | Deploy | n8n Docs