Ejercicio: Cloud Run frente a Kubernetes (GKE) para una instancia de práctica de n8n
Un ejercicio práctico que compara Cloud Run y Kubernetes para n8n autoalojado, midiendo arranque, almacenamiento, escalado de workers y coste en reposo.
Comprobado con las fuentes citadas el .
Ejercicio editorial: tarea y objetivo
Cloud Run frente a Kubernetes es una de las primeras decisiones que enfrentan los equipos de operaciones y TI cuando pasan de una prueba de n8n autoalojado a algo pensado para soportar tráfico real de producción. Este ejercicio editorial te ofrece una forma práctica de comparar ambas plataformas directamente, usando tu propia instancia de práctica de n8n en lugar del benchmark de otra persona. El objetivo es acotado: desplegar la misma configuración de n8n autoalojado en Google Cloud Run y en Kubernetes sobre GKE, y luego medir el tiempo de arranque, el comportamiento del almacenamiento persistente, el escalado de workers en modo cola y el coste en reposo en cada una.
Este es un ejercicio editorial identificado como tal, no un benchmark validado. Nosotros no ejecutamos estos despliegues, y ninguna fuente oficial cuantifica en segundos la latencia de arranque en frío o de inicio de pod para ninguna de las dos plataformas. Eres tú quien genera los números; los pasos siguientes solo se aseguran de que midas las mismas cosas, de la misma manera, en ambos lados.
Requisitos previos, datos de entrada y restricciones
Antes de empezar, necesitas un proyecto de Google Cloud con la facturación activada, conocimientos prácticos sobre el autoalojamiento de n8n (Docker, variables de entorno, una base de datos) y una instancia de práctica de n8n que estés dispuesto a desechar. No apuntes este ejercicio a una instancia de producción: vas a forzar reinicios, eventos de escalado a cero y redespliegues a propósito.
Acota bien el alcance. Un blog de proveedor de LOW/CODE Agency estima, en una comparativa de septiembre de 2026, que una primera configuración de n8n autoalojado basada en Docker lleva entre dos y cuatro horas, y señala aparte que el autoalojamiento de Kubernetes a gran escala añade una complejidad de configuración considerable para equipos sin experiencia en DevOps; trata esto como una estimación orientativa, no como un resultado medido, y cronometra tu propia configuración. Para este ejercicio evitaríamos intentar replicar un clúster completo de alta disponibilidad: un único node pool Standard de GKE y un único servicio de Cloud Run bastan para comparar las plataformas con honestidad.
Sources: n8n Self-Hosted vs Cloud: Which Is Right? | LOW/CODE
Cloud Run frente a Kubernetes: despliegue y medición del arranque
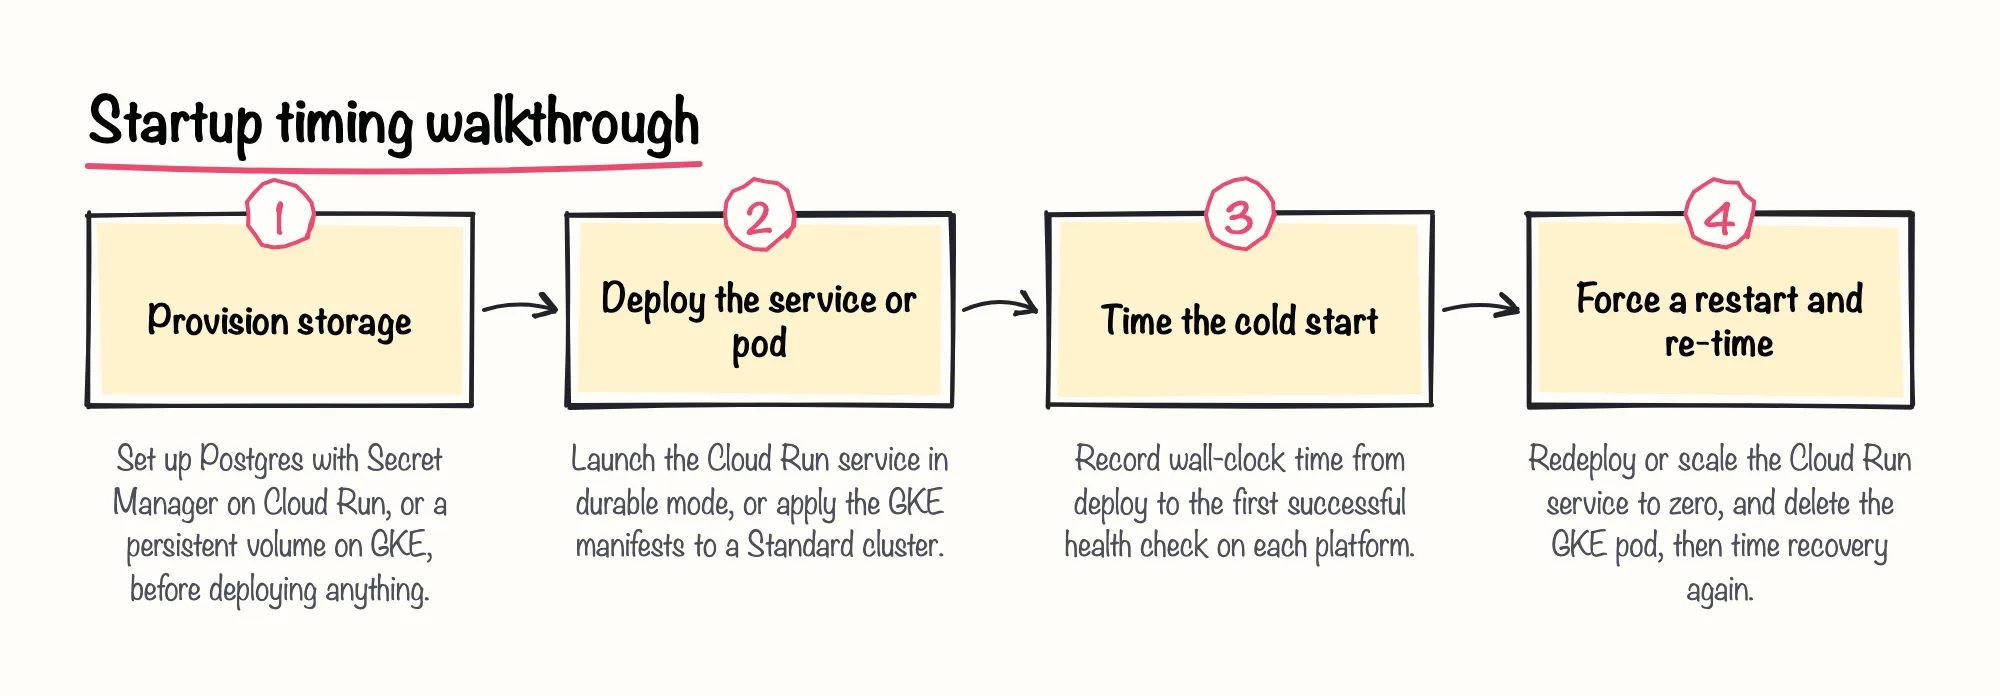
En Cloud Run, la propia guía de despliegue de n8n documenta dos modos. El modo más sencillo, «easy mode», mantiene los datos de n8n en memoria, y esos datos se pierden cada vez que el servicio de Cloud Run escala a cero o se redespliega, según la guía oficial de n8n. El modo más robusto, «durable mode», añade Postgres y Secret Manager; despliega esa vía, no el easy mode, si quieres cifras que tengan sentido para una decisión de producción. La misma guía señala que Cloud Run reserva la ruta predeterminada /healthz para sus propias comprobaciones de salud de la plataforma, lo que entra en conflicto con el endpoint de salud predeterminado de n8n, así que tendrás que configurar N8N_ENDPOINT_HEALTH antes de que el servicio se reporte como saludable.
En Kubernetes, la guía oficial de GKE de n8n exige un clúster «Standard»; n8n no funciona con un clúster Autopilot, según esa guía. La misma guía indica que el despliegue de Postgres necesita un volumen persistente para conservar los datos entre reinicios de pod. Aprovisiona ese volumen antes de empezar a cronometrar nada.
Sources: Deploy to Google Cloud Run | Deploy | n8n Docs, Deploy to Google Kubernetes | Deploy | n8n Docs
Probar el almacenamiento persistente en cada plataforma
El almacenamiento persistente es donde la brecha entre Cloud Run y Kubernetes se nota más rápido, incluso antes de llegar al escalado de workers. Ejecuta los mismos tres eventos en ambas plataformas: un reinicio normal, un redespliegue y —en Cloud Run— un escalado a cero. En la vía easy mode de Cloud Run, espera pérdida de datos en el paso de escalado a cero o de redespliegue, tal como describe la guía oficial de despliegue de n8n. En la vía durable mode, se supone que Postgres sobrevive a los tres, siempre que Secret Manager mantenga intactos los datos de conexión entre revisiones, aunque los hallazgos de este ejercicio no documentan ese resultado directamente.
En GKE, el comportamiento es más fácil de entender una vez que el volumen persistente de los propios manifiestos de n8n está en marcha, ya que el estado lo conserva el volumen y no el pod, según la guía oficial de n8n. Registra exactamente qué ocurre en cada plataforma para cada evento, en lugar de dar por hecho que alguna se comportará como su documentación sugiere.
| Plataforma / modo | Reinicio | Redespliegue | Escalado a cero |
|---|---|---|---|
| Cloud Run easy mode | Pérdida de datos (documentado) | Pérdida de datos (documentado) | Pérdida de datos (documentado) |
| Cloud Run durable mode (Postgres) | No documentado: verifícalo tú mismo | No documentado: verifícalo tú mismo | No documentado: verifícalo tú mismo |
| GKE con volumen persistente (manifiestos de n8n) | Se espera que el volumen conserve los datos, según la guía de n8n | No documentado: verifícalo tú mismo | No aplicable en la configuración de workers documentada por n8n |
Sources: Deploy to Google Cloud Run | Deploy | n8n Docs, Deploy to Google Kubernetes | Deploy | n8n Docs
Escalado de workers en modo cola: el punto débil en ambas plataformas
El modo cola vuelve a cambiar los requisitos de almacenamiento. La propia documentación de n8n indica que no se recomienda ejecutar el modo cola con una base de datos SQLite en n8n autoalojado en ningún host, y que el modo cola no admite el almacenamiento de datos binarios en el sistema de archivos. Prevé usar Postgres antes de activar el modo cola, en cualquiera de las dos plataformas, y consulta directamente la documentación de n8n sobre la opción alternativa de almacenamiento de datos binarios que describe, ya que los detalles de esa alternativa no están recogidos en la investigación de este ejercicio.
El autoescalado de los workers es donde ambas plataformas se ponen incómodas. En una publicación de julio de 2026 en el foro de la comunidad de n8n, un equipo que autoalojaba n8n en modo cola sobre Cloud Run informó de que el autoescalador de Cloud Run es completamente ciego a la profundidad de la cola de Redis, por lo que nunca añade workers bajo carga; su solución alternativa consistió en limitar cada worker a un vCPU y ejecutar un ping de salud continuo para forzar al autoescalador basado en CPU a añadir instancias. Nos parece que esa solución alternativa es un remedio razonable, pero es una señal de que la señal de autoescalado predeterminada de la plataforma no coincide con el comportamiento real de los workers de n8n.
| Opción | Señal de escalado | Limitación conocida |
|---|---|---|
| Autoescalador predeterminado de Cloud Run | Señal propia de CPU/concurrencia de Cloud Run | Un equipo de la comunidad informó que es ciego a la profundidad de la cola de Redis |
| Worker pools de Cloud Run (GA abril de 2026) | Ninguna: número fijo de workers | Sin autoescalado ni endpoint con balanceo de carga, según la documentación de Google |
| GKE con HPA basado en CPU | Uso de CPU del pod | A menudo no se activa para workers de n8n limitados por E/S, según un informe de la comunidad |
| GKE con el escalador de Redis de KEDA | Longitud de la cola de Redis / Bull | Debatido por la comunidad, no es la vía de despliegue oficial de n8n |
Kubernetes tampoco resuelve esto automáticamente. Un colaborador en un hilo del foro de la comunidad de n8n de febrero-marzo de 2026 explicó que los workers de n8n están limitados por E/S —esperan respuestas externas en lugar de consumir CPU—, razón por la cual el Horizontal Pod Autoscaling basado solo en CPU a menudo no se activa para el escalado de workers de n8n. El mismo colaborador señaló el escalador de Redis de KEDA, que vigila la longitud real de la cola, como una alternativa que merece la pena evaluar. La propia documentación de un Helm chart de n8n mantenido por la comunidad también advierte que los nodos worker que usan persistencia ReadWriteOnce no pueden usar autoescalado, por lo que la elección de almacenamiento que probaste en el paso anterior también puede bloquear el escalado sin que te des cuenta.
Hay dos vías de escape más recientes que merece la pena probar en lugar de descartar sin más. La documentación de GKE de Google indica que GKE 1.37 o posterior puede configurar el Horizontal Pod Autoscaler para escalar una carga de trabajo hasta cero réplicas cuando no hay demanda, aunque la propia guía de Kubernetes de n8n no documenta esto para los pods worker. En Cloud Run, los worker pools alcanzaron la disponibilidad general el 14 de abril de 2026 según las notas de versión de Google: una opción de despliegue sin autoescalado ni URL con balanceo de carga, según la propia documentación de worker pools de Google, que algunos equipos podrían usar para alojar workers en modo cola de forma más predecible.
En nuestra opinión, el escalador basado en Redis de KEDA es la solución más prometedora de las dos para n8n en concreto, ya que reacciona a lo que realmente importa —la profundidad de la cola— en lugar de a una señal de CPU que los workers limitados por E/S rara vez activan.
Sources: Enable queue mode | Deploy | n8n Docs, Autoscaling Queue Workers on Google Cloud Run (Redis/BullMQ) – How do you solve the HTTP-blindness? - Feedback - n8n Community, Horizontal Pod autoscaling | Google Kubernetes Engine (GKE) | Google Cloud Documentation, Redis Lists | KEDA, n8n Queue Mode Setup | OpenCharts, N8n Kubernetes Queue Mode: Jobs Not Distributed Across Multiple Workers (HPA/Scaling Not Working) - Questions - n8n Community, Implantar pools de worker no Cloud Run | Google Cloud Documentation, Cloud Run release notes | Google Cloud Documentation
Registrar el coste en reposo
Registra el coste en reposo como dos partidas separadas en lugar de una cifra combinada. En Cloud Run, la página de precios de Google indica que las instancias inactivas que no son instancias mínimas no se cobran, por lo que un despliegue de n8n con escalado a cero no debería mostrar coste de cómputo en reposo entre invocaciones, a menos que fijes una instancia mínima —algo que la guía de durable mode de n8n sugiere para reducir el riesgo de pérdida de datos—, en cuyo caso esa instancia se factura de forma continua. La misma página de precios enumera un nivel gratuito mensual de los primeros 240.000 vCPU-segundos gratis al mes para la facturación de instancias basada en CPU, según la página de precios de Cloud Run de Google, lo que reduce aún más el coste del periodo de inactividad para una instancia de práctica de bajo tráfico.
En GKE, la página de precios de Google indica que se aplica una tarifa fija de gestión de clúster de 0,10 $ por clúster y hora a todos los clústeres de GKE, independientemente del modo, el tamaño o la topología, y esa tarifa se acumula incluso mientras un clúster de GKE con n8n está en reposo, además de los nodos de cómputo que dejes en funcionamiento. Esa tarifa fija es la única partida que Cloud Run no tiene en absoluto, y merece la pena anotarla por separado en lugar de incluirla en una única cifra de «coste de GKE».
| Plataforma | Partida en reposo | Nota |
|---|---|---|
| Cloud Run, sin instancias mínimas | Sin cargo de cómputo en reposo, según la página de precios de Google | Los primeros 240.000 vCPU-segundos al mes son gratis |
| Cloud Run, con una instancia mínima fijada | Cargo continuo para esa instancia | La guía de durable mode sugiere fijar una para reducir el riesgo de pérdida de datos |
| GKE | Tarifa fija de 0,10 $ por clúster y hora | Se aplica independientemente del modo, el tamaño o la topología, además del coste de los nodos en funcionamiento |
Sources: Cloud Run pricing | Google Cloud, Google Kubernetes Engine pricing | Google Cloud
Criterios de finalización y reflexión sugerida
Has completado este ejercicio cuando tengas, para ambas plataformas: un tiempo de arranque en frío y de reinicio registrado, una tabla de almacenamiento persistente rellenada con tus propias pruebas, una configuración de escalado de workers en modo cola probada (o al menos intentada), y las dos partidas de coste en reposo desglosadas como se muestra arriba.
Una reflexión sugerida, no una conclusión verificada: los equipos con poca experiencia en Kubernetes pueden encontrar que el durable mode de Cloud Run se pone en marcha más rápido, mientras que los equipos que ya operan GKE para otras cargas de trabajo pueden encontrar más fácil asumir la tarifa del clúster y las limitaciones de los worker pools que adoptar una nueva plataforma serverless. Tomar esta decisión de Cloud Run frente a Kubernetes para producción probablemente tenga menos que ver con el tiempo de arranque o el coste en reposo y más con qué modo de fallo de escalado de workers puede asumir y solucionar tu equipo, ya que la configuración predeterminada de ninguna de las dos plataformas funciona claramente todavía para el modo cola de n8n.