Lista de comprobación para preparar n8n autoalojado para producción
Una lista de comprobación práctica para verificar la asignación de responsabilidades, la persistencia, el cifrado, HTTPS, el enrutamiento de webhooks, las actualizaciones, la monitorización y la recuperación antes de autoalojar n8n.
Comprobado con las fuentes citadas el .
Confirma la asignación de responsabilidades y los prerrequisitos del despliegue
Empieza por diferenciar la preparación del workflow de la preparación operativa. Que un workflow funcione correctamente durante las pruebas no significa automáticamente que esté listo para un entorno de producción autoalojado. El autoalojamiento requiere conocimientos técnicos, y el equipo que lo opera debe tomar decisiones deliberadas sobre la infraestructura, el estado, el mantenimiento y el soporte.
Comprueba que el host, la base de datos, la clave de cifrado, los certificados, las actualizaciones, la monitorización, la respuesta ante incidentes y la recuperación tengan cada uno un responsable designado. Este es un criterio editorial de aceptación, no un requisito establecido por las fuentes proporcionadas. Considera completada esta comprobación cuando cada responsabilidad tenga un responsable, un procedimiento documentado y un contacto de respaldo o una vía de escalado.
Documenta la topología prevista y las suposiciones sobre la carga de trabajo. Algunas preguntas sugeridas son: ¿Qué procesos se ejecutarán? ¿Dónde residirá el estado? ¿Qué concurrencia se espera? ¿Qué límite de recursos es aceptable? ¿Quién asume el coste de la infraestructura y las interrupciones planificadas? Las pruebas proporcionadas no establecen un umbral de dimensionamiento independiente de la organización. Uno de los módulos de AWS referenciados muestra por qué importan los límites: una capacidad mínima puede generar costes continuos, mientras que un máximo estricto puede dejar trabajo pendiente, pero su configuración no puede generalizarse a todos los despliegues.
Registra la versión exacta del workflow, las dependencias, las integraciones, las variables de entorno y los endpoints de producción incluidos en la aprobación. La comprobación estará completa cuando los revisores puedan identificar qué se va a promover, quién lo operará y qué suposiciones todavía deben validarse.
Protege el estado persistente y el cifrado de credenciales
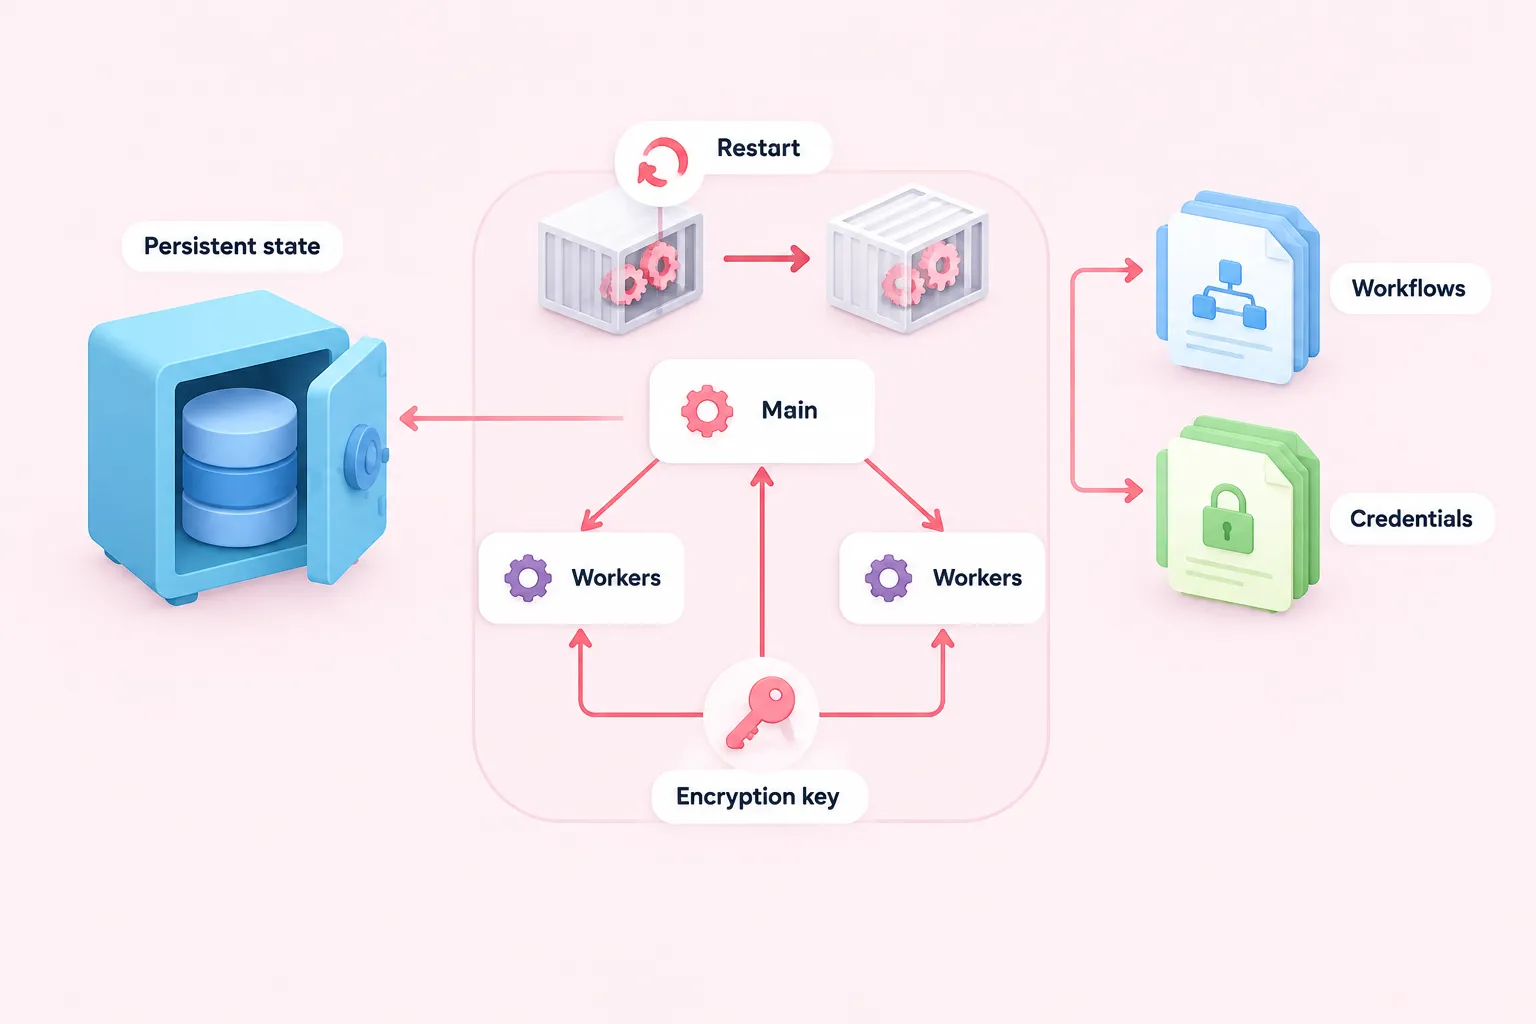
Comprueba que el almacenamiento persistente conserve el directorio de datos de n8n tras los reinicios de los contenedores. La guía de Docker proporcionada monta almacenamiento persistente en el directorio de datos de n8n, aunque esa página está marcada como desactualizada y recomienda Docker Compose. Considera la ruta como prueba de que la persistencia importa, no como una arquitectura de producción completa.
Documenta todos los almacenes de estado que use la topología elegida, incluidos la base de datos y los datos persistentes de la instancia. Realiza un reinicio controlado y confirma que los workflows, las credenciales y la configuración necesaria esperados sigan disponibles. Esta prueba de finalización es una sugerencia editorial; la fuente no demuestra que un entorno concreto vaya a conservar todos los componentes necesarios.
Configura una clave de cifrado para la instancia y consérvala mediante un proceso aprobado de gestión de secretos. En queue mode, todos los workers deben recibir la misma clave para que las credenciales almacenadas sigan siendo utilizables. Entre las comprobaciones sugeridas están confirmar que la clave no aparezca en el control de versiones ni en los registros de pruebas, que el acceso esté restringido y que exista una vía de recuperación autorizada. Estas prácticas de gestión son salvaguardas editoriales porque las pruebas proporcionadas no prescriben la integración con un gestor de secretos, la custodia, los controles de acceso ni la rotación periódica.
Si el equipo tiene previsto rotar la clave de cifrado, crea primero una copia de seguridad completa de la base de datos y verifica que el proceso principal y todos los workers usen claves coherentes. La guía de rotación proporcionada describe esta acción como una operación unidireccional, por lo que debes registrar la decisión y el plan de recuperación antes de continuar. La comprobación estará completa cuando las credenciales sigan descifrándose después de reinicios controlados y no aparezca ningún material de la clave en el paquete de pruebas.
Configura HTTPS y el enrutamiento público de webhooks
Coloca delante de n8n una capa compatible de terminación TLS. La guía proporcionada recomienda un reverse proxy o un network load balancer que gestione TLS y la renovación de certificados. No establece conjuntos de cifrado, versiones de protocolo, autoridades certificadoras ni reglas de acceso a la red obligatorios, por lo que tu equipo de seguridad deberá definirlos por separado.
Asigna la responsabilidad de emitir y renovar los certificados y, a continuación, prueba mediante HTTPS los endpoints del editor y de los webhooks visibles desde el exterior. La comprobación estará completa cuando los clientes accedan de forma segura al endpoint previsto y el responsable pueda explicar cómo se detectarán y gestionarán los fallos de renovación. La prueba operativa y el requisito de asignación de responsabilidades son comprobaciones editoriales de aceptación.
Detrás de un reverse proxy, configura la URL externa del webhook y el número de saltos de proxy de acuerdo con la ruta de enrutamiento real. El número documentado de un salto se aplica a una configuración con un único proxy y no debe copiarse sin más en una cadena más compleja. Verifica que el editor muestre la URL pública prevista para el webhook y que una solicitud de prueba externa llegue al workflow correcto similar al de producción.
Usa un payload de prueba no destructivo y evita dirigir un simulacro de preparación hacia acciones reales en sistemas posteriores. Esta es una precaución de prueba sugerida, no un estándar de pruebas de n8n validado. Registra la URL solicitada, la respuesta observada, la ejecución del workflow y cualquier encabezado del proxy necesario para solucionar problemas.
Establece un procedimiento de actualización por etapas
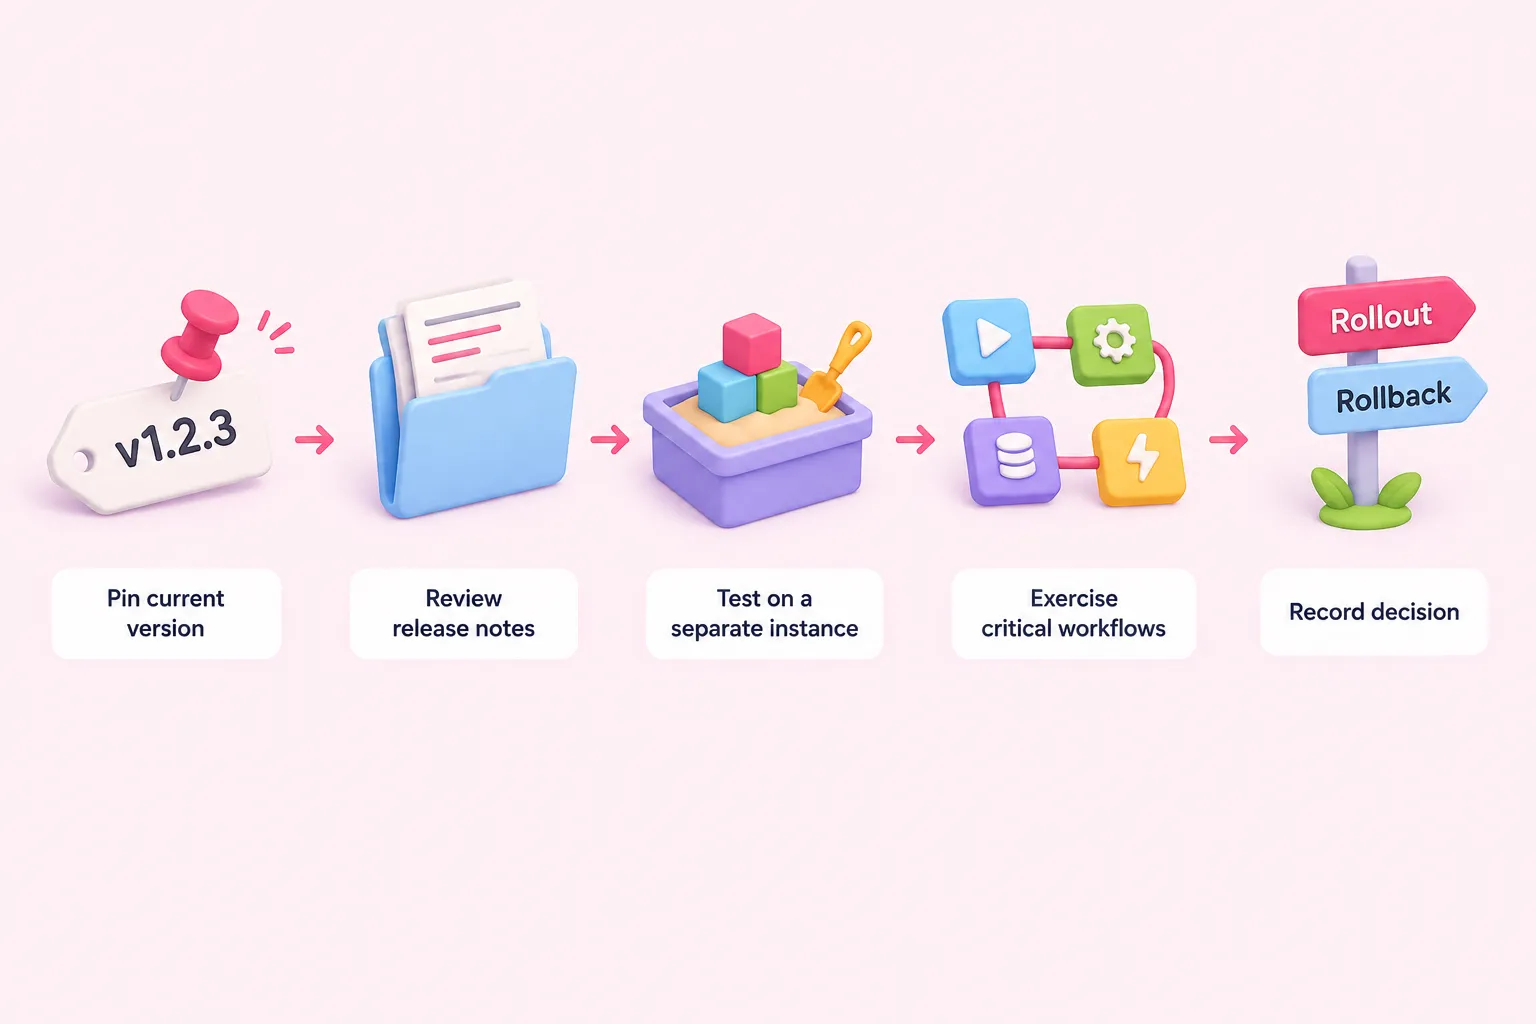
Fija la versión utilizada en producción y define una ruta de promoción repetible. Antes del despliegue, revisa las notas de la versión para detectar breaking changes y prueba la actualización en una instancia separada. La guía proporcionada respalda las pruebas por etapas, pero no define una ventana de mantenimiento, un método de rollback ni una suite de compatibilidad universales.
Crea una lista editorial de pruebas para los workflows importantes para tu equipo. Entre las comprobaciones sugeridas están los triggers, las credenciales, las transformaciones de datos, las rutas de error, las llamadas a APIs posteriores, el registro de webhooks y un volumen de ejecución representativo. Estas son áreas de cobertura propuestas, no un instrumento validado ni un estándar obligatorio.
Define el rollback antes del despliegue, no durante un incidente. Registra la versión actual, la versión de destino, los hallazgos relevantes de las notas de la versión, la referencia de la copia de seguridad, los resultados de las pruebas, la persona responsable de la decisión y el desencadenante del rollback. La comprobación estará completa cuando la versión seleccionada haya superado las pruebas documentadas por el equipo y el operador asignado pueda ejecutar la decisión de recuperación.
Sources: S2
Configura la monitorización del estado y las alertas de fallos de workflows
Monitoriza tanto el estado del servicio como los resultados de los workflows. Un chart de Kubernetes proporcionado habilita liveness probes y readiness probes, lo que demuestra que esos endpoints pueden funcionar como señales de estado en dicho chart. La fuente es específica de ese chart y está truncada, por lo que habilitar las probes por sí solo no demuestra que la monitorización, la entrega de alertas, la retención o la cobertura operativa sean adecuadas.
Conecta las señales de estado a una vía de notificación a cargo de una persona o un equipo. Por separado, configura un workflow de errores que comience con Error Trigger para que las ejecuciones fallidas puedan avisar a los operadores. La documentación ofrece el correo electrónico y Slack como ejemplos, pero no demuestra que se haya entregado ninguna alerta ni que alguien haya actuado ante ella en un despliegue real.
Realiza dos comprobaciones controladas: provoca deliberadamente el fallo de un workflow de prueba seguro y simula una instancia en mal estado en un entorno que no sea de producción. Considera que la monitorización está preparada únicamente cuando ambas condiciones generen notificaciones comprensibles y accionables que reciba el equipo responsable. Este es un criterio editorial de finalización; cada organización debe elegir su propia latencia de alertas, sus reglas de escalado, su retención y el tiempo de inactividad aceptable.
Registra quién confirma la recepción de las alertas, dónde puede encontrarse la información de diagnóstico y qué sucede fuera del horario laboral habitual. No consideres que un dashboard en verde o un nodo de notificación configurado demuestran que el proceso de respuesta funciona.
Haz copias de seguridad del estado y completa un simulacro de recuperación
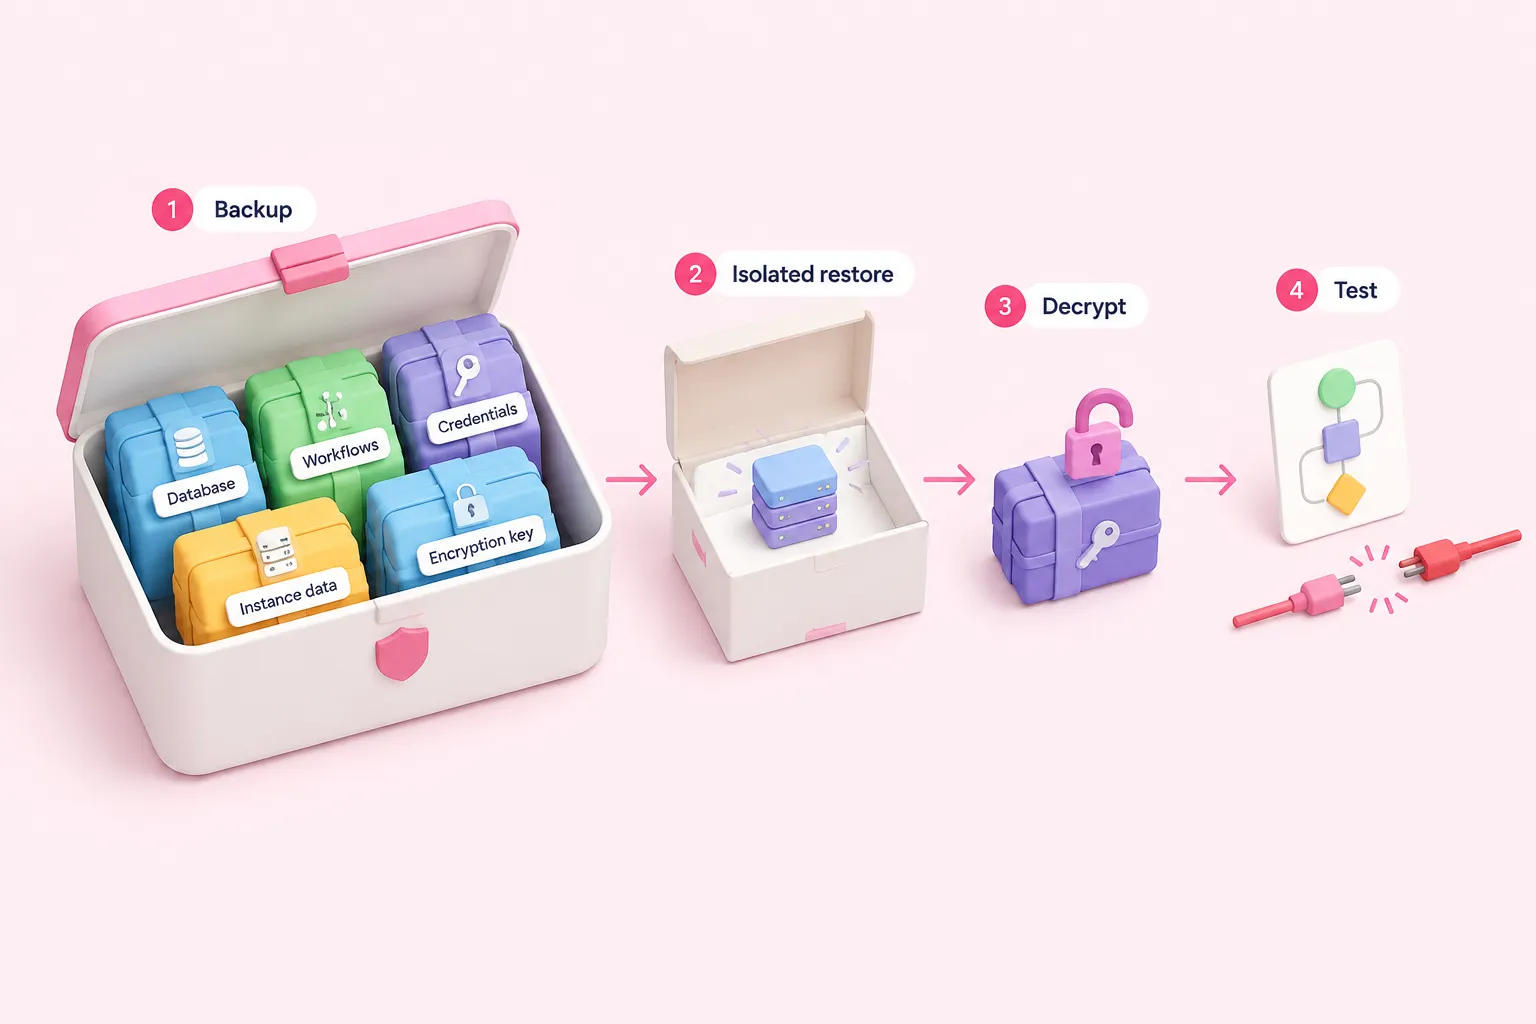
Crea copias de seguridad protegidas que incluyan la base de datos, los workflows, las credenciales, los datos persistentes de la instancia y la clave de cifrado. La CLI autoalojada permite exportar e importar workflows y credenciales, lo que puede contribuir a un proceso de copia de seguridad lógica. Las exportaciones por sí solas no demuestran que la recuperación sea posible, y exportar credenciales descifradas expone material sensible.
Planifica cuidadosamente las importaciones porque pueden sobrescribirse los identificadores coincidentes. Mantén los simulacros de restauración aislados de los endpoints y sistemas posteriores de producción. El requisito de aislamiento es una medida editorial de seguridad, mientras que los riesgos de sobrescritura y exposición de credenciales proceden de la guía de la CLI proporcionada.
Realiza un simulacro de recuperación aislado en lugar de detenerte tras crear la copia de seguridad. Las comprobaciones sugeridas son que la instancia restaurada se abra, aparezcan los workflows esperados, las credenciales se descifren y un workflow representativo se ejecute correctamente sin contactar con endpoints de producción. No se proporcionó ninguna prueba directa de recuperación, por lo que estas comprobaciones son criterios de aceptación propuestos y no pruebas de que algún despliegue las haya superado.
Registra el alcance de la copia de seguridad, el responsable del almacenamiento, los permisos de acceso, los pasos de restauración, los resultados observados y las carencias sin resolver. Tu organización debe elegir la frecuencia de las copias de seguridad, la retención, los objetivos de recuperación y la pérdida de datos aceptable porque las fuentes proporcionadas no establecen umbrales universales.
Registra las pruebas de aprobación y los riesgos pendientes
Reúne en un único registro de aprobación los responsables, la topología, la prueba de persistencia, la gestión de la clave de cifrado, las comprobaciones de HTTPS y webhooks, los resultados de la actualización por etapas, las simulaciones de alertas, la referencia de la copia de seguridad y el resultado del simulacro de recuperación. Marca cada elemento como aprobado, aceptado con condiciones o bloqueado e identifica a la persona que acepta cualquier riesgo residual.
Trata esta lista de comprobación como una revisión operativa específica, no como una auditoría completa de cumplimiento o seguridad. Cubre las áreas solicitadas de preparación para producción, pero no demuestra niveles medidos de fiabilidad, seguridad, ahorro de costes, tiempo de inactividad aceptable ni rendimiento de recuperación. Los requisitos derivados de queue mode, Kubernetes, módulos de AWS, operaciones de la CLI o la rotación de claves solo deben aplicarse cuando la topología seleccionada los utilice.
Antes de la aprobación, vuelve a ejecutar el propio workflow en un entorno seguro y confirma que su comportamiento coincida con la versión que se va a promover. Mantén esta práctica en el nivel de la aplicación separada de la aprobación de la infraestructura: completar un ejercicio de automatización no demuestra que los controles de alojamiento, monitorización o recuperación estén preparados.