Lista de comprobación para probar workflows de n8n: qué verificar antes de usarlos de verdad
Una lista de comprobación práctica para probar datos de ejemplo, ramas, fallos de API, detalles de ejecución y gestión automática de errores antes de utilizar un workflow de n8n.
Comprobado con la documentación de n8n el .
1. Define el resultado esperado antes de probar
Empieza por anotar qué debería hacer el workflow en cada prueba prevista. Especifica el resultado final esperado, los valores intermedios importantes, la rama de destino prevista, los efectos secundarios permitidos y el resultado de aprobado o fallido. Estas son sugerencias editoriales para realizar pruebas, no estándares obligatorios de n8n. Su propósito es hacer que la finalización sea observable, en lugar de depender de si el canvas parece ejecutarse correctamente.
Utiliza datos de prueba que no estén activos ni sean sensibles siempre que resulte práctico. n8n admite mocked data para simular entradas y pinned data para reutilizar datos de prueba simulados o reales durante el desarrollo. Recuerda que los pinned data son una ayuda para el desarrollo y no están disponibles durante las ejecuciones de producción, por lo que una ejecución correcta con pinned data no demuestra que el workflow en vivo esté preparado.
Comprobación completada: cada caso previsto tiene un resultado esperado por escrito, los datos de prueba están claramente separados de los datos en vivo y todos los efectos secundarios permitidos están identificados antes de la ejecución. Si tu plan y tus permisos admiten entornos separados de desarrollo y producción, puedes utilizarlos como medida de aislamiento adicional, pero esto es opcional y no un requisito previo universal.
2. Prueba con datos de ejemplo representativos
Crea un conjunto compacto de entradas que refleje los riesgos de este workflow concreto. Algunas categorías sugeridas son un registro normal, valores ausentes, valores mal formados, una entrada vacía, valores límite significativos y duplicados. Estas categorías son orientaciones editoriales, no un instrumento validado ni un conjunto de datos mínimo oficial. Añade o elimina casos según las transformaciones, integraciones y decisiones de tu workflow.
En cada caso, inspecciona más que el último nodo. Compara la entrada y la salida de cada transformación importante con la expectativa que registraste. Comprueba si los nombres de los campos, los tipos de datos, las colecciones vacías y el tratamiento de duplicados siguen siendo adecuados para el nodo siguiente. Cuando fijes datos, etiqueta el escenario con suficiente claridad para que otra persona pueda entender qué condición representa.
Comprobación completada: se han ejecutado entradas normales y excepcionales relevantes para el workflow, las salidas observadas coinciden con las expectativas escritas y cada discrepancia se ha corregido o registrado como una limitación aceptada con su motivo.
Sources: S6
3. Verifica cada ruta condicional
Crea una entrada que acceda deliberadamente a cada rama, en lugar de esperar que distintos datos de ejemplo alcancen todas las rutas por casualidad. En cada ruta, verifica el nodo terminal, la salida transformada y los efectos secundarios previstos. Confirma también que los nodos de otras rutas no hayan realizado ninguna acción imprevista.
Ten en cuenta el orden de ejecución al interpretar los resultados. Los workflows creados a partir de n8n 1.0 ejecutan las ramas de una en una siguiendo el orden del canvas, aunque los workflows más antiguos o con ajustes modificados pueden comportarse de otra manera. Si dos ramas pueden afectar al mismo registro externo, anota la versión del workflow y los ajustes pertinentes en lugar de asumir que la ubicación visual basta para demostrar el orden.
Comprobación completada: cada ruta se ha observado con una entrada reconocible, su destino y salida son correctos y no se ha producido ninguna rama ni efecto secundario inesperado.
Sources: S8
4. Prueba los casos relevantes de fallo de API
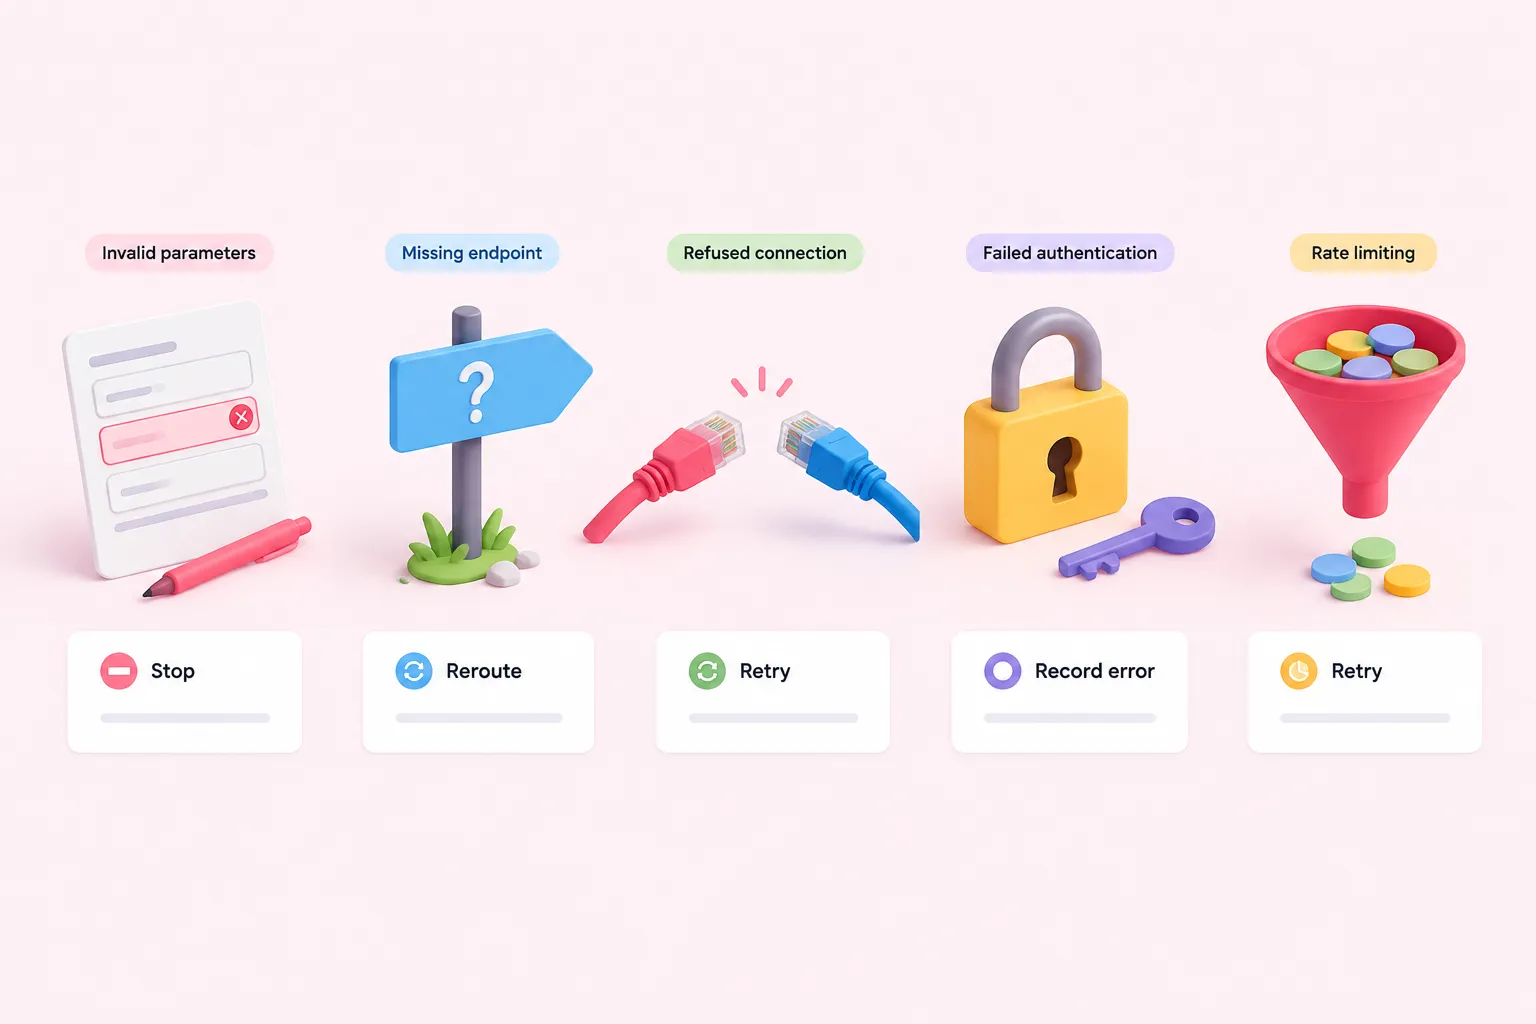
Enumera los fallos importantes para cada integración de API y crea después pruebas controladas cuando sea seguro hacerlo. Entre los casos sugeridos útiles se incluyen parámetros no válidos, un endpoint ausente o no válido, conexiones rechazadas, errores de autenticación y límites de frecuencia. La documentación del nodo HTTP Request distingue estos tipos de fallos, pero su relevancia y el método seguro para probarlos dependen de la API utilizada.
Antes de ejecutar cada caso, decide el comportamiento previsto: detenerse inmediatamente, reintentar, seguir una ruta alternativa o registrar un error que permita actuar. Después, contrasta el comportamiento observado con esa decisión. No consideres suficiente un mensaje de fallo genérico si se esperaba que el workflow conservara el contexto o evitara un efecto secundario parcial.
Comprobación completada: cada fallo de API relevante que pueda reproducirse de forma segura tiene una respuesta esperada; la detención, el reintento, la ruta alternativa o el registro del error observados coinciden con ella; y los casos no probados figuran explícitamente como riesgos sin resolver.
Sources: S4
5. Inspecciona las ejecuciones y el comportamiento de los reintentos
Revisa la ejecución después de cada caso. Registra su estado, el último nodo completado correctamente, la ubicación del fallo cuando corresponda y las entradas y salidas significativas de los nodos. La lista de ejecuciones puede filtrarse para mostrar un workflow concreto, lo que facilita la revisión cuando una instancia gestiona varias automatizaciones.
Cuando exista compatibilidad y la configuración sea adecuada, los datos de una ejecución anterior pueden cargarse en el editor para depurar y volver a ejecutar una ejecución de producción fallida. Su disponibilidad depende del plan o registro de n8n y de si se guardó la ejecución, así que no conviertas esta función en el único método de depuración de tu lista de comprobación.
Al probar reintentos, distingue entre una corrección reproducible del workflow y un éxito transitorio. Anota qué datos se reutilizaron, qué cambió y si otro intento produjo el resultado esperado sin repetir un efecto secundario no deseado.
Comprobación completada: cada prueba tiene un resultado de ejecución rastreable, se comprenden las ubicaciones de los fallos y cualquier comportamiento de reintento se ha observado y documentado en lugar de presuponerse.
6. Activa y verifica el workflow automático de errores
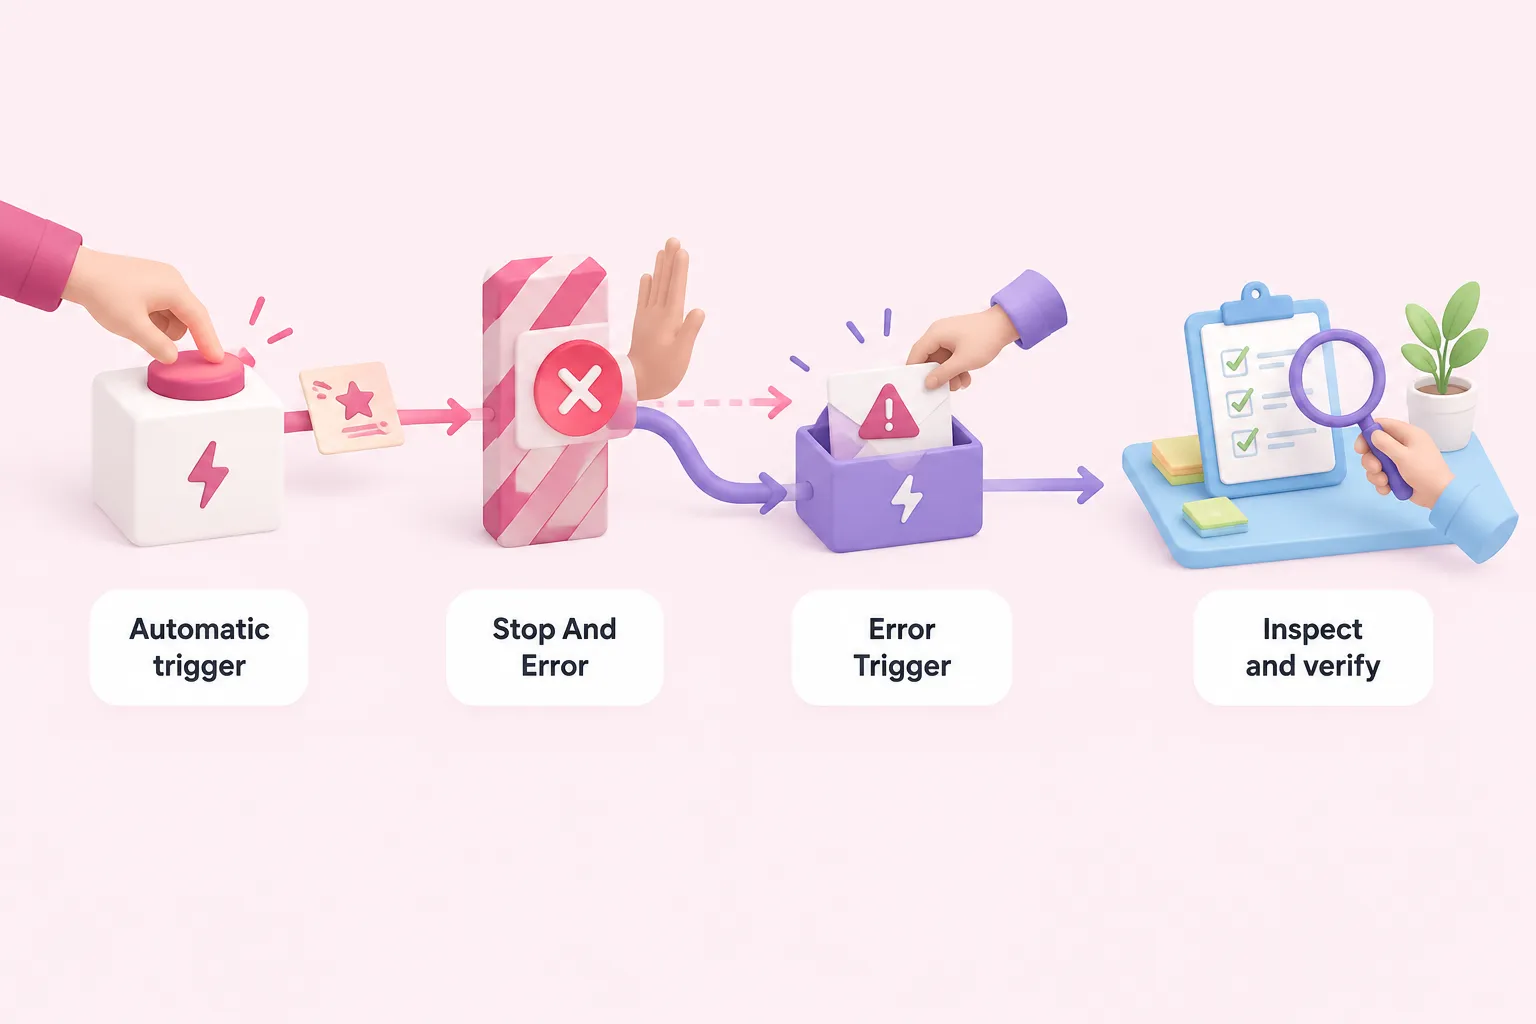
Selecciona un workflow de errores en los ajustes del workflow principal y asegúrate de que comience con un Error Trigger. Su función es ejecutarse tras el fallo de una ejecución, pero su mera presencia en la configuración no demuestra que una notificación, un paso de recuperación u otra respuesta vayan a funcionar.
Realiza la prueba mediante un contexto de ejecución automática, porque ejecutar manualmente un workflow no activa Error Trigger. Cuando resulte apropiado provocar un fallo controlado, un nodo Stop And Error puede hacer que la ejecución principal falle deliberadamente y transmitir información de prueba reconocible al workflow de errores. Utiliza un contexto de prueba claramente marcado para poder distinguir la ejecución resultante de un incidente real.
Inspecciona ambos lados de la prueba. Confirma que la ejecución principal falló en el punto previsto y, después, que el workflow de errores recibió suficiente contexto y llevó a cabo la respuesta prevista. Verifica por separado la entrega de notificaciones o la recuperación; provocar deliberadamente un error no demuestra que esas acciones posteriores funcionaran ni que los efectos secundarios parciales se gestionaran de forma segura.
Comprobación completada: una ejecución de prueba automática falla según lo previsto, Error Trigger inicia el workflow de errores configurado, llega el contexto esperado y cada respuesta posterior prevista se observa de manera independiente.
7. Toma una decisión explícita sobre la preparación
Reúne los resultados en un registro de pruebas sencillo que contenga el caso, el resultado esperado, el resultado observado, el estado de aprobado o fallido y cualquier riesgo sin resolver. Para esta lista de comprobación editorial, las pruebas solo están completas cuando cada caso documentado se ha aprobado o tiene una limitación aceptada explícitamente, se ha observado cada ruta prevista, los fallos relevantes de API se comportan según lo diseñado y un fallo automático activa el workflow de errores.
Una lista de comprobación completada demuestra lo que examinaste, no que no puedan producirse incidentes. La documentación aportada describe las funciones y mecanismos de n8n, pero no proporciona evidencia controlada de que estas comprobaciones eviten fallos en producción. La cobertura del conjunto de datos, los efectos secundarios permitidos, la política de reintentos, el destino de las alertas y el umbral de publicación siguen siendo decisiones de las personas responsables del workflow.
Si un elemento sin resolver pudiera modificar datos o activar una acción externa, registra quién acepta ese riesgo y por qué antes de depender del workflow en un proceso real. Termina con una decisión clara: preparado para el uso definido, preparado con limitaciones aceptadas o no preparado hasta completar el trabajo especificado.