Витягування тексту з PDF у n8n: редакційна вправа з OCR і перевірки
Попрактикуйте витягування тексту з PDF у n8n: текстові й скановані документи, окремі гілки помилок і ручне схвалення перед подальшим використанням.
Перевірено за наведеними джерелами .
Визначте завдання з витягування тексту з PDF у n8n
Ця редакційна вправа пропонує спроєктувати й продемонструвати витягування тексту з PDF у власному середовищі n8n: спрямувати текстовий PDF до Extract From File, сканований PDF — до Mistral AI, а непридатні результати затримати перед подальшим використанням. Запропоновану вправу тут не виконували й не перевіряли.
Для початку потрібні доступ до відповідних вузлів, наявне джерело бінарних файлів і налаштовані облікові дані Mistral. У документації n8n щодо облікових даних зазначено, що для активації ключів API Mistral потрібні платіжні дані й активовані платежі. Вправа починається після отримання файлів; створення інтерфейсу завантаження й автоматичне визначення типів PDF виходять за її межі.
На нашу думку, найкорисніша навчальна мета — розуміти, коли слід затримати результат обробки документа, а не просто домогтися появи тексту.
Sources: How to Extract Text and Structured Data From PDFs in n8n, n8n-docs/docs/integrations/builtin/app-nodes/n8n-nodes-base.mistralai.md at main · n8n-io/n8n-docs · GitHub, n8n-docs/docs/integrations/builtin/credentials/mistral.md at main · n8n-io/n8n-docs · GitHub
Підготуйте позначені тестові документи й еталонний текст
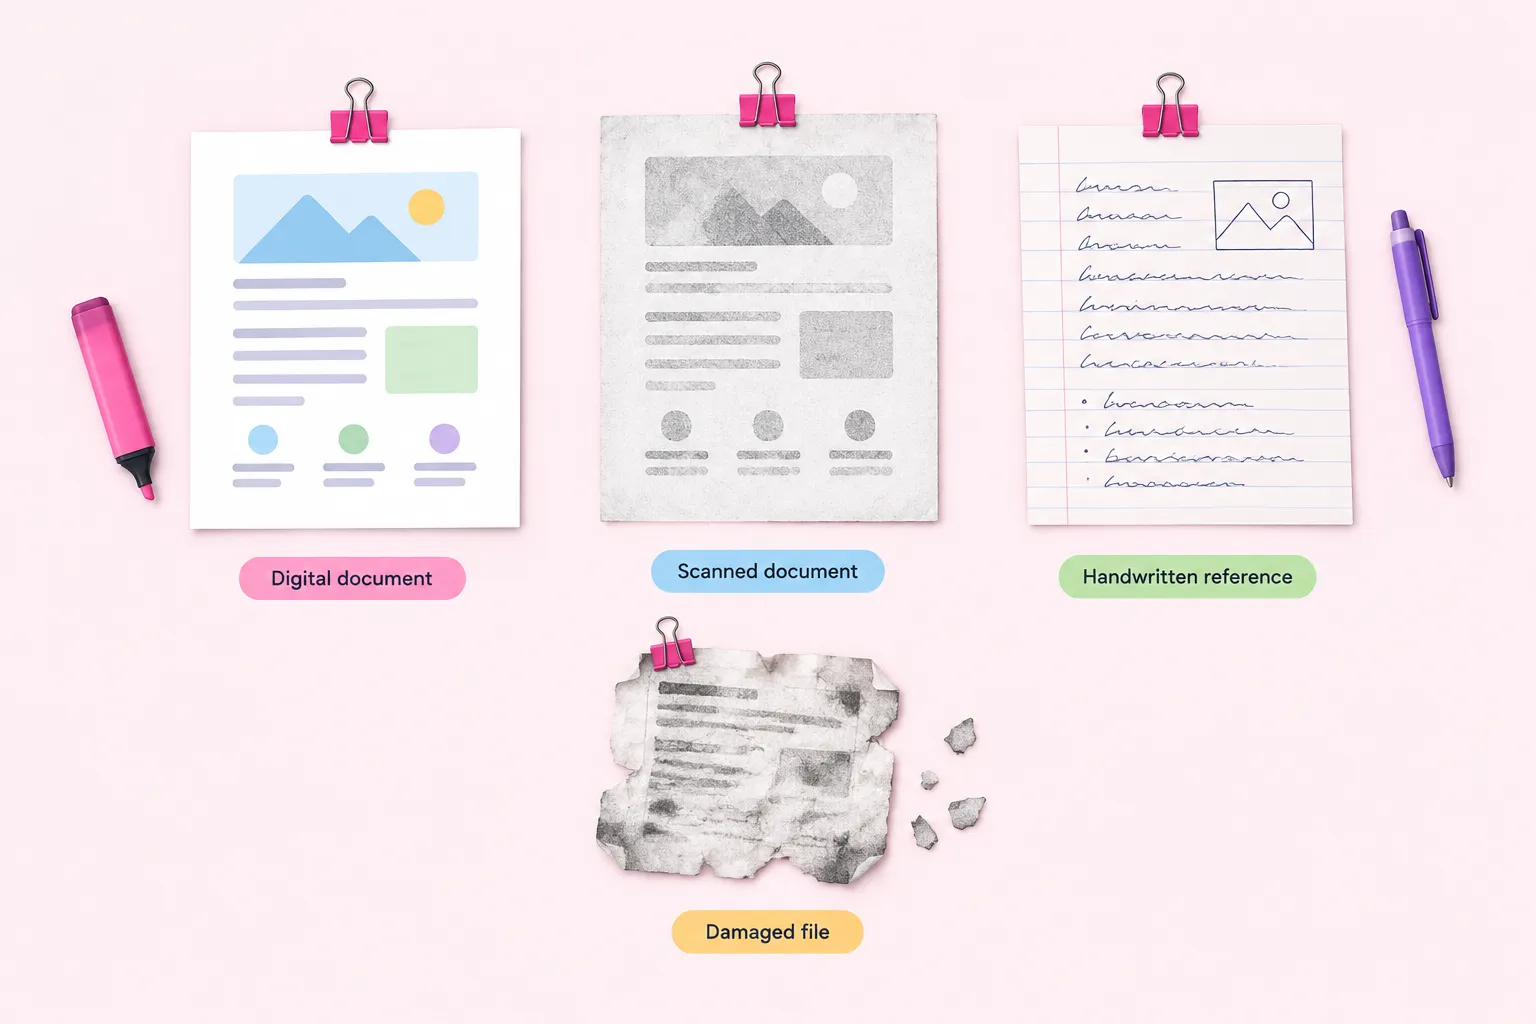
Використовуйте синтетичні документи без конфіденційних даних: надані джерела не підтверджують строки зберігання даних провайдером, місце їх зберігання чи договірні гарантії конфіденційності. Вручну позначте маршрут кожного тестового документа й збережіть оригінал для порівняння. Ці запропоновані вхідні дані визначають вправу, а не становлять перевірений набір тестів.
Підготуйте наведені нижче тестові документи. iTechGuides пояснює, що сторінки, які містять лише зображення, потребують OCR, тож для сканованого документа доцільно передбачити окремий маршрут.
| Тестовий документ | Маршрут, призначений вручну | Еталон |
|---|---|---|
| PDF із текстовим шаром | Extract From File | Відомий текст в оригіналі |
| Сканований PDF | Mistral AI | Текст, переписаний вручну |
| Нечитабельний файл | Обраний маршрут витягування | Очікуване блокування результату |
Sources: How to Extract Text and Structured Data From PDFs in n8n
Побудуйте маршрути витягування тексту й OCR
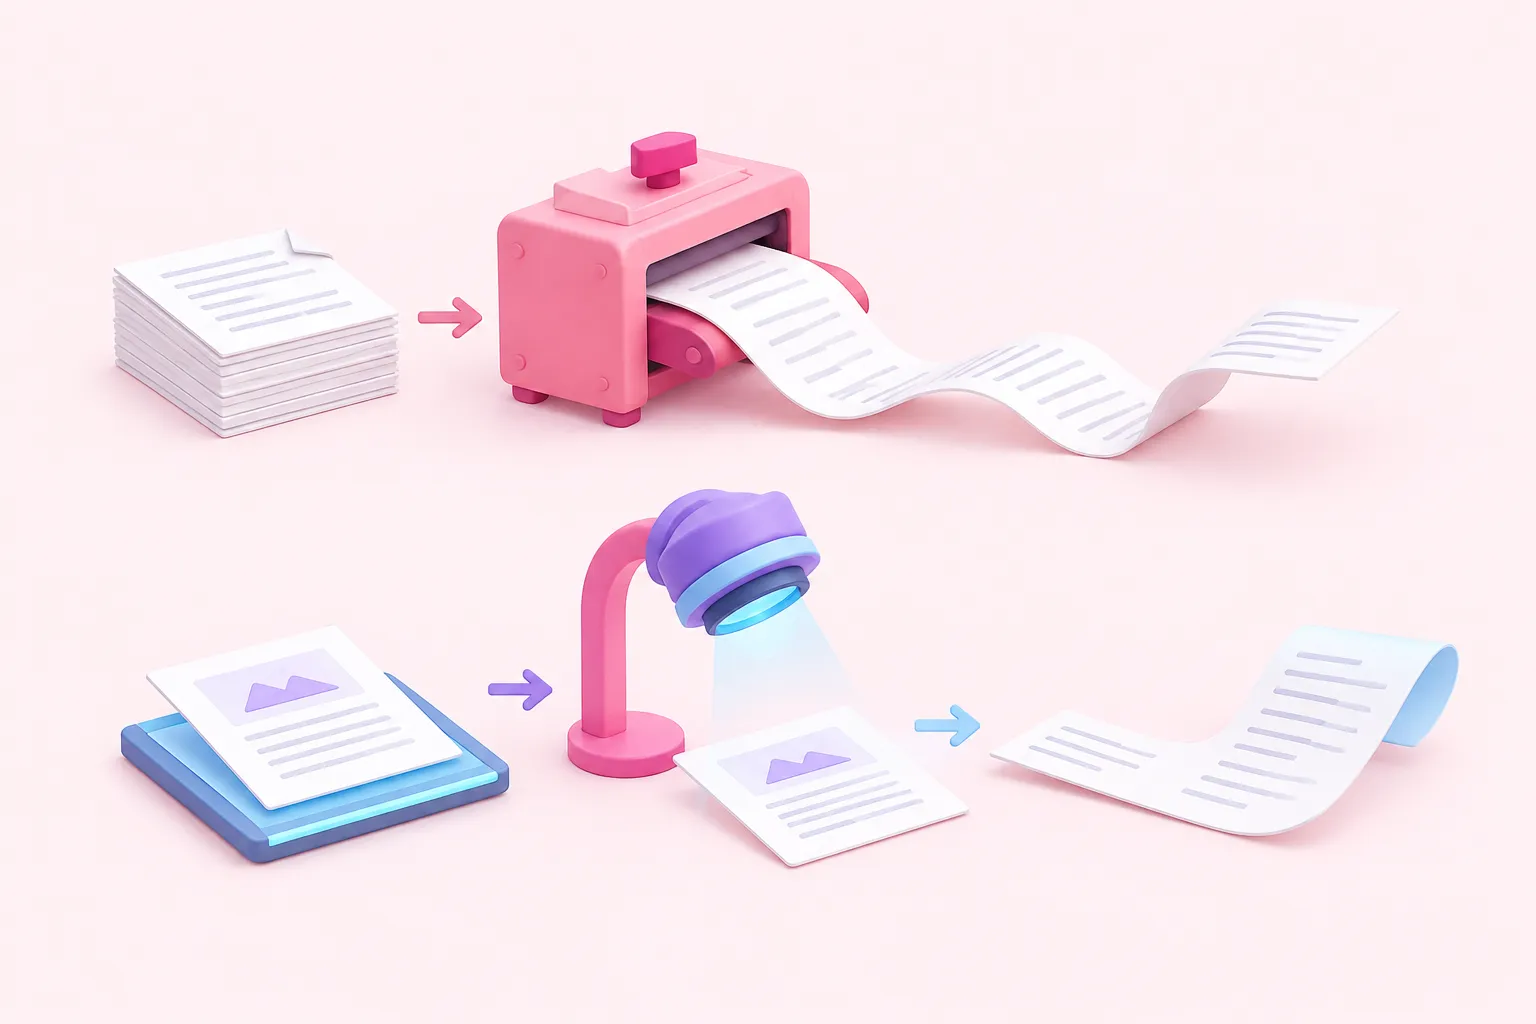
У цьому робочому процесі витягування тексту з PDF у n8n обирайте маршрут за вручну призначеними позначками тестових документів. iTechGuides описує вибір операції Extract From PDF у вузлі Extract From File; у його рекомендаціях не зазначено версію встановленого n8n. Якщо ви шукали «вузол витягування тексту з PDF у n8n», саме цей вузол і ця операція використані в запропонованій схемі.
Документація Mistral описує OCR для тексту й структурованого вмісту PDF та зображень. Для реалізації, описаної в документації n8n щодо Mistral AI, використовуйте Document → Extract Text з Binary Data та mistral-ocr-latest. Документація не вказує номер версії вузла, а псевдонім моделі може змінюватися. Цей маршрут надсилає документ зовнішньому сервісу.
Щоб зібрати цей інструмент витягування тексту з PDF у n8n, дотримуйтеся запропонованої послідовності. Перегляньте фактичні вихідні дані, перш ніж визначати поле з текстом для перевірки; тут не задано фіксованої відповідності полів відповіді.
- Перегляньте вхідний елемент і визначте фактичну назву його бінарної властивості.
- Спрямуйте вручну позначений текстовий документ до Extract From File → Extract From PDF.
- Спрямуйте сканований документ до Mistral AI, обравши варіант бінарних вхідних даних.
- У кожному вузлі витягування узгодьте налаштування бінарного поля з властивістю попереднього вузла.
- Перегляньте кожен результат і визначте текст, який потрібно передати на перевірку якості.
Sources: How to Extract Text and Structured Data From PDFs in n8n, OCR Processor | Mistral Docs, n8n-docs/docs/integrations/builtin/app-nodes/n8n-nodes-base.mistralai.md at main · n8n-io/n8n-docs · GitHub
Розділіть перевірку, схвалення й помилки виконання
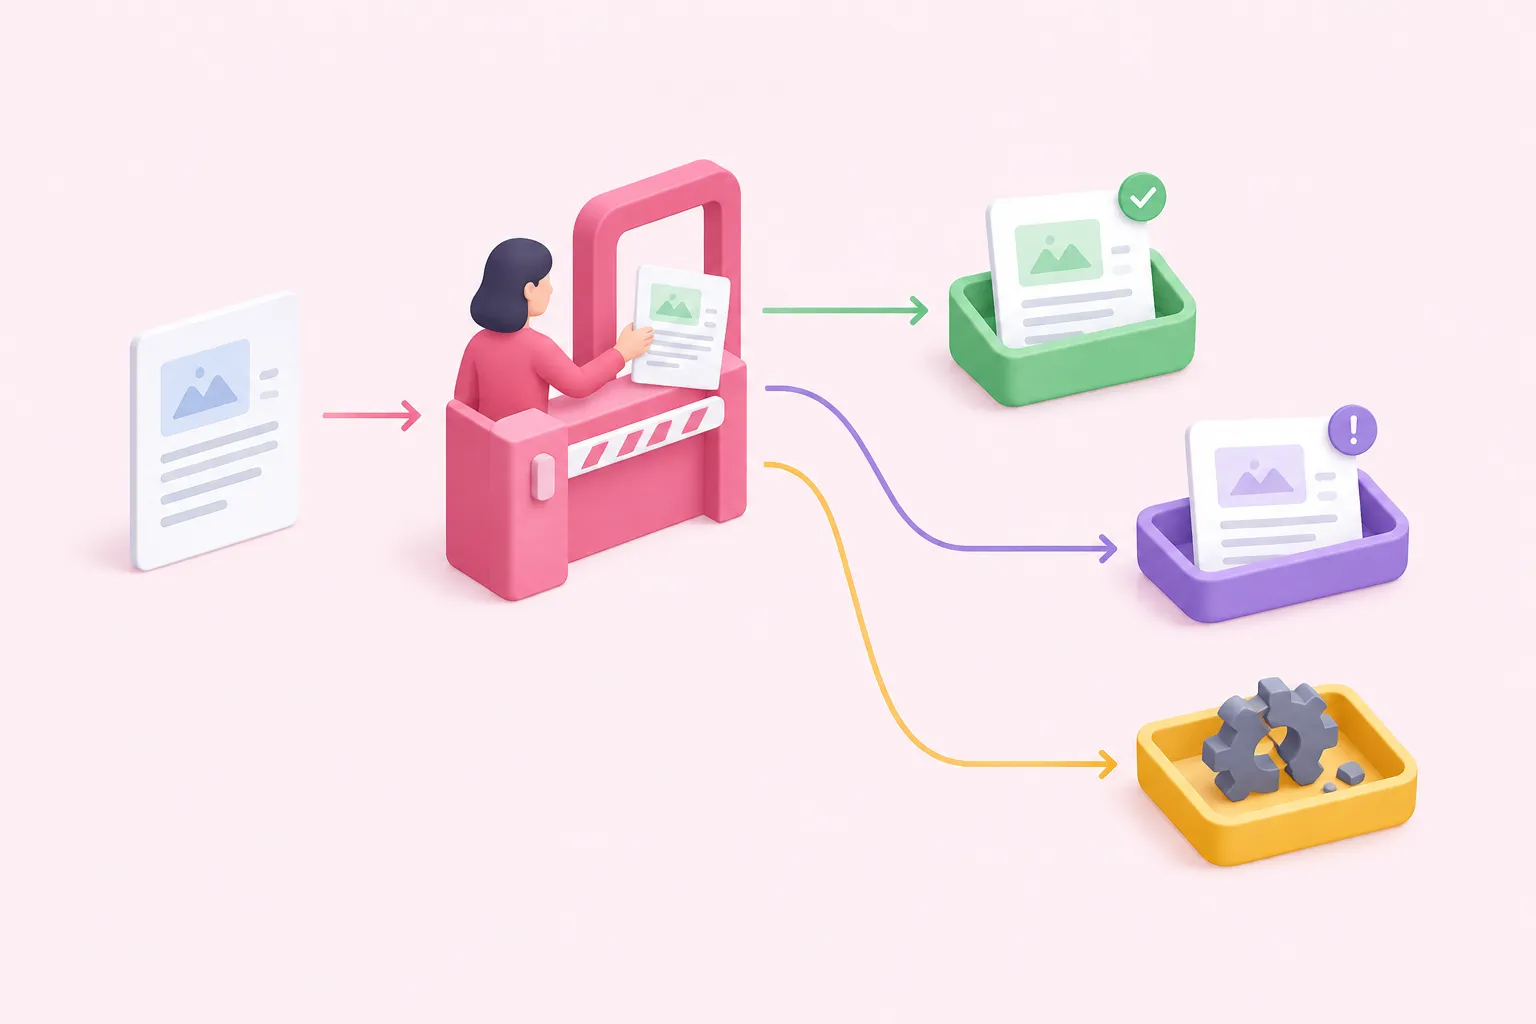
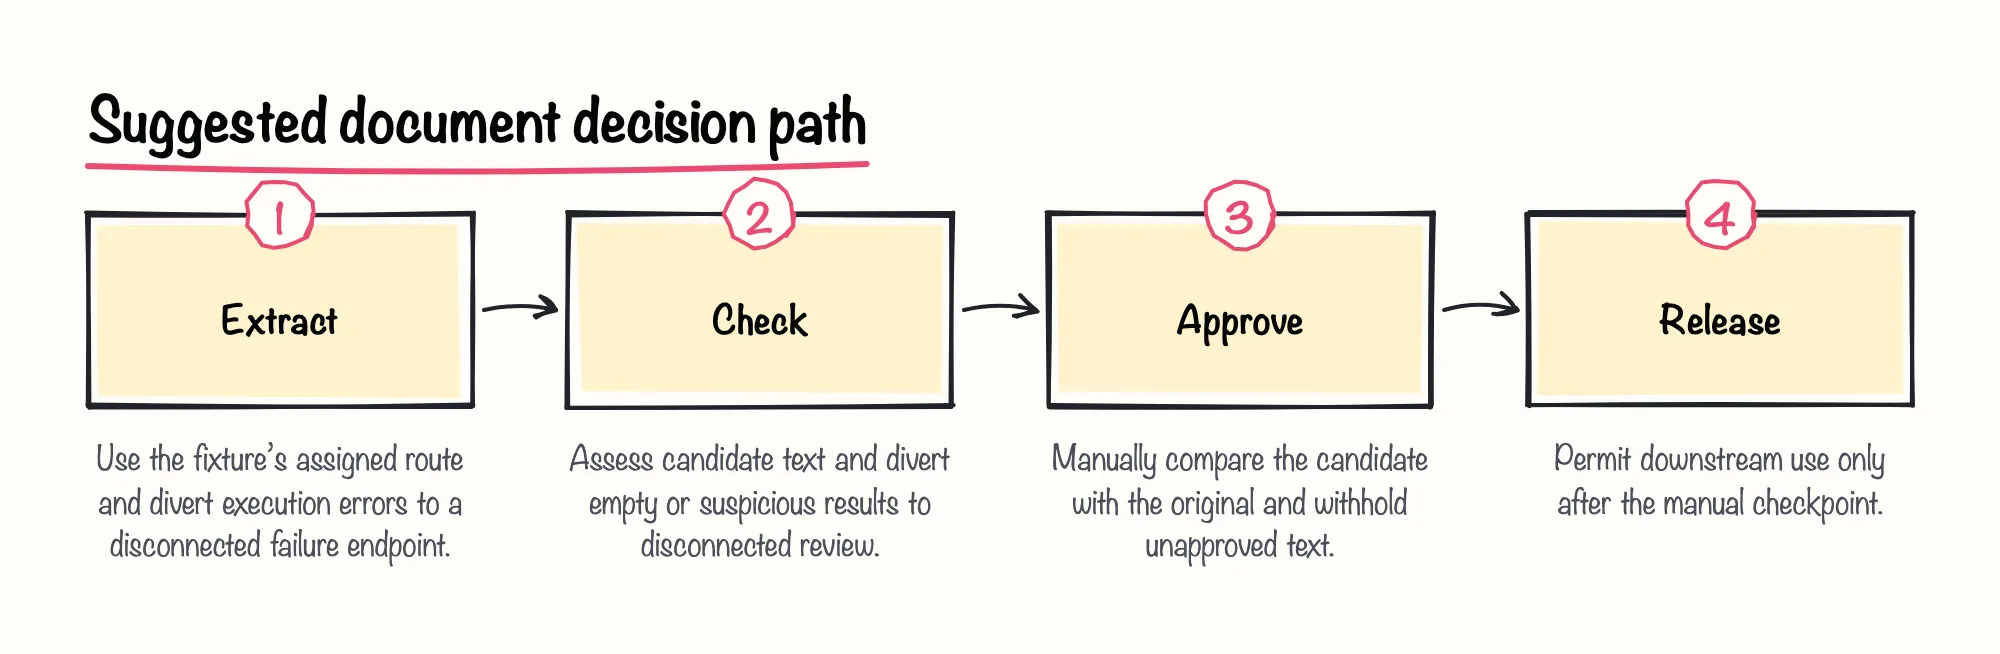
Вузол If у n8n підтримує умовні порівняння. Правила прийняття результату на схемі — це редакційні пропозиції, а не перевірені порогові значення. Джерела не встановлюють точності OCR, порогу впевненості, затримки чи економії.
На нашу думку, текст OCR, який на вигляд читається нормально, потребує такої самої ретельної перевірки, як і явно неповний результат.
Для помилок виконання n8n документує Continue (using error output) і Stop Workflow. Ізоляція помилок залежить від з’єднань у робочому процесі; успішне виконання вузла не підтверджує придатності тексту. Запропонована нижче маршрутизація розділяє ці рішення; автоматизовані інтерфейси схвалення, сповіщення для промислової експлуатації, розбір бізнес-полів і підготовка розгортання до надійної роботи залишаються поза межами вправи.
Sources: n8n-docs/docs/integrations/builtin/core-nodes/n8n-nodes-base.if.md at main · n8n-io/n8n-docs · GitHub, n8n-docs/docs/build/understand-workflows/workflow-components/work-with-nodes.md at main · n8n-io/n8n-docs · GitHub
Продемонструйте виконання й проаналізуйте результат
Завершіть вправу з витягування тексту з PDF у n8n, продемонструвавши наведені нижче запропоновані критерії. Якщо вузол не знаходить файл, перевірте наявність бінарних даних на вході й узгодьте назву властивості. Якщо він виконується, але не повертає корисного тексту, перевірте фактичне вихідне поле, перш ніж вважати це помилкою виконання.
Питання для роздумів: чому текст OCR може виглядати читабельним, але не відповідати оригіналу? Запропоноване рішення — показати розбіжність з еталоном, затримати результат і пояснити, яке рішення спрямувало його на перевірку.
Sources: How to Extract Text and Structured Data From PDFs in n8n, n8n-docs/docs/integrations/builtin/core-nodes/n8n-nodes-base.if.md at main · n8n-io/n8n-docs · GitHub, n8n-docs/docs/build/understand-workflows/workflow-components/work-with-nodes.md at main · n8n-io/n8n-docs · GitHub