Extracción de PDF en n8n: ejercicio editorial de OCR y revisión
Practica la extracción de PDF en n8n con documentos de texto y escaneados, rutas de error separadas y aprobación manual antes de usar los resultados.
Comprobado con las fuentes citadas el .
Define tu tarea de extracción de PDF en n8n
Este ejercicio editorial te propone diseñar y demostrar la extracción de PDF en n8n en tu propio entorno: enviar un PDF con texto a Extract From File, un PDF escaneado a Mistral AI y retener los resultados inutilizables antes de su uso posterior. El ejercicio propuesto no se ha ejecutado ni validado aquí.
Para empezar, necesitas acceso a los nodos correspondientes, una fuente existente que emita archivos binarios y credenciales de Mistral configuradas. La documentación de credenciales de n8n indica que se requieren datos de pago y pagos activados para habilitar las claves de API de Mistral. Este ejercicio comienza después de la recepción del archivo; crear una interfaz de carga y detectar automáticamente los tipos de PDF queda fuera de su alcance.
Creemos que el objetivo de aprendizaje más útil es saber cuándo retener el resultado de un documento, más allá de conseguir que aparezca texto.
Sources: How to Extract Text and Structured Data From PDFs in n8n, n8n-docs/docs/integrations/builtin/app-nodes/n8n-nodes-base.mistralai.md at main · n8n-io/n8n-docs · GitHub, n8n-docs/docs/integrations/builtin/credentials/mistral.md at main · n8n-io/n8n-docs · GitHub
Prepara archivos de prueba etiquetados y texto de referencia
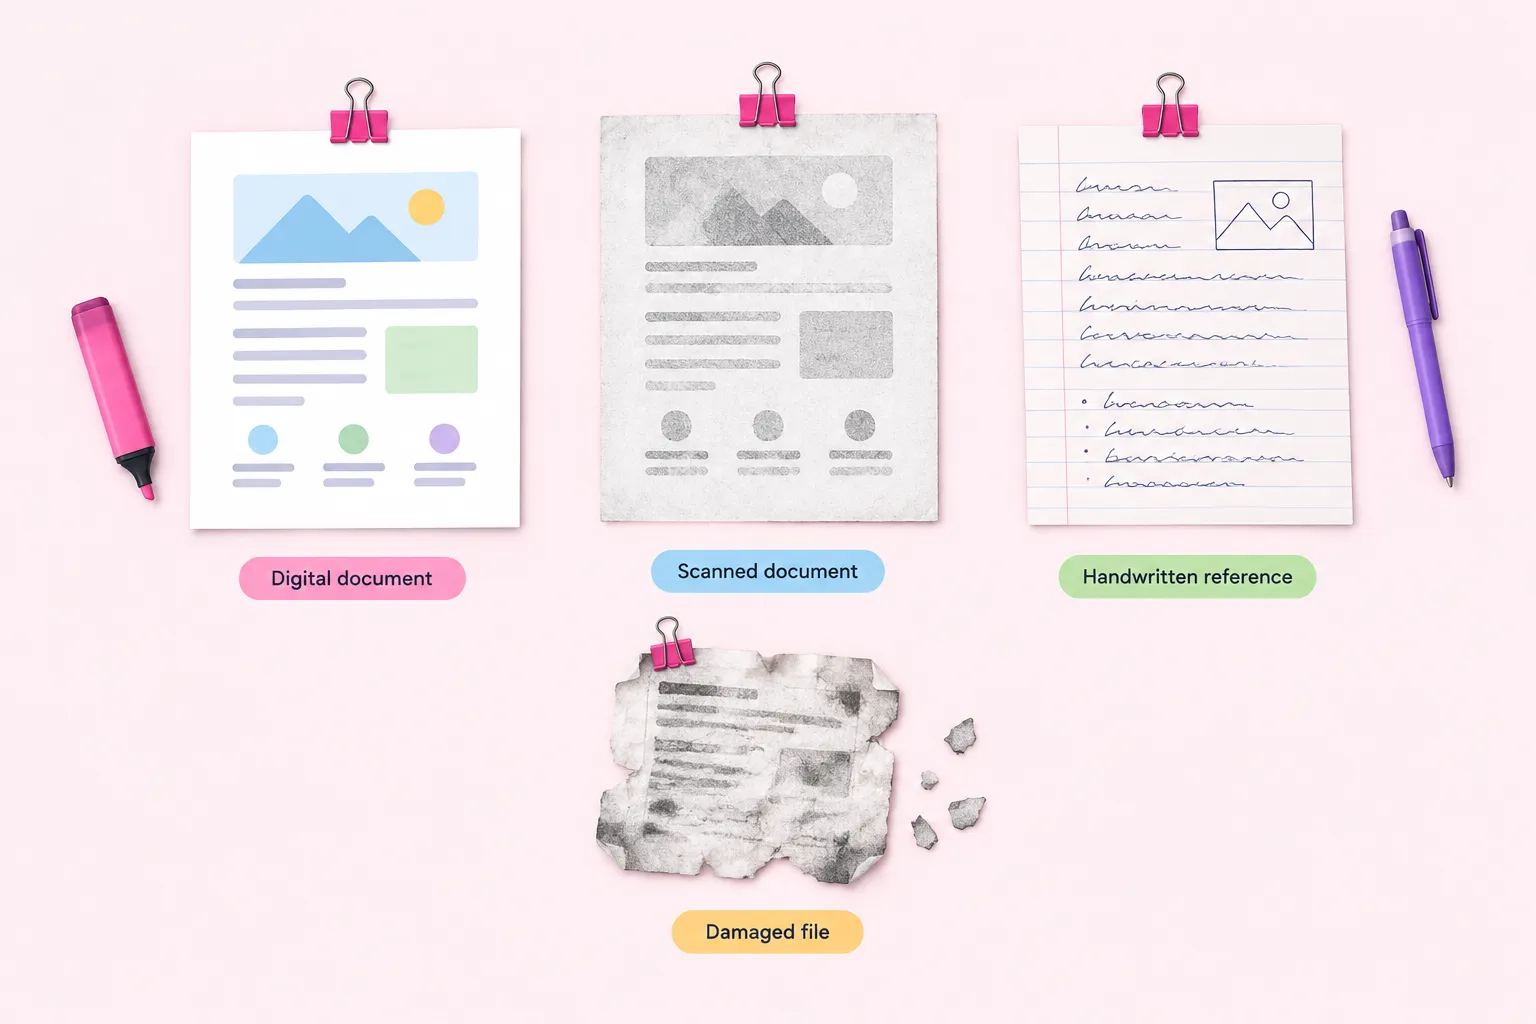
Utiliza documentos sintéticos sin información sensible: las fuentes proporcionadas no establecen las condiciones de retención del proveedor, la residencia de los datos ni las garantías contractuales de privacidad. Asigna a cada archivo de prueba una etiqueta de ruta manual y conserva el original para compararlo. Estas entradas sugeridas definen el ejercicio; no constituyen un conjunto de pruebas validado.
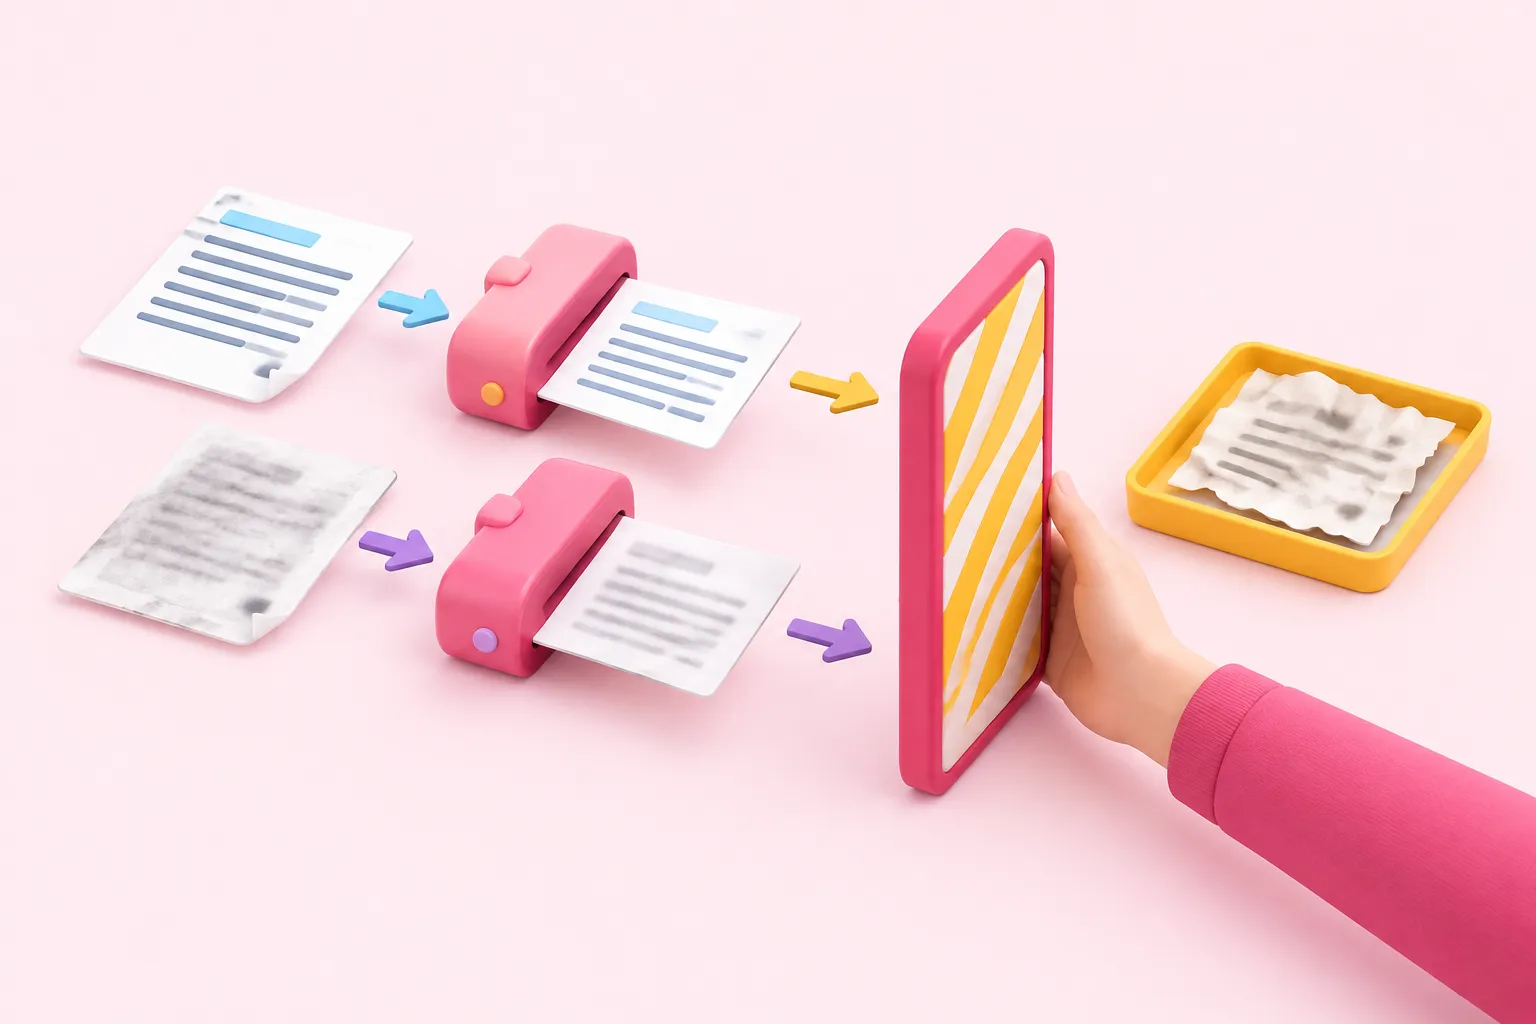
Prepara los siguientes archivos de prueba. iTechGuides explica que las páginas que solo contienen imágenes requieren OCR, lo que justifica asignar una ruta propia al documento escaneado.
| Archivo de prueba | Ruta manual | Referencia |
|---|---|---|
| PDF con capa de texto | Extract From File | Texto conocido del original |
| PDF escaneado | Mistral AI | Texto transcrito manualmente |
| Archivo ilegible | Una ruta de extracción elegida | Retención prevista |
Sources: How to Extract Text and Structured Data From PDFs in n8n
Construye las rutas de extracción y OCR
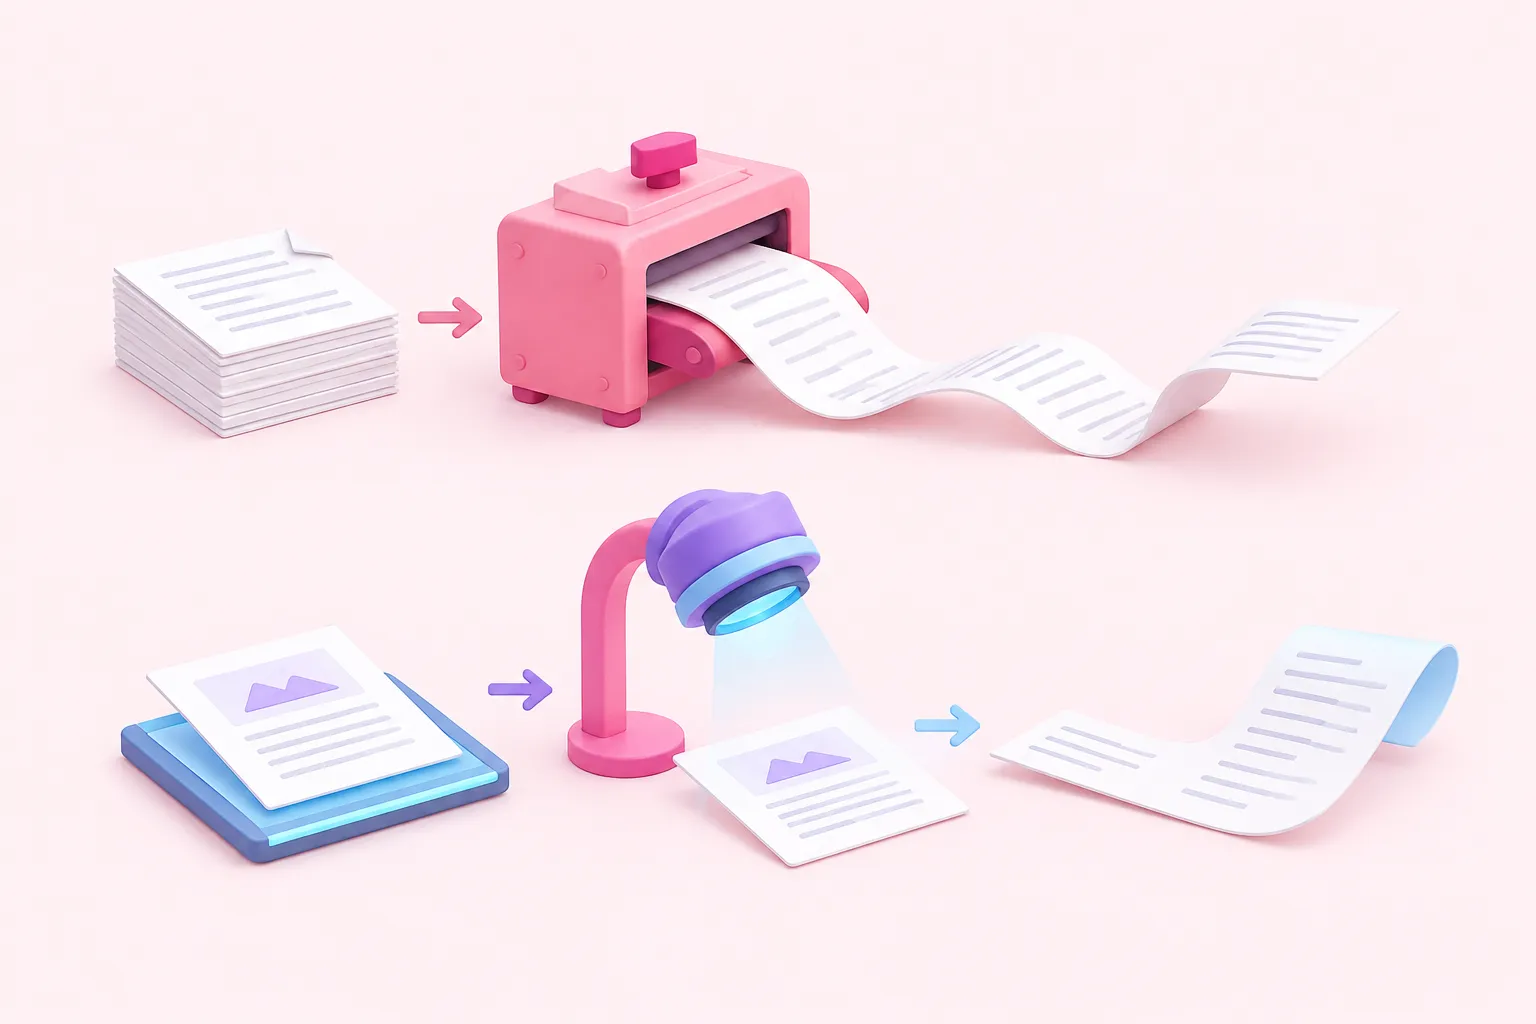
En este flujo de extracción de PDF en n8n, utiliza las etiquetas manuales de los archivos de prueba para elegir la ruta. iTechGuides describe cómo seleccionar Extract From PDF dentro de Extract From File; su guía no especifica una versión de n8n desplegada. Si buscabas un «nodo de extracción de PDF en n8n», ese es el nodo y la operación que utiliza este diseño propuesto.
La documentación de Mistral describe el OCR para texto y contenido estructurado en PDF e imágenes. Para la implementación descrita en la documentación de Mistral AI de n8n, utiliza Document → Extract Text con Binary Data y mistral-ocr-latest. La documentación no indica una versión numerada del nodo y el alias del modelo puede cambiar. Esta ruta envía el documento a un servicio externo.
Sigue esta secuencia sugerida para montar tu extractor de PDF en n8n. Inspecciona las salidas reales antes de decidir qué campo contiene el texto candidato; aquí no se prescribe una correspondencia fija de campos de respuesta.
- Inspecciona el elemento del paso anterior e identifica su propiedad binaria real.
- Envía el archivo de prueba de texto etiquetado manualmente a Extract From File → Extract From PDF.
- Envía el archivo de prueba escaneado a Mistral AI mediante su opción de entrada binaria.
- Haz coincidir la configuración del campo binario de cada nodo de extracción con la propiedad del paso anterior.
- Inspecciona cada resultado e identifica el texto que enviarás al control de calidad.
Sources: How to Extract Text and Structured Data From PDFs in n8n, OCR Processor | Mistral Docs, n8n-docs/docs/integrations/builtin/app-nodes/n8n-nodes-base.mistralai.md at main · n8n-io/n8n-docs · GitHub
Separa la revisión, la aprobación y los errores de ejecución
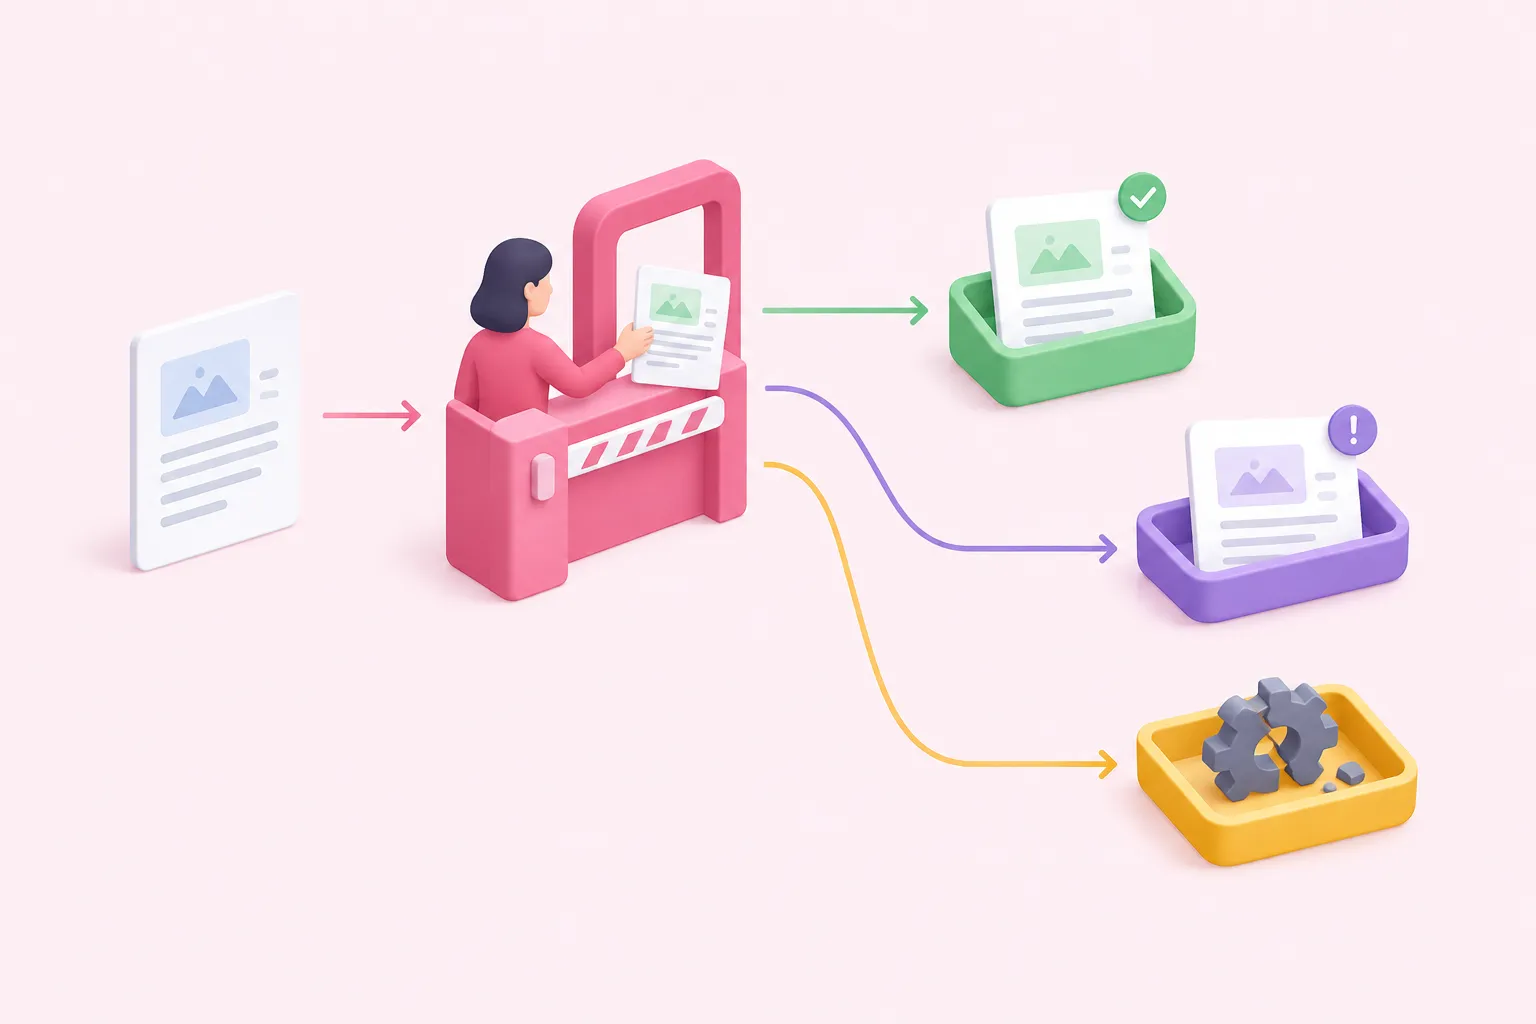
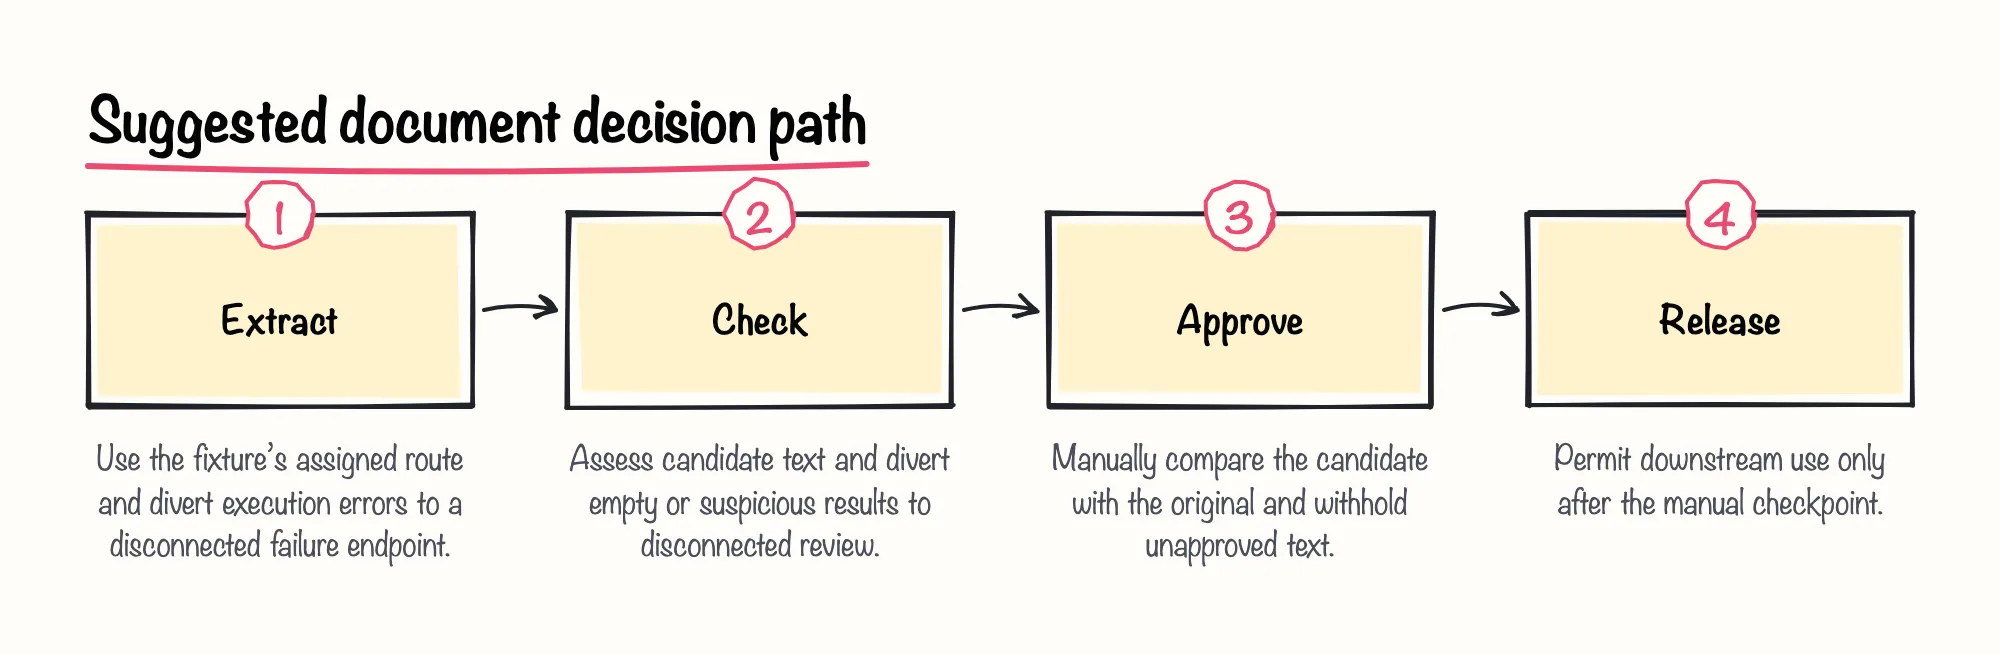
El nodo If de n8n permite realizar comparaciones condicionales. Las reglas de aceptación del diagrama son sugerencias editoriales, no umbrales validados. Las fuentes no establecen la precisión del OCR, un umbral de confianza, la latencia ni el ahorro.
En nuestra opinión, un texto obtenido mediante OCR que parece legible merece el mismo escrutinio que un resultado claramente incompleto.
Para los fallos de ejecución, n8n documenta Continue (using error output) y Stop Workflow. El aislamiento de errores depende de las conexiones del flujo; que un nodo se ejecute correctamente no demuestra que el texto sea utilizable. El enrutamiento propuesto a continuación mantiene separadas esas decisiones; las interfaces de aprobación automatizadas, las alertas de producción, el análisis de campos de negocio y el refuerzo del despliegue quedan fuera de este ejercicio.
Sources: n8n-docs/docs/integrations/builtin/core-nodes/n8n-nodes-base.if.md at main · n8n-io/n8n-docs · GitHub, n8n-docs/docs/build/understand-workflows/workflow-components/work-with-nodes.md at main · n8n-io/n8n-docs · GitHub
Demuestra que has completado el ejercicio y reflexiona
Termina tu ejercicio de extracción de PDF en n8n demostrando los criterios propuestos a continuación. Si un nodo no encuentra su archivo, comprueba la presencia de datos binarios en el paso anterior y haz coincidir el nombre de la propiedad. Si se ejecuta pero no devuelve texto útil, inspecciona el campo de salida real antes de tratarlo como un fallo de ejecución.
Reflexión sugerida: ¿por qué un texto obtenido mediante OCR puede parecer legible y, aun así, diferir del original? Una solución sugerida consiste en mostrar la discrepancia respecto a tu referencia, retener el resultado y explicar qué decisión lo envió a revisión.
Sources: How to Extract Text and Structured Data From PDFs in n8n, n8n-docs/docs/integrations/builtin/core-nodes/n8n-nodes-base.if.md at main · n8n-io/n8n-docs · GitHub, n8n-docs/docs/build/understand-workflows/workflow-components/work-with-nodes.md at main · n8n-io/n8n-docs · GitHub