Фреймворк тестування AI-агентів для n8n: практичний посібник
Практичний фреймворк тестування AI-агентів для n8n: перевіряйте відповіді й виклики інструментів, поєднуйте методи оцінювання та ставте запобіжники перед продакшеном.
Перевірено за наведеними джерелами .
Чому AI-агентам потрібне систематичне тестування перед доступом до продакшену
Перш ніж AI-агент у n8n отримає доступ до реальних даних клієнтів, платіжних систем чи продакшн-баз даних, вам потрібно більше, ніж демонстрація, яка спрацювала один раз. Фреймворк тестування AI-агента дає відтворювані способи перевірити, чи залишаються відповіді та дії агента надійними при зміні вхідних даних. Власна документація n8n трактує це як основну, а не опціональну практику, описуючи оцінювання (evaluation) як техніку перевірки надійності AI-воркфлоу, а не просто його вдалого вигляду під час демонстрації (F1).
Ризик саме з агентами в тому, що неправильна дія може мати більше значення, ніж неправильне речення. Розділи нижче пояснюють, чому тестування інструментів AI-агента n8n і дій, які він виконує, а не лише кінцевого тексту, який повертає агент, є центральним елементом надійного фреймворку тестування AI-агента.
Sources: Understand why to test | Build | n8n Docs
Два етапи оцінювання в n8n: легке проти метричного
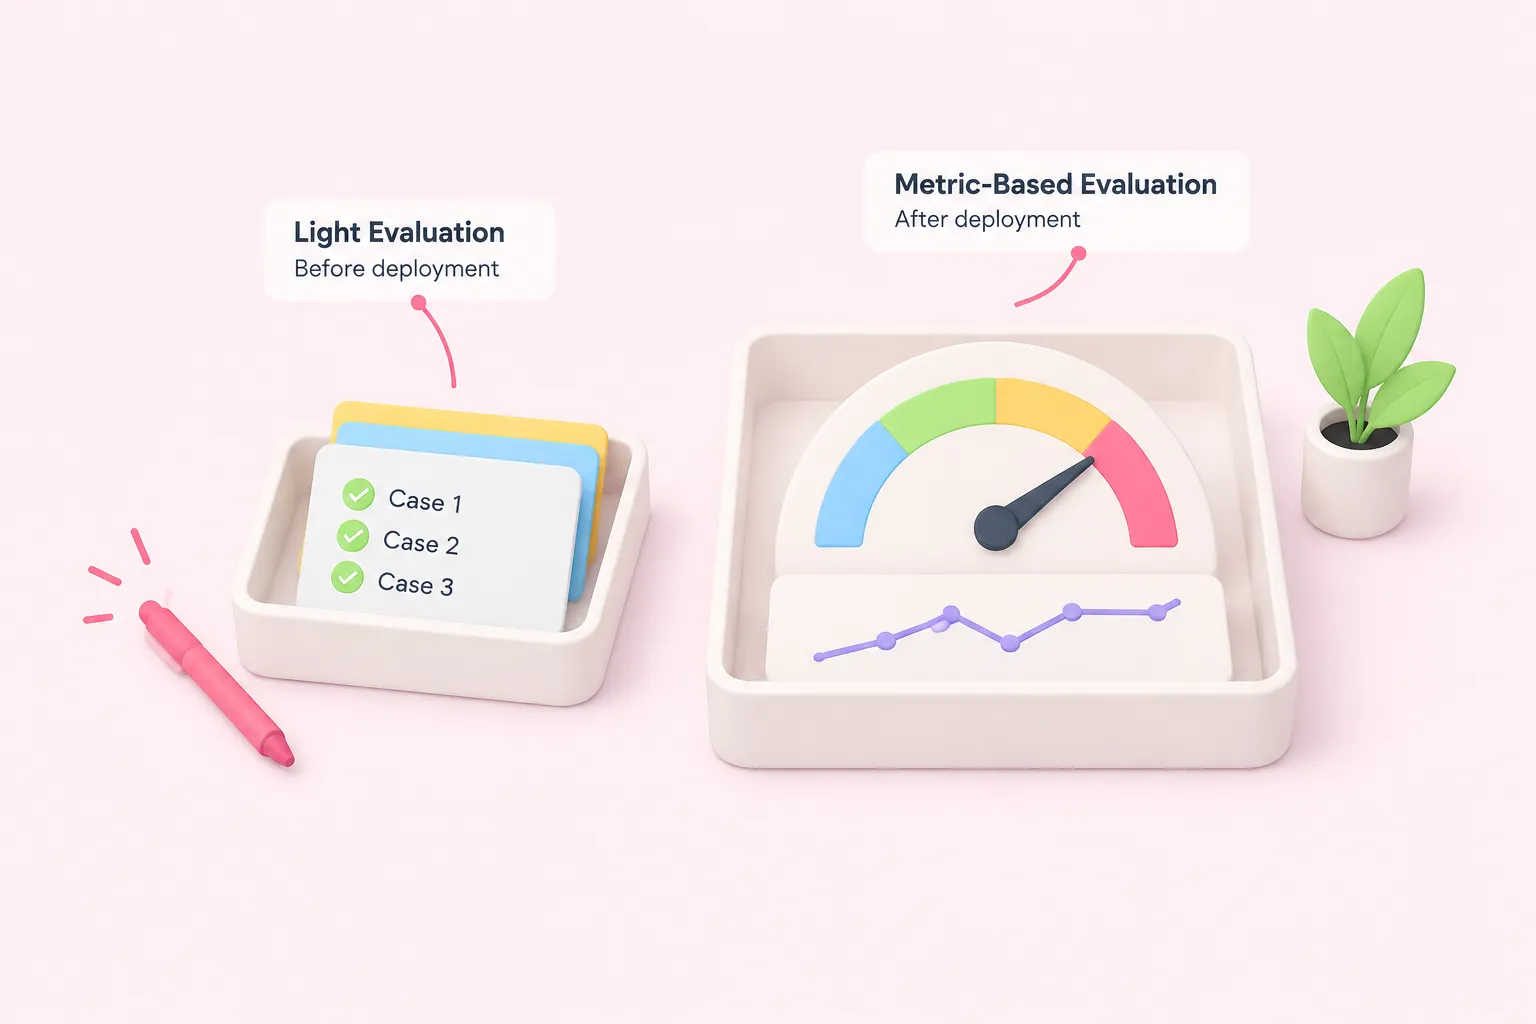
n8n документує оцінювання як процес, що відбувається у два етапи, які підходять для різних моментів життя агента. Легке оцінювання призначене для періоду перед розгортанням: ви запускаєте кілька кейсів і перевіряєте результати візуально. Метричне оцінювання призначене для періоду після розгортання, коли агент вже отримує трафік, і воно відстежує числові показники з часом (F2).
Пов'язане розмежування в блозі n8n відділяє офлайн-оцінювання, яке запускається на підібраному тестовому наборі даних перед випуском змін, від оцінювання живого трафіку (F6). Блог n8n подає це як прогресію зрілості: команди зазвичай починають із ручних вибіркових перевірок і поступово переходять до автоматизованих, метричних перевірок у міру того, як агент наближається до обробки продакшн-трафіку (F5).
| Етап | Коли запускається | Що перевіряє |
|---|---|---|
| Легке оцінювання | Перед розгортанням | Невеликий набір кейсів, перевірка візуально |
| Метричне оцінювання | Після розгортання | Числові показники, що відстежуються з часом |
| Офлайн-оцінювання | Перед випуском змін | Запускається на підібраному тестовому наборі даних |
| Онлайн-оцінювання | На живому трафіку | Відстежує реальну поведінку в продакшені на предмет відхилень |
Sources: Understand why to test | Build | n8n Docs, How to evaluate the performance of AI agents? – n8n Blog
Шаруваті методи оцінювання: детерміновані перевірки, LLM-as-judge і людська перевірка
Не всі методи оцінювання коштують однаково, і блог n8n радить починати з дешевших. Детерміновані, засновані на правилах перевірки — такі як валідація схеми, порівняння на точну відповідність чи підтвердження наявності обов'язкового поля — швидкі й повністю відтворювані, тому є розумним першим шаром для всього, що має об'єктивно правильну відповідь (F7). Спираючись на цю відправну точку, ось як цей посібник організовує решту шарів за вартістю та сценарієм використання — як робочий фреймворк, а не як окремо підтверджене твердження для кожного з них:
- Детерміновані перевірки: валідація схеми, точна відповідність, перевірка обов'язкових полів
- LLM-as-judge: наближена оцінка тону, корисності та суб'єктивної якості
- Людська перевірка: ручне читання для ризикованих або неоднозначних випадків
- Зворотний зв'язок користувачів: сигнали, зібрані після запуску агента
Сам лише текстовий вивід може приховувати під собою погане рішення, тому оцінювання має дивитися на те, що агент дійсно зробив, а не лише на те, що він сказав. Павел Гурин (Paweł Huryn), описуючи власні реалізації оцінювання агентів на The Product Compass, формулює це так:
Конкретно це означає написання явних перевірок того, які інструменти викликав агент, у якому порядку та з якими параметрами, поряд із перевірками кінцевої відповіді. Для суб'єктивних якостей, таких як тон чи те, чи справді пояснення має сенс, другий шар із методами LLM-as-judge може наближено відтворити людську оцінку за нижчою вартістю, ніж перевірка всього вручну. Ручну людську перевірку варто залишити для найризикованіших або найбільш неоднозначних випадків.
Sources: How to evaluate the performance of AI agents? – n8n Blog
Налаштування фреймворку тестування AI-агента n8n: вузол Evaluation і обмеження ліцензії
Вузол Evaluation і Eval Trigger у n8n є будівельними блоками для фреймворку тестування AI-агента всередині n8n: ви подаєте набір тестових кейсів, запускаєте агента на кожному з них і записуєте метрики, які можна порівнювати між версіями. Перш ніж вирішувати, наскільки масштабувати таке налаштування, перевірте, на якому тарифі n8n ви перебуваєте. Сторонній туторіал повідомляє, що базове використання вузла Evaluation доступне у безкоштовній Community Edition, тоді як більш просунуті функції оцінювання вимагають платного тарифу Pro або Enterprise (F3, F4).
| Тариф | Можливості оцінювання | Примітка |
|---|---|---|
| Community Edition | Базове використання вузла Evaluation | За даними стороннього туторіалу, не сторінки цін самої n8n |
| Pro або Enterprise | Просунуті функції оцінювання | За даними стороннього туторіалу, не сторінки цін самої n8n |
Ці межі тарифів походять із туторіалу стороннього постачальника, а не зі сторінки цін самої n8n серед розглянутих тут джерел, тож перевірте актуальні обмеження, перш ніж прив'язувати стратегію оцінювання до конкретного тарифу — особливо якщо ви плануєте запускати метричне оцінювання одразу для кількох агентів.
Sources: Understand why to test | Build | n8n Docs, How to stop your AI agents from hallucinating: A guide to n8n’s Eval Node - LogRocket Blog
Запобіжники, моніторинг і чекліст перед продакшеном
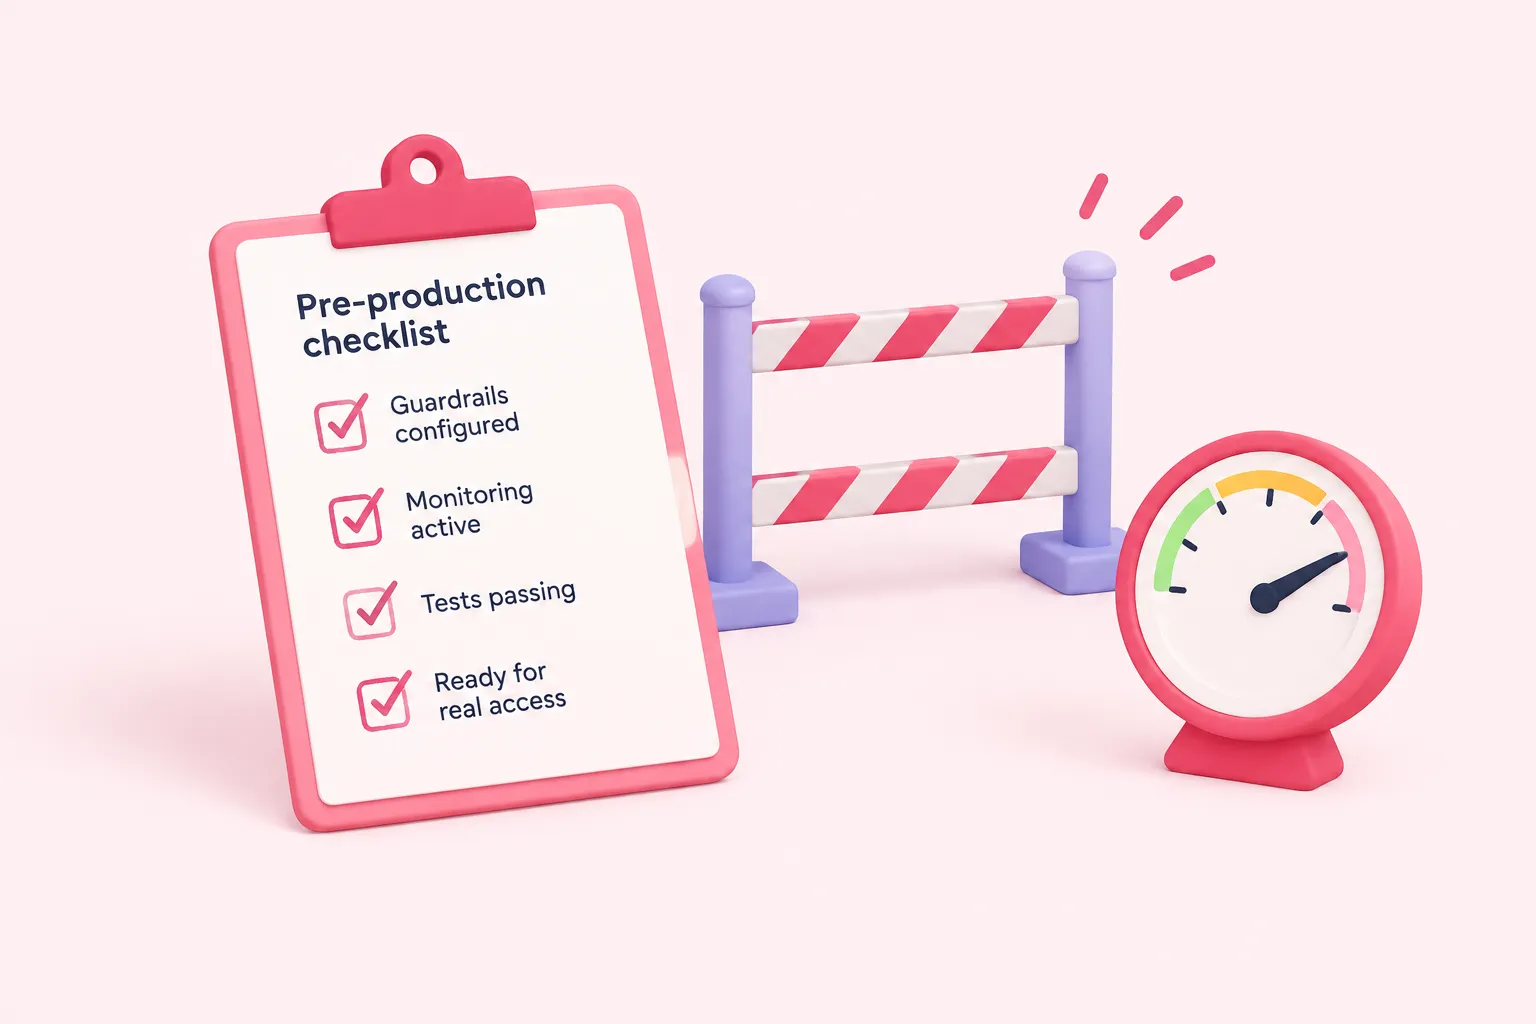
Фреймворк тестування AI-агента не завершується, щойно офлайн-набір даних успішно пройдено. Блог n8n описує оцінювання як поетапну прогресію, яка продовжує розширюватися в міру того, як агент наближається до продакшену і проходить через нього, а не зупиняється після проходження початкових тестів (F5). Офлайн-набори даних охоплюють лише ті сценарії, які ви подумали включити, тому живому агенту також потрібні запобіжники на вхідних і вихідних даних, а також постійний моніторинг онлайн-метрик, описаних раніше (F6).
Коли в продакшені стається реальний збій, ставтеся до нього як до нового тестового кейсу: додайте цей конкретний вхід до свого набору даних для оцінювання та повторно запустіть весь набір перед випуском виправлення, щоб той самий збій не міг непомітно повторитися вдруге.
Sources: How to evaluate the performance of AI agents? – n8n Blog