Marco de pruebas para AI Agents en n8n: una guía práctica
Un marco práctico de pruebas para AI Agents en n8n: revisa salidas y llamadas a herramientas, combina métodos de evaluación y aplica límites antes de producción.
Comprobado con las fuentes citadas el .
Por qué los AI Agents necesitan pruebas sistemáticas antes de acceder a producción
Antes de que un AI Agent de n8n acceda a datos reales de clientes, sistemas de pago o bases de datos de producción, necesitas algo más que una demo que funcionó una vez. Un marco de pruebas para AI Agents te da formas repetibles de comprobar si las respuestas y acciones del agente siguen siendo fiables a medida que cambian las entradas. La propia documentación de n8n trata esto como algo esencial, no opcional, y define la evaluación como la técnica para comprobar que un flujo de trabajo de IA es fiable, y no solo que se ve bien en una demostración (F1).
El riesgo particular de los agentes es que una acción incorrecta puede importar más que una frase incorrecta. Las siguientes secciones desarrollan por qué probar las herramientas de un AI Agent de n8n y las acciones que realiza, no solo el texto final que devuelve, está en el centro de un marco de pruebas para AI Agents fiable.
Sources: Understand why to test | Build | n8n Docs
Las dos etapas de evaluación de n8n: ligera frente a basada en métricas
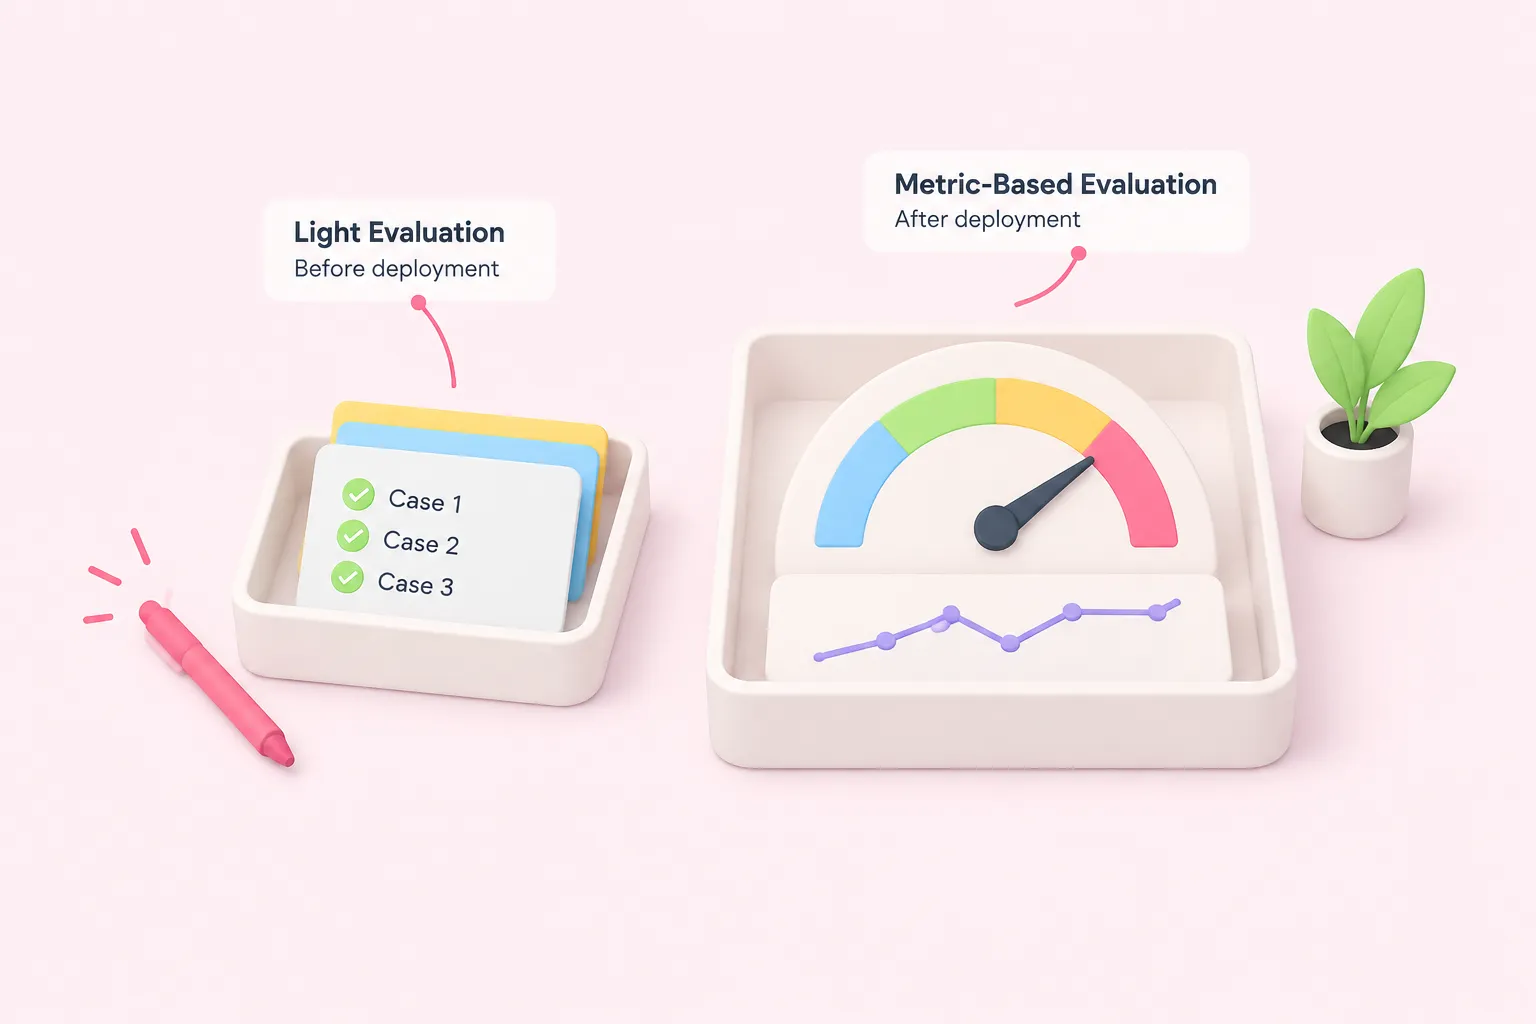
n8n documenta la evaluación como algo que ocurre en dos etapas adecuadas para distintos momentos en la vida de un agente. La evaluación ligera está pensada para antes del despliegue: ejecutas un puñado de casos y revisas los resultados a simple vista. La evaluación basada en métricas está pensada para después del despliegue, cuando el agente ya recibe tráfico, y hace seguimiento de puntuaciones numéricas a lo largo del tiempo (F2).
Una distinción relacionada en el blog de n8n separa la evaluación offline, que se ejecuta contra un conjunto de datos de prueba curado antes de publicar un cambio, de la evaluación del tráfico en vivo (F6). El blog de n8n plantea esto como una progresión de madurez: los equipos suelen empezar con revisiones manuales puntuales y avanzan hacia comprobaciones automatizadas basadas en métricas a medida que el agente se acerca a manejar tráfico de producción (F5).
| Etapa | Se ejecuta cuando | Qué comprueba |
|---|---|---|
| Evaluación ligera | Antes del despliegue | Un pequeño conjunto de casos, revisado a simple vista |
| Evaluación basada en métricas | Después del despliegue | Puntuaciones numéricas registradas a lo largo del tiempo |
| Evaluación offline | Antes de publicar un cambio | Se ejecuta contra un conjunto de datos de prueba curado |
| Evaluación online | Sobre tráfico en vivo | Vigila el comportamiento real en producción en busca de desviaciones |
Sources: Understand why to test | Build | n8n Docs, How to evaluate the performance of AI agents? – n8n Blog
Combinar métodos de evaluación: comprobaciones deterministas, LLM como juez y revisión humana
No todos los métodos de evaluación cuestan lo mismo, y el blog de n8n recomienda empezar por lo más económico. Las comprobaciones deterministas basadas en reglas, como la validación de esquemas, las comparaciones de coincidencia exacta o confirmar que un campo obligatorio está presente, son rápidas y totalmente reproducibles, lo que las convierte en una primera capa sensata para cualquier caso con una respuesta correcta objetiva (F7). A partir de este punto de partida, así es como esta guía organiza las capas restantes según el coste y el caso de uso, como marco de trabajo y no como una afirmación con fuente propia para cada una:
- Comprobaciones deterministas: validación de esquemas, coincidencia exacta, verificación de campos obligatorios
- LLM como juez: puntuación aproximada para el tono, la utilidad y la calidad subjetiva
- Revisión humana: lectura manual para casos de alto riesgo o ambiguos
- Comentarios de usuarios: señales recogidas una vez que el agente está en producción
El texto de salida por sí solo puede ocultar debajo una mala decisión, por eso la evaluación necesita fijarse en lo que el agente realmente hizo y no solo en lo que dijo. Paweł Huryn, describiendo sus propias implementaciones de evaluación de agentes en The Product Compass, lo expresa así:
En concreto, esto significa escribir comprobaciones explícitas sobre qué herramientas llamó el agente, en qué orden y con qué parámetros, junto con comprobaciones sobre la respuesta final. Para cualidades subjetivas, como el tono o si una explicación realmente tiene sentido, una segunda capa que use métodos de LLM como juez puede aproximar el criterio humano a un coste menor que revisarlo todo a mano. Reserva la revisión humana manual para los casos de mayor riesgo o más ambiguos.
Sources: How to evaluate the performance of AI agents? – n8n Blog
Cómo configurar un marco de pruebas para AI Agents en n8n: el nodo Evaluation y los límites de licencia
El nodo Evaluation y el Eval Trigger de n8n son las piezas básicas de un marco de pruebas para AI Agents dentro de n8n: introduces un conjunto de datos de casos de prueba, ejecutas el agente contra cada uno y registras métricas que puedes comparar entre versiones. Antes de decidir hasta dónde escalar esa configuración, comprueba en qué plan de n8n estás. Un tutorial de terceros indica que el uso básico del nodo Evaluation viene incluido en la Community Edition gratuita, mientras que las funciones de evaluación más avanzadas requieren un plan de pago Pro o Enterprise (F3, F4).
| Plan | Capacidad de evaluación | Nota |
|---|---|---|
| Community Edition | Uso básico del nodo Evaluation | Reportado por un tutorial de terceros, no por la página de precios propia de n8n |
| Pro o Enterprise | Funciones de evaluación avanzadas | Reportado por un tutorial de terceros, no por la página de precios propia de n8n |
Esos límites de plan proceden de un tutorial externo y no de la propia página de precios de n8n entre las fuentes revisadas aquí, así que confirma los límites actuales antes de comprometer una estrategia de evaluación a un nivel concreto, especialmente si planeas ejecutar evaluación basada en métricas en varios agentes a la vez.
Sources: Understand why to test | Build | n8n Docs, How to stop your AI agents from hallucinating: A guide to n8n’s Eval Node - LogRocket Blog
Límites de seguridad, monitorización y una lista de comprobación previa a producción
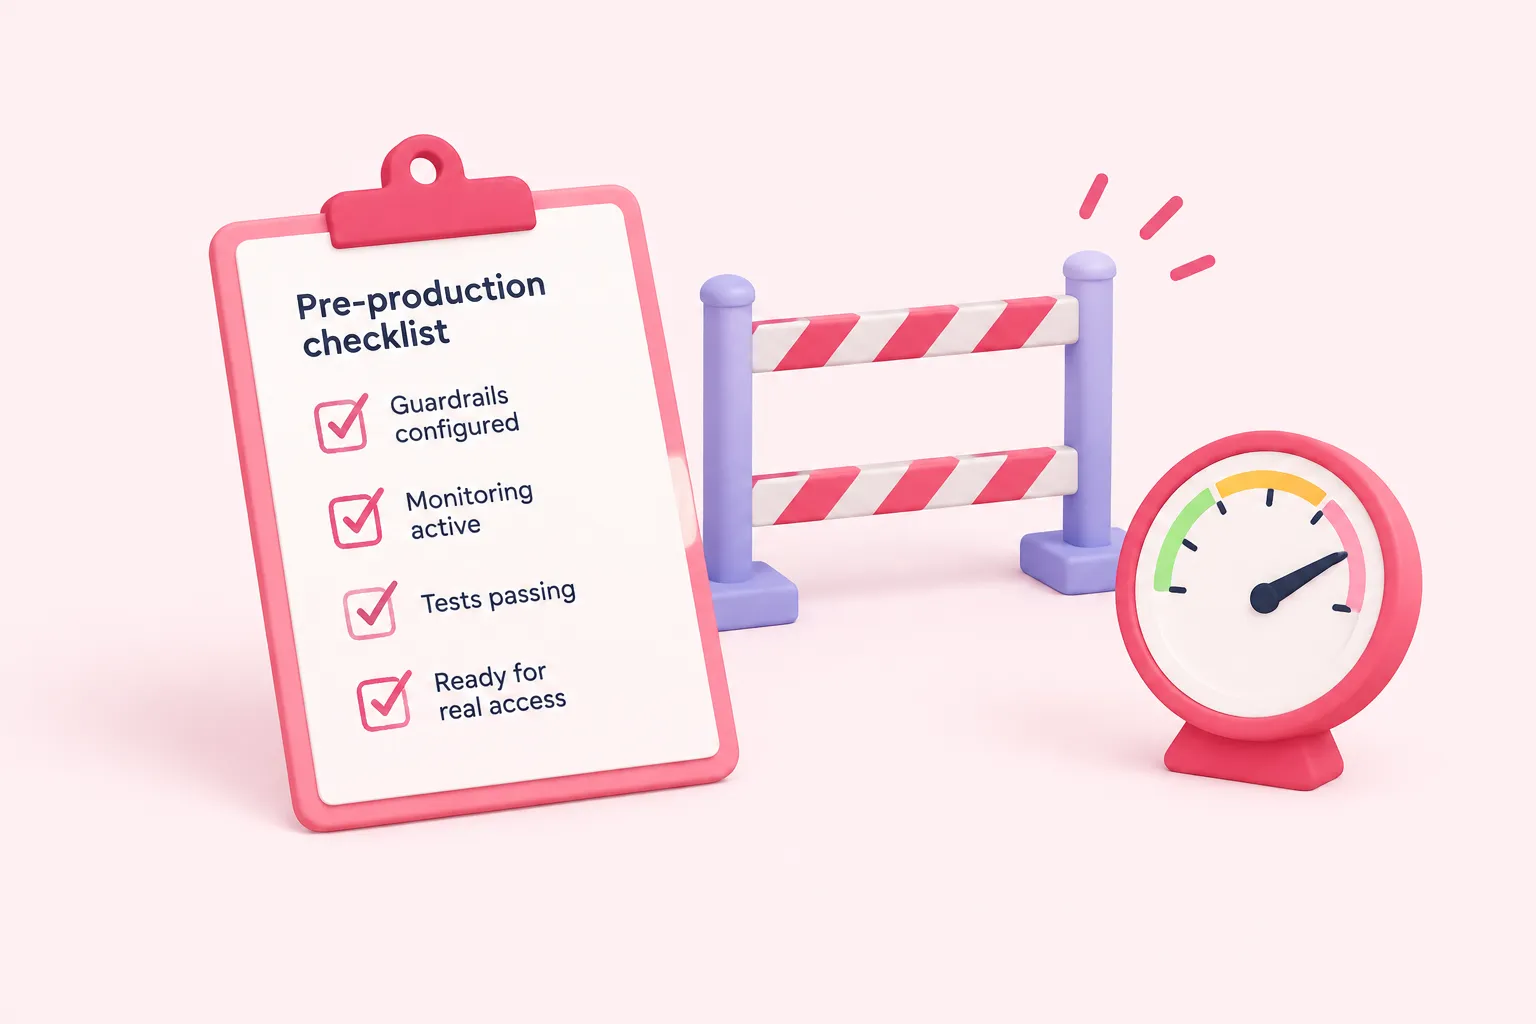
Un marco de pruebas para AI Agents no termina cuando un conjunto de datos offline pasa las pruebas. El blog de n8n describe la evaluación como una progresión por etapas que sigue ampliándose a medida que un agente avanza hacia y a través de producción, en lugar de detenerse tras pasar las pruebas iniciales (F5). Los conjuntos de datos offline solo cubren los escenarios que se te ocurrió incluir, así que un agente en producción también necesita límites de seguridad en las entradas y salidas, además de una monitorización continua de las métricas online descritas antes (F6).
Cuando ocurre un fallo real en producción, trátalo como un nuevo caso de prueba: añade esa entrada exacta a tu conjunto de datos de evaluación y vuelve a ejecutar todo el conjunto antes de publicar una solución, para que el mismo fallo no pueda colarse sin ser detectado una segunda vez.
Sources: How to evaluate the performance of AI agents? – n8n Blog