Requisitos de hardware de n8n: dimensionar un servidor autoalojado para producción
Guía práctica sobre los requisitos de hardware y de servidor de n8n y las decisiones de configuración al pasar de la práctica local a cargas reales.
Comprobado con las fuentes citadas el .
Por qué los requisitos de hardware de n8n locales no sirven para producción
Cuando aprendes a ejecutar n8n en local, los requisitos de hardware de n8n apenas importan: un contenedor en un portátil gestiona un webhook y unas pocas llamadas a API. Producción es distinto, porque el mismo proceso ahora soporta ejecuciones programadas, tráfico de webhooks concurrente, historial de ejecuciones y credenciales de todo un equipo, y los requisitos de n8n cambian con ello.
Antes de citar cifras, conviene saber qué evidencia existe. La propia página de prerrequisitos de n8n publica una base ilustrativa —un mínimo de 10 ciclos de CPU escalando según necesidad, una base de datos SSD de 512 MB a 4 GB y de 320 MB a 2 GB de memoria— pero afirma claramente que es un ejemplo basado en n8n Cloud, solo ilustrativo, y que las necesidades reales varían según usuarios, workflows y ejecuciones. Los proveedores de hosting publican los requisitos de servidor de n8n como niveles: la Self-Hosting Requirements Guide de Cherry Servers (publicada en mayo de 2026, actualizada en julio de 2026) y el tutorial de VPS de Hostinger (agosto de 2026) venden servidores, así que trata sus cifras como reglas generales con motivación comercial.
Ninguna fuente aportada mide el rendimiento de n8n con una carga definida, así que cada número siguiente es un punto de partida que hay que monitorizar y ajustar, no una capacidad medida.
| Fuente | Desarrollo | Producción |
|---|---|---|
| Página de prerrequisitos de n8n | Ilustrativo: 320 MB–2 GB de memoria, base de datos SSD de 512 MB–4 GB | La misma tabla, declarada solo como ejemplo derivado de Cloud |
| Cherry Servers, 2026 | 2 núcleos, 2 GB de RAM, 20 GB SSD, SQLite | 4+ núcleos, 8–16 GB de RAM, 50–100 GB NVMe, PostgreSQL |
| Hostinger, 2026 | Mínimo 1 vCPU, 2 GB de RAM, 20 GB SSD | 2–4 vCPU, 4–8 GB de RAM, 40–80 GB NVMe |
| Hilo de la comunidad, 2023 | Anécdota: se reporta 1 CPU compartida y 1 GB de RAM como viable | La misma respuesta señala que no hay margen para picos de carga |
Sources: Prerequisites | Deploy | n8n Docs, n8n Self-Hosting Requirements Guide (2026) | Cherry Servers, What are the VPS requirements for n8n?, Hardware For Self Hosting - Questions - n8n Community
Primero la memoria, después la CPU
La documentación de n8n aconseja priorizar la memoria sobre la CPU al planificar la infraestructura, porque n8n no hace un uso intensivo de CPU, y señala que el nodo Code crea copias de tus datos antes y después del procesamiento. Es orientación cualitativa del proveedor más que una medición, pero apunta a la dimensión correcta para los requisitos de hardware de n8n: dimensiona la RAM según tu workflow individual más pesado más margen para lo que se ejecute al mismo tiempo.
Cuando n8n autoalojado se queda sin memoria, la documentación ofrece dos caminos: dar más memoria al proceso, o consumir menos troceando los datos, evitando el nodo Code, evitando ejecuciones manuales sobre grandes conjuntos de datos y dividiendo el trabajo en subworkflows. Para el error concreto JavaScript heap out of memory, n8n sugiere asignar más old space de V8 con la opción max-old-space-size, definida en la CLI o mediante NODE_OPTIONS; no se documenta ningún valor recomendado.
Sources: Prerequisites | Deploy | n8n Docs, Fix memory issues | Deploy | n8n Docs
Base de datos y retención: SQLite, PostgreSQL y pruning
n8n autoalojado usa SQLite por defecto y admite opcionalmente PostgreSQL. En julio de 2026 la documentación lista las dos versiones mayores con mantenimiento activo, 17 y 18, además de la 16 por compatibilidad, señala que el rango soportado cambia cada noviembre, y marca Aurora como experimental mientras AlloyDB, CockroachDB y YugabyteDB no están soportados. Como esa lista está explícitamente limitada en el tiempo, consulta la página en lugar de fijar una versión desde un artículo.
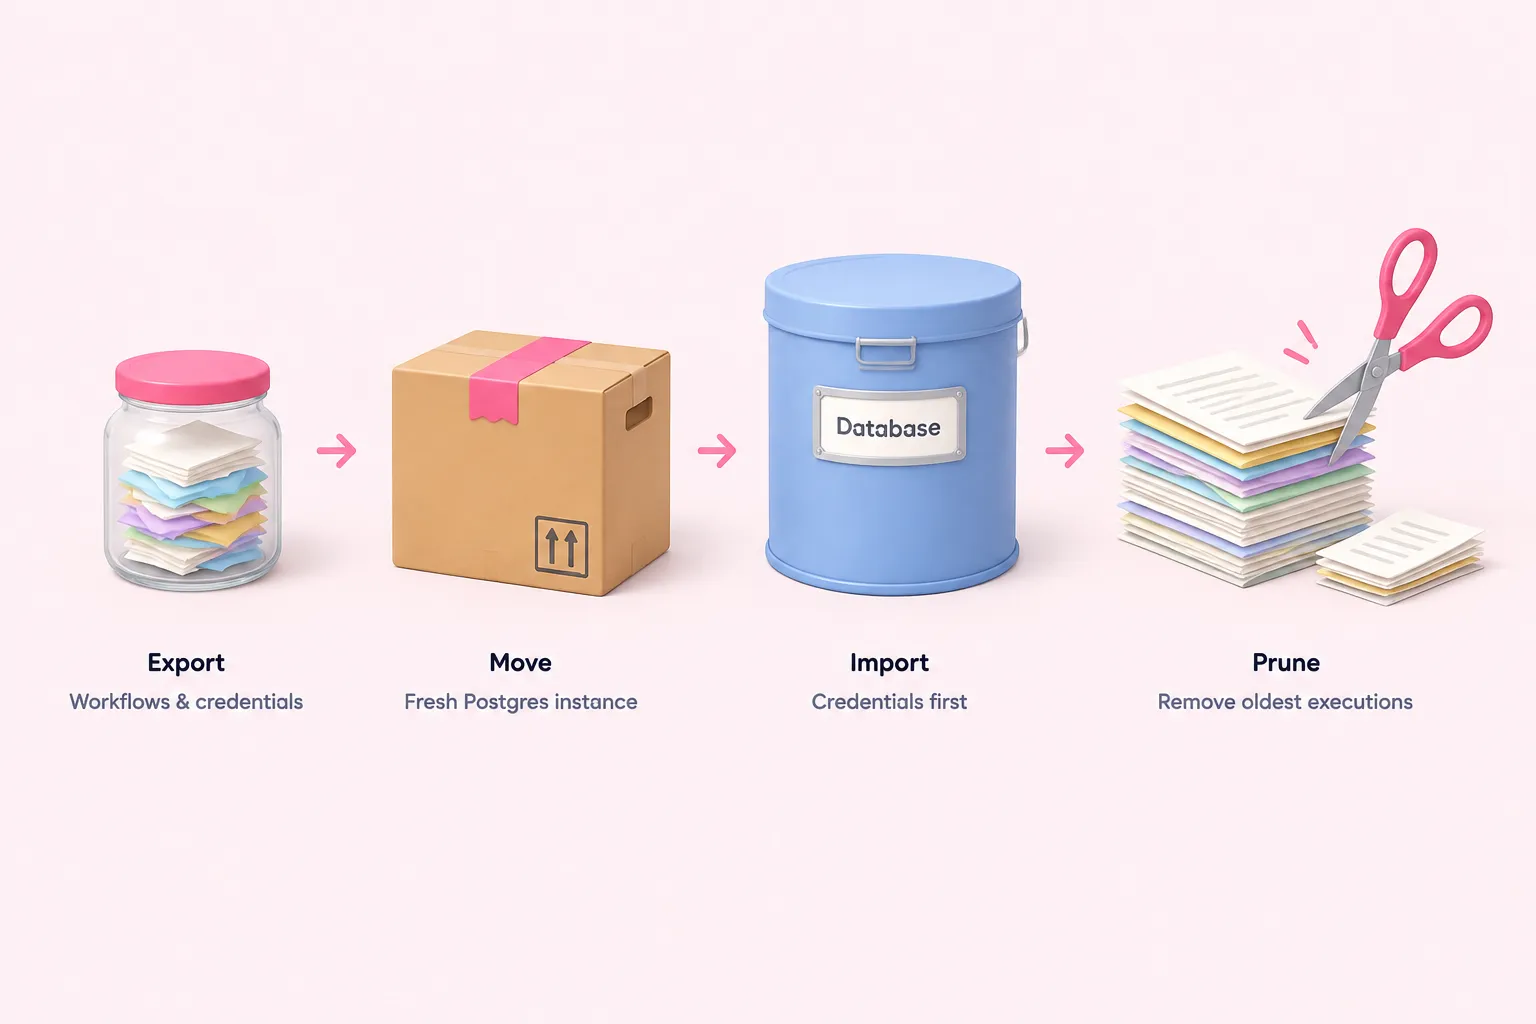
Pasar a PostgreSQL no es una actualización en el mismo sitio. Una guía de un profesional (LumaDock, diciembre de 2025) describe exportar workflows y credenciales con la CLI de n8n, arrancar una instancia nueva respaldada por Postgres con la misma clave de cifrado e importar las credenciales antes que los workflows; el historial de ejecuciones no se traslada, y el autor señala que no probó la exportación de entidades a gran escala. n8n también recomienda una base de datos dedicada por instancia para evitar dependencias y degradación del rendimiento, junto con almacenamiento SSD, volúmenes de contenedor persistidos, listas de IP permitidas y copias de seguridad.
Visión editorial de un paso de SQLite a PostgreSQL
- Exportar: Usa la CLI de n8n para exportar workflows y credenciales de la instancia con SQLite.
- Aprovisionar: Levanta una base de datos PostgreSQL dedicada en una versión mayor soportada.
- Empezar de cero: Arranca una nueva instancia de n8n respaldada por Postgres con la misma clave de cifrado.
- Importar: Importa primero las credenciales y después los workflows.
- Aceptar la pérdida: Cuenta con que el historial de ejecuciones se quedará en la instancia antigua.
Los datos de ejecución son el otro motor de crecimiento. El pruning está activado por defecto y elimina ejecuciones cuando superan EXECUTIONS_DATA_MAX_AGE (336 horas, o 14 días) o EXECUTIONS_DATA_PRUNE_MAX_COUNT (10.000), empezando por las más antiguas, mientras que las ejecuciones anotadas nunca se eliminan. En la base de datos SQLite por defecto, el espacio liberado se reutiliza en lugar de devolverse al sistema de archivos, salvo que actives DB_SQLITE_VACUUM_ON_STARTUP o ejecutes un VACUUM manual. Decide la retención de forma deliberada en lugar de heredar los valores por defecto.
Sources: Choose n8n's database | Deploy | n8n Docs, Prerequisites | Deploy | n8n Docs, Manage execution data | Deploy | n8n Docs, PostgreSQL vs SQLite for n8n: When to switch and how - LumaDock
Una instancia con control de concurrencia, o modo cola
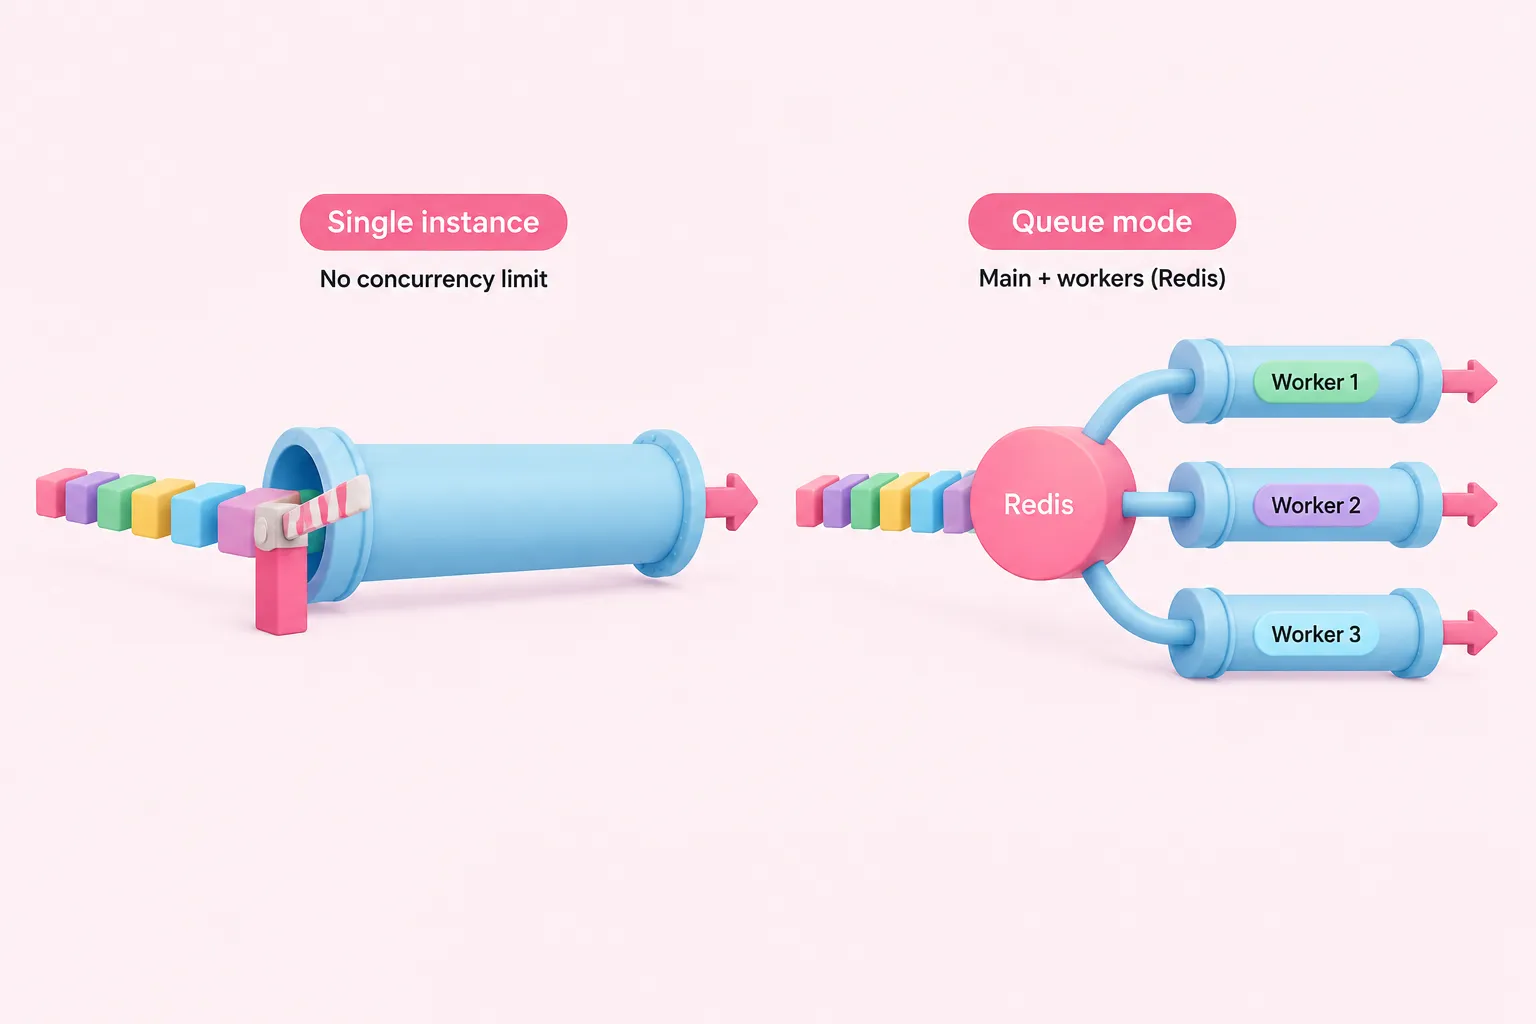
En el modo normal de instancia única, n8n autoalojado no limita cuántas ejecuciones de producción corren de forma concurrente, lo que puede saturar el event loop ante picos. N8N_CONCURRENCY_PRODUCTION_LIMIT encola el exceso en orden FIFO; solo se aplica a ejecuciones iniciadas por webhook o trigger, está desactivado por defecto y las ejecuciones en cola no se pueden reintentar. Configúralo antes de necesitarlo.
Cuando un solo proceso ya no puede mantener el editor con buena respuesta, n8n presenta el modo cola —una instancia principal más instancias worker coordinadas mediante Redis— como su opción que mejor escala, ya que añades o quitas workers según la carga. Es una afirmación arquitectónica de la documentación del proveedor, no un benchmark. El modo cola requiere Redis y una base de datos compartida; ejecutarlo sobre SQLite no está soportado.
| Dimensión | Instancia única | Modo cola |
|---|---|---|
| Límite por defecto | Sin límite de ejecuciones de producción concurrentes | La concurrencia de los workers es 10 por defecto |
| Control | N8N_CONCURRENCY_PRODUCTION_LIMIT, desactivado por defecto | Concurrencia de workers, recomendada 5 o más |
| Base de datos | SQLite o PostgreSQL | Base de datos compartida; SQLite no soportado |
| Servicios adicionales | Ninguno documentado | Redis como broker de mensajes |
| Reintento de ejecuciones en cola | Las ejecuciones en cola no se pueden reintentar | No documentado en estas fuentes |
La concurrencia de los workers es 10 por defecto y n8n recomienda 5 o más, advirtiendo que muchos workers con concurrencia baja pueden agotar el pool de conexiones de la base de datos y provocar retrasos y fallos. Las instancias separadas de procesamiento de webhooks detrás de un balanceador de carga son una capa adicional opcional, y n8n aconseja mantener el proceso principal fuera de ese pool porque la carga alta degrada la edición y el rendimiento de la interfaz.
Las respuestas de webhook grandes merecen atención: en modo cola la respuesta viaja de vuelta a través de Redis bajo N8N_WEBHOOK_RESPONSE_RELAY_SIZE_MAX, con 64 MiB por defecto, y n8n aconseja presupuestar aproximadamente 1,5 veces esa cifra por respuesta en curso. Descargar los cuerpos al almacenamiento está disponible desde n8n 2.34.0 en cada instancia principal y de webhook, necesita almacenamiento que todas las instancias puedan leer, y el modo de sistema de archivos no se recomienda. La alta disponibilidad multi-main es una función Enterprise autoalojada que requiere Postgres, Redis, versiones de n8n coincidentes, N8N_MULTI_MAIN_SETUP_ENABLED y un balanceador de carga con sesiones persistentes, y no está disponible en n8n Cloud.
Sources: Control concurrency | Deploy | n8n Docs, Enable queue mode | Deploy | n8n Docs
Una configuración inicial que puedes monitorizar
Un punto de partida defendible para los requisitos de hardware de n8n: PostgreSQL en una base de datos dedicada, almacenamiento SSD o NVMe con volúmenes persistidos, RAM dimensionada según tu workflow más pesado y no según un número de núcleos, un límite de concurrencia de producción establecido de forma deliberada y una ventana de retención que hayas elegido. Después, observa el uso real de memoria y redimensiona.
- Pasa a PostgreSQL antes de añadir un segundo proceso de n8n.
- Elige una antigüedad y un recuento de retención, y deja de guardar las ejecuciones correctas si solo depuras fallos.
- Establece el límite de concurrencia de producción en la instancia única.
- Cambia al modo cola con Redis y workers con concurrencia 5 o más cuando el editor se ralentice.
- Añade procesadores de webhooks detrás de un balanceador de carga que excluya el proceso principal.
Un detalle más de disponibilidad importa antes de prometer uptime: las ejecuciones que pierden los nodos Cron o Webhook mientras la instancia está caída o reiniciándose no son recuperables, así que los despliegues sensibles al uptime necesitan un proxy con caché delante. Las copias de seguridad, la configuración del proxy inverso y TLS y las herramientas de monitorización quedan fuera de lo que cubren estas fuentes y requieren su propia investigación.
Sources: Prerequisites | Deploy | n8n Docs, PostgreSQL vs SQLite for n8n: When to switch and how - LumaDock, Manage execution data | Deploy | n8n Docs, Control concurrency | Deploy | n8n Docs, Enable queue mode | Deploy | n8n Docs