Checklist de revisión de workflows en n8n: qué comprobar antes de pasar a producción
Checklist de revisión de workflows en n8n para equipos: errores, rutas de fallo, credenciales, nombres, monitorización y aprobación antes de producción.
Comprobado con las fuentes citadas el .
Cómo usar este checklist de revisión de workflows en n8n
Este checklist de revisión de workflows en n8n es para el momento en que un compañero dice que su workflow está listo y te pide que lo revises antes de pasarlo a producción. Cubre cinco áreas: gestión de errores, pruebas de rutas de fallo, credenciales, nombres y monitorización. Termina con un paso de aprobación.
Esta es nuestra regla editorial sobre qué significa «hecho»: una comprobación solo cuenta cuando la has visto tú mismo en el workflow. Que el autor te diga que está hecho no cuenta. Por ejemplo, abre Workflow Settings y mira qué error workflow está seleccionado.
Cada punto de este checklist está etiquetado como dato de funcionalidad de n8n o como convención de equipo. Ninguno es un estándar obligatorio. Solo los puntos sobre el error workflow, Error Trigger y Stop And Error proceden de la documentación oficial de n8n; todo lo demás son consejos de profesionales. Ninguna fuente mide si las revisiones reducen incidentes, así que cualquier beneficio descrito es opinión de los autores. Toma las convenciones como punto de partida que tu equipo puede adaptar.
Sources: Handle errors gracefully | Build | n8n Docs
Gestión de errores y pruebas de rutas de fallo
Empieza por lo que ocurre cuando algo se rompe. Un artículo de Ciphernutz en DEV Community explica que, por defecto, un nodo que falla detiene la ejecución y la marca como error, y nadie recibe aviso salvo que alguien lo haya configurado. Ese fallo silencioso es lo que esta sección intenta evitar.
El dato de funcionalidad: según la documentación de n8n, el error workflow se configura para cada workflow en Workflow Settings. Se ejecuta cuando una ejecución falla y debe empezar con el nodo Error Trigger. La página de la documentación no indica a qué versión o plan se aplica. El nodo documentado Stop And Error fuerza que una ejecución falle bajo las condiciones que elijas, y ese fallo dispara el error workflow. Usarlo para probar la ruta de alertas es sugerencia nuestra, no un método de prueba que describa la documentación.
Forzar un fallo para probar la ruta de alertas
- Añade Stop And Error: Coloca el nodo en una rama de prueba con una condición que controles.
- Ejecuta el workflow: Provoca la condición para que la ejecución falle a propósito.
- Se dispara el error workflow: El workflow vinculado arranca desde su nodo Error Trigger.
- Confirma la alerta: Comprueba que el responsable designado la ha recibido de verdad.
- Elimina la prueba: Quita el fallo forzado antes de pasar a producción.
Las convenciones: el checklist previo a producción de Till Freitag de 2026 incluye confirmar que el error workflow global está vinculado. Ciphernutz recomienda activar Retry on Fail en cada llamada HTTP externa. El checklist de producción de HatchWorks de 2026 aconseja probar las rutas de fallo a propósito con entradas incorrectas, credenciales caducadas y timeouts de API, no solo el camino feliz.
Sources: Handle errors gracefully | Build | n8n Docs, n8n Error Handling Best Practices: Stop Letting Silent Failures Break Your Business - DEV Community, n8n Best Practices Checklist for Production (2026), n8n Best Practices – 10 Rules for… – Till Freitag
Credenciales y nombres
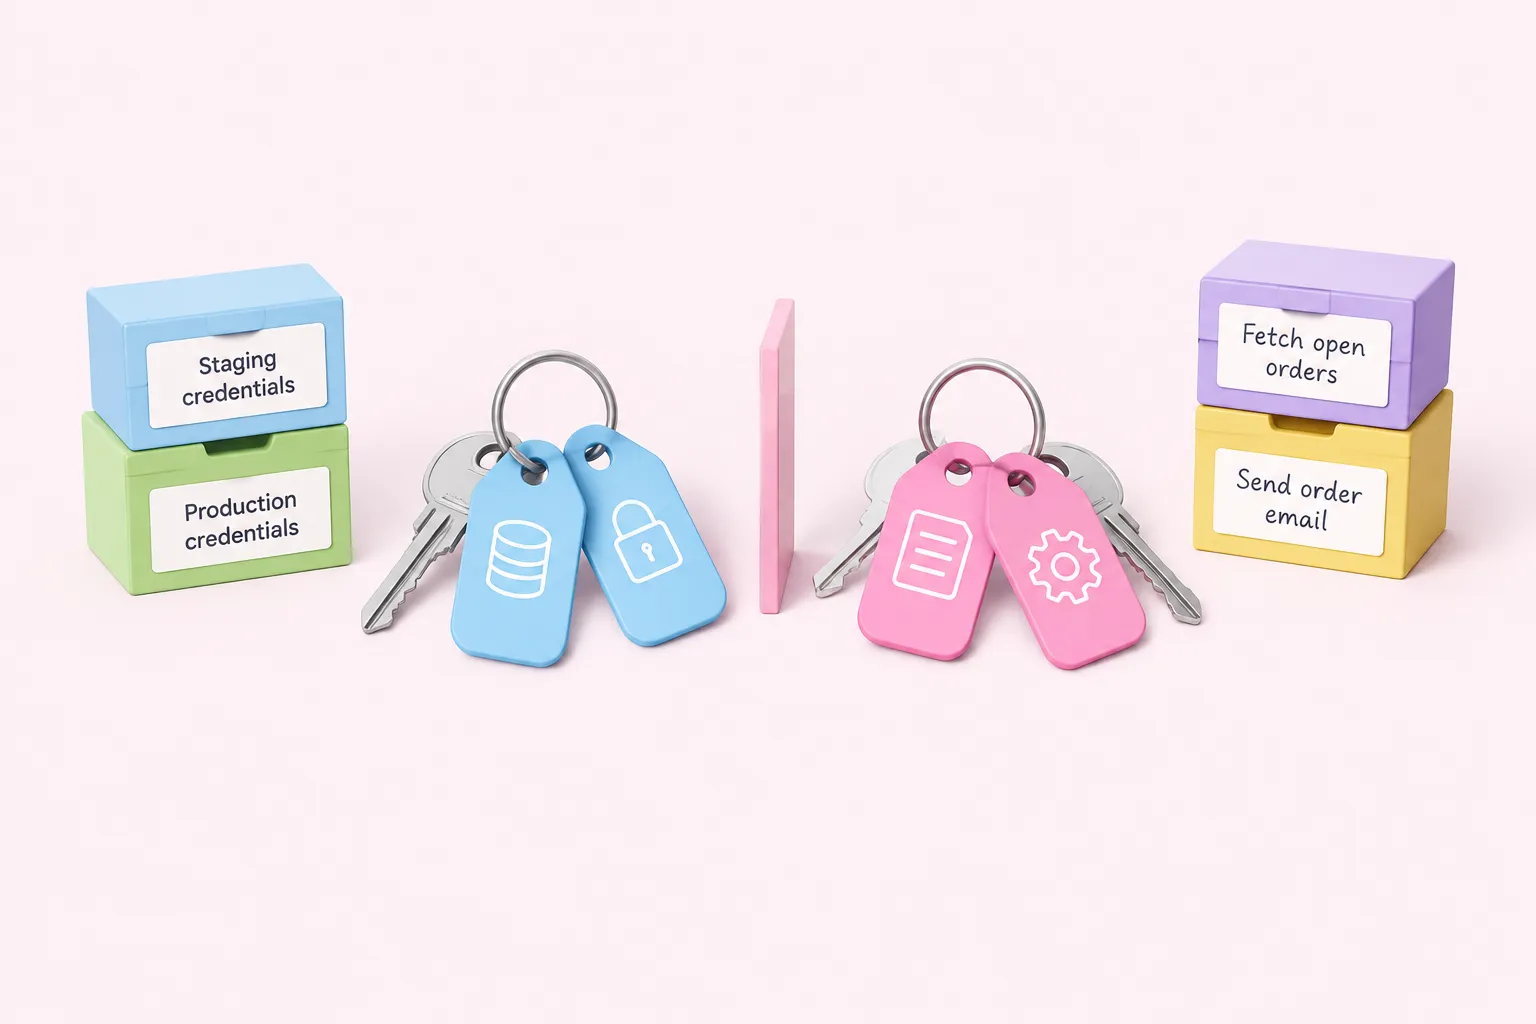
Después, comprueba a qué se conecta el workflow y si la siguiente persona podrá entenderlo. Ambos puntos son convenciones de equipo del artículo de buenas prácticas de Till Freitag de 2026, basado en la experiencia del autor y no en un estudio. n8n no exige ninguno de los dos.
Sobre credenciales, el artículo recomienda mantener separadas las de staging y las de producción. Al revisar, abre cada nodo que use una credencial y comprueba que apunta a la credencial pensada para producción, no a una que alguien usó mientras lo construía.
Sobre nombres, recomienda nombrar los nodos según lo que hacen, no según su tipo. Un ejemplo sugerido: un nodo llamado «Obtener pedidos abiertos» le dice más a un revisor que uno llamado HTTP Request2. Nuestra sugerencia: aplica la misma idea al nombre del workflow para que la lista de workflows siga siendo fácil de recorrer.
| Nombre por defecto | Nombre descriptivo |
|---|---|
| HTTP Request2 | Obtener pedidos abiertos |
| IF | ¿Pedido válido? |
| Edit Fields | Mapear pedido a campos de factura |
Sources: n8n Best Practices – 10 Rules for… – Till Freitag
Monitorización y aprobación
Una alerta solo sirve si alguien se hace cargo de ella. El checklist de HatchWorks de 2026 indica que las alertas de fallo deben ir a un canal concreto con un responsable concreto. Ese checklist cubre además otras prácticas de observabilidad que este artículo no incluye.
Después, cierra el checklist de revisión. Nuestra recomendación editorial es dejar por escrito el resultado y quién es el responsable del workflow, para que la responsabilidad pase con claridad de quien lo construyó a quien lo opera. Los procesos formales de revisión de código, el historial de versiones de n8n, RBAC y SSO quedan fuera del alcance de este checklist.
Sources: n8n Best Practices Checklist for Production (2026)