Almacén vectorial de n8n para RAG en producción: pgvector vs. Qdrant vs. Pinecone
Comparativa de pgvector, Qdrant y Pinecone como almacén vectorial de n8n para RAG en producción: nodos, escalado, filtrado y coste.
Comprobado con las fuentes citadas el .
Qué cambia cuando un flujo de RAG en n8n pasa de prototipo a producción
Elegir el almacén vectorial de n8n adecuado para RAG en producción significa decidir cómo tu flujo de trabajo almacenará y recuperará embeddings una vez que usuarios reales, y no solo una demo de taller, dependan de la respuesta. Un prototipo puede arreglárselas con un índice en memoria que desaparece al reiniciar. La producción no puede: el índice tiene que sobrevivir a los reinicios, contener toda la base de conocimiento y seguir respondiendo consultas mientras se añaden nuevos documentos.
Esto coincide con una limitación indicada en el propio reto Pregúntale a tu Google Drive de n8n Balloon Challenges, donde se describe que el nodo Simple Vector Store solo es adecuado para la demo del taller, no para uso en producción. Creemos que pasar por alto esa advertencia es una de las formas más fáciles en que un flujo de RAG en n8n se rompe silenciosamente en cuanto llega tráfico real.
Almacén vectorial de n8n para RAG en producción: soporte de nodos en pgvector, Qdrant y Pinecone
Dentro de n8n, los tres almacenes no son bloques de construcción idénticos. Según la propia documentación de n8n, el nodo PGVector Vector Store permite que un flujo de trabajo inserte documentos en una tabla vectorial de Postgres, los recupere desde ella, o los obtenga a través de ella, y el mismo nodo puede actuar como un nodo normal, una herramienta para un agente de IA o el recuperador (retriever) detrás de una cadena. La documentación de n8n describe el nodo Qdrant Vector Store de la misma manera: insertar, obtener y recuperar contra una colección de Qdrant, utilizable como nodo normal, herramienta de agente o recuperador.
- Nodo normal: inserta o recupera documentos directamente en un paso del flujo de trabajo
- Herramienta de agente de IA: deja que un agente llame al almacén vectorial como una de sus herramientas
- Recuperador (retriever): suministra automáticamente documentos coincidentes a una cadena o agente
La documentación del nodo de Pinecone añade un modo que los otros dos no documentan: actualizar un registro vectorial existente por su ID, en lugar de solo insertar o recuperar. Si tu diseño de producción depende de actualizaciones in situ de los embeddings, revisa la documentación de cada nodo antes de comprometerte, ya que los tres nodos no exponen los mismos modos.
Sources: PGVector Vector Store | Nodes | n8n Docs, Qdrant Vector Store | Nodes | n8n Docs, Pinecone Vector Store | Nodes | n8n Docs
Escalado y diseño de índices: la sobrecarga operativa de pgvector y Qdrant
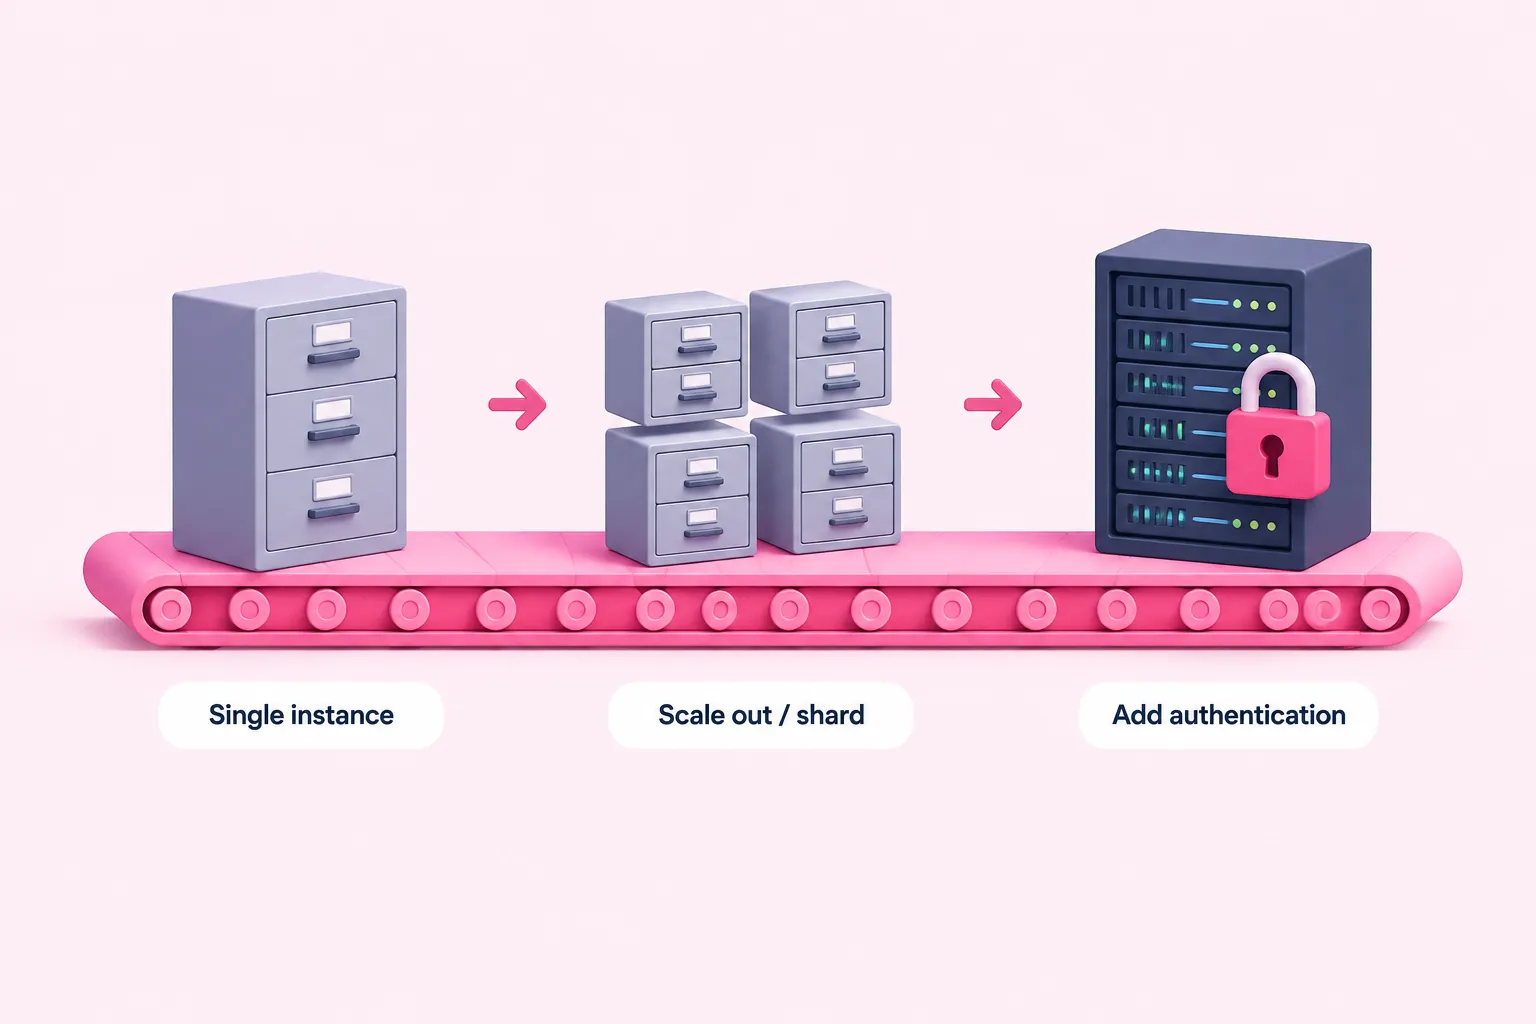
Cuando una sola instancia de Postgres ya no es suficiente, la propia documentación de pgvector orienta a los equipos hacia el escalado horizontal con réplicas de lectura o hacia herramientas de fragmentación (sharding) como Citus o PgDog, en lugar de hacia un modo distribuido integrado. Eso es un proyecto de ingeniería real, no un simple ajuste de configuración.
La propia documentación de producción de Qdrant está organizada en torno a un trabajo preparatorio similar: planificar la multiinquilinato (multitenancy), las cargas masivas y en qué nivel de memoria vive una colección a medida que crece. Su lista de verificación para producción también indica que una instancia de Qdrant autoalojada y de código abierto no tiene autenticación por defecto, por lo que configurar una clave de API es el paso mínimo antes de cualquier despliegue en producción, y señala que las decisiones sobre almacenamiento y dimensionamiento de hardware son difíciles de revertir una vez que un despliegue ya está en marcha.
Sources: GitHub - pgvector/pgvector: Open-source vector similarity search for Postgres · GitHub, Production & Operations - Qdrant, Production Checklist - Qdrant
Las ventajas y desventajas del filtrado de Pinecone y lo que afirman los benchmarks de cada proveedor
Pinecone enmarca su arquitectura de filtrado en torno a una compensación específica: en una explicación de 2023, Pinecone describe el prefiltrado antes de una búsqueda vectorial como preciso pero lento, porque requiere un escaneo exhaustivo de fuerza bruta, lo cual es parte de la razón por la que Pinecone integró el filtrado por metadatos directamente en su motor serverless. En el propio artículo de investigación de Pinecone presentado en ICML 2025 sobre ese diseño serverless, los ingenieros de Pinecone reportan un Recall@10 medio de 0,989 en el benchmark de ANN filtrado YFCC, manteniéndose consistente en un amplio rango de selectividad de filtros.
Qdrant hace una afirmación propia paralela: según el benchmark propio de Qdrant, actualizado en enero y junio de 2024, Qdrant reporta el mayor número de solicitudes por segundo y la menor latencia en casi todos los escenarios probados, incluida una ganancia de 4 veces en RPS en un conjunto de datos. La propia página de benchmark de Qdrant reconoce con franqueza que sus autores conocen mejor su propio producto y podrían no haber ajustado los motores de la competencia con el mismo cuidado.
Nuestra opinión es que un benchmark realizado por un proveedor es útil para reducir una lista de candidatos, no para zanjar la decisión: trata estas cifras como un punto de partida y luego verifica el filtrado por metadatos y el recall con tus propios documentos antes de decidir.
Sources: Vector Search Benchmarks - Qdrant, https://www.pinecone.io/research/ICML_2025.pdf, The Missing WHERE Clause in Vector Search
Diferencias en el modelo de coste y precios
La mecánica de precios difiere tanto como la tecnología. La documentación de Pinecone establece límites fijos de operación que no cambian según el plan, como topes de tasa de solicitudes y un máximo de 1.000 registros (hasta 2 MB) por lote de upsert, con un límite de 10.000 para top_k en las consultas, límites en torno a los cuales un flujo de ingesta de n8n debe diseñarse desde el principio. La propia documentación de costes de Pinecone describe su facturación serverless como totalmente basada en el uso, cobrando solo por los datos almacenados y las operaciones ejecutadas, sin coste alguno para un índice inactivo.
Qdrant Cloud factura de otra manera: precios basados en recursos vinculados a vCPU, RAM y disco, de modo que un clúster más grande cuesta más, facturado mensualmente a mes vencido por el uso del mes anterior. Qdrant autoalojado y de código abierto no conlleva ningún coste facturado por Qdrant, pero entonces tu propia factura de infraestructura ocupa su lugar.
Sources: Pinecone Database limits overview - Pinecone Docs, Operation limits - Pinecone Docs, Understanding Pinecone cost - Pinecone Docs, Pricing for Cloud and Vector Database Solutions Qdrant, Billing & Payments - Qdrant
Guía de decisión: cómo ajustar el almacén a las restricciones de tu equipo
No existe un único mejor almacén vectorial de n8n para RAG en producción que sirva para todos los equipos; la elección correcta depende más de tus restricciones que de cualquier cifra de un benchmark.
| Criterio | pgvector | Qdrant | Pinecone |
|---|---|---|---|
| Modelo de alojamiento | Autoalojado dentro de Postgres | Autoalojado o Qdrant Cloud | Totalmente gestionado (serverless) |
| Enfoque de escalado | Réplicas o fragmentación vía Citus/PgDog | Planificación de multiinquilinato y niveles de memoria | Gestionado por Pinecone, basado en uso |
| Modos de nodo en n8n | Insertar, obtener, recuperar, herramienta de agente, recuperador | Insertar, obtener, recuperar, herramienta de agente, recuperador | Insertar, obtener, recuperar, actualizar por ID, herramienta de agente, recuperador |
| Seguridad por defecto (autoalojado) | Desconocido | Sin autenticación por defecto; se requiere clave de API | No aplica (gestionado) |
| Modelo de precios | Solo coste de infraestructura | Basado en recursos, facturado mensualmente a mes vencido | Basado en uso, se paga por datos almacenados y operaciones |
| Límites fijos de operación | No documentado en las fuentes proporcionadas | No documentado en las fuentes proporcionadas | Tope de lote de 1.000 registros, top_k máximo de 10.000 |
Las recomendaciones siguientes resumen cómo se alinean las compensaciones documentadas con algunas situaciones habituales de los equipos.
En general, nos inclinamos por empezar un flujo de RAG en n8n con pgvector cuando el equipo ya utiliza Postgres, ya que evita montar un sistema completamente nuevo antes de que nadie haya demostrado que realmente es necesario; pasa a Qdrant o Pinecone una vez que un límite concreto de escalado o filtrado, y no una corazonada, obligue a plantearlo.
Elijas el almacén que elijas, estandarizar esta decisión del almacén vectorial de n8n para RAG en producción en todo el equipo, en lugar de dejar que cada flujo de trabajo elija de manera improvisada, es lo que mantiene sencilla una futura auditoría.
Sources: PGVector Vector Store | Nodes | n8n Docs, Qdrant Vector Store | Nodes | n8n Docs, Pinecone Vector Store | Nodes | n8n Docs, GitHub - pgvector/pgvector: Open-source vector similarity search for Postgres · GitHub, Production & Operations - Qdrant, Production Checklist - Qdrant, Pinecone Database limits overview - Pinecone Docs, Operation limits - Pinecone Docs, Understanding Pinecone cost - Pinecone Docs, Pricing for Cloud and Vector Database Solutions Qdrant, Billing & Payments - Qdrant